
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
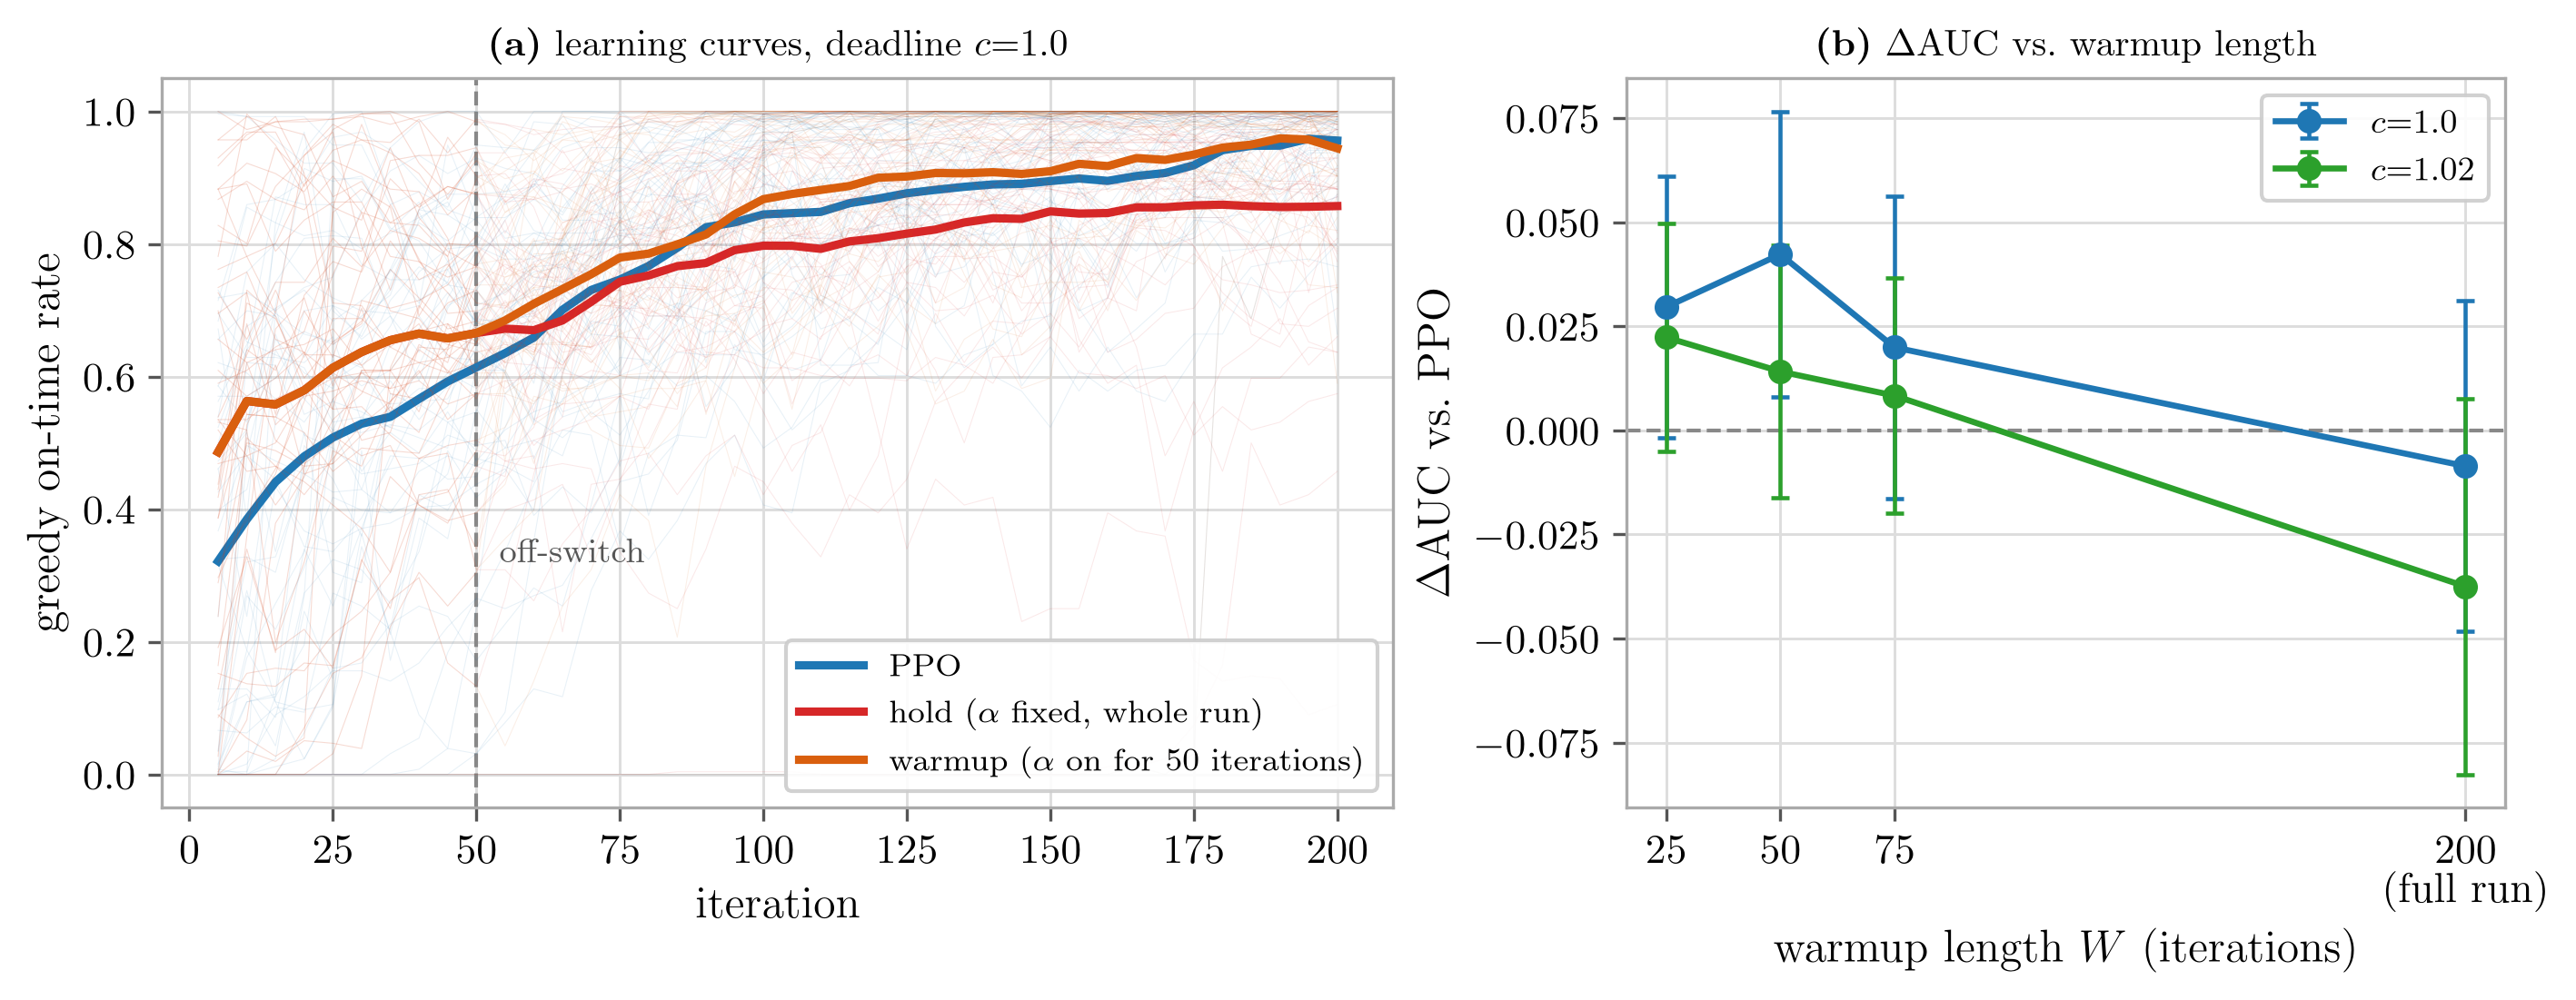
Батчи PPO удалось агрессивнее переиспользовать в задачах, где текущее состояние однозначно задаёт весь путь к нему. В препринте Nima H. Siboni, который не прошёл рецензирование и приводит замеры автора, поправка дала от 0,02 до 0,09 к площади под кривой обучения — накопленному результату по ходу обучения. Для обучения LLM и конструктивных оптимизаторов это способ ускорить ранние обновления, но не постоянная замена обычному PPO.
PPO учитывает, насколько новая политика изменила вероятность текущего действия, но отбрасывает изменение вероятности всего предшествующего пути. Если разные пути не сходятся в одном состоянии, нужную поправку можно точно получить как произведение отношений вероятностей действий вдоль префикса. Авторегрессионная генерация удовлетворяет этому условию: каждый набор предыдущих токенов образует отдельное состояние.
Для расчёта хватает логарифмов вероятностей, которые PPO уже хранит. Дополнительные прямые и обратные проходы модели не нужны: добавляется накопительная сумма по префиксу. Однако полное перевзвешивание повышает разброс градиентов, причём проблема усиливается на длинных последовательностях.
Поправку поэтому сделали регулируемой. При α=0 алгоритм совпадает с PPO, а при α=1 полностью учитывает префикс; промежуточные значения позволяют обменивать систематическую ошибку на разброс. Польза проявилась, когда награда определялась поздно, зависела от ранних действий, а многократные обновления успевали заметно увести политику от той, которая собрала батч.
Метод проверяли на небольшой модели последовательностей с полностью перебираемыми исходами, предобученной модели на полмиллиарда параметров и задачах составления расписаний. На сложных задачах короткий разогрев с поправкой опередил PPO и такое же переиспользование батча без поправки. Если сохранять её на всём протяжении обучения или применять там, где встроенное ограничение PPO уже сдерживает смещение, результат оставался прежним либо ухудшался.
Источники
Иллюстрация: рисунок из статьи «Free Everywhere, Exact on Trees: PPO's Dropped Correction Buys Sample Efficiency Under Aggressive Reuse», Nima H. Siboni, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


