
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
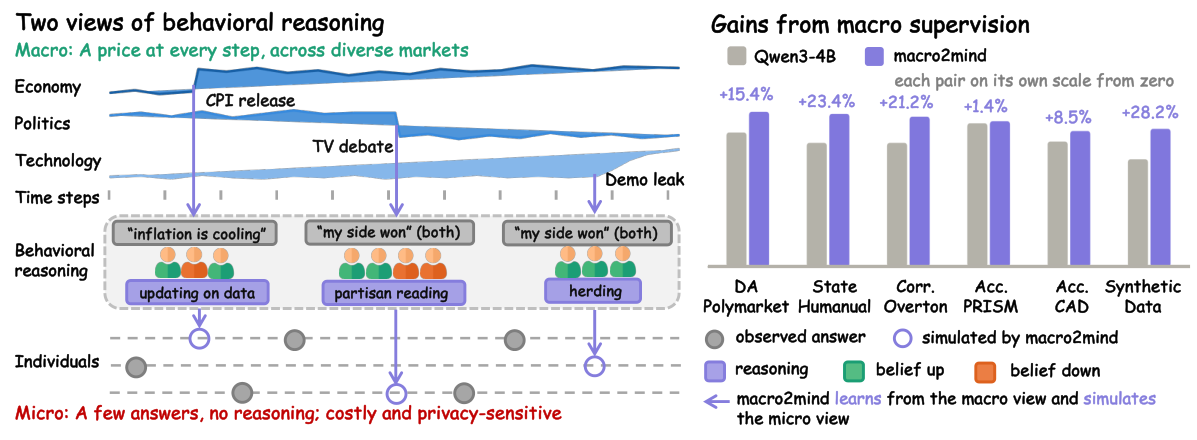
LLM научили моделировать поведение отдельных пользователей, обучая её только на совокупных реакциях участников рынков прогнозов. В препринте University of Illinois Urbana-Champaign и независимого исследователя, который не прошёл рецензирование и содержит замеры самих авторов, macro2mind превзошла обычное обучение на рыночных данных и стала более полезным генератором примеров, чем базовая Qwen3-4B. Это предлагает дополнительный источник обучения для случаев, когда подробные истории реальных пользователей собирать дорого или нельзя из-за требований к приватности.
Почему движение цены похоже на запись коллективного решения
Цена на рынке прогнозов отражает совокупную оценку вероятности события. Когда выходит новость, разные группы участников интерпретируют её с учётом своих интересов и прежних убеждений, реагируют друг на друга и заключают сделки. Следующее движение цены фиксирует итог этих реакций, хотя не раскрывает решения конкретных людей.
macro2mind получает вопрос рынка, недавнюю историю цены и текстовые описания событий. Модель должна предсказать следующую цену. Правильный ответ известен из фактического движения рынка, поэтому для обучения не нужны размеченные объяснения того, как рассуждала каждая группа.
Одной числовой цели недостаточно: модель может подобрать поверхностную зависимость и не научиться переносить результат на отдельного пользователя. Поэтому авторы заставляют её сначала восстановить скрытую социальную структуру, а уже затем дать прогноз.
Модель выделяет группы, которые могли повлиять на рынок, и описывает их цели, убеждения и исходные позиции. Затем она прогнозирует непосредственную реакцию каждой группы на событие. Последний шаг учитывает, как участники реагируют на действия других, и сводит эти изменения к общей цене.
Вся цепочка создаётся одной LLM, а не системой из множества агентов. Это сокращает вычисления и связывает промежуточные рассуждения с одним проверяемым результатом. При переносе на симуляцию пользователя место предполагаемой группы занимает профиль человека и история его действий.
Как программа обучения отбирает полезные изменения рынка
Рыночные переходы различаются по ценности для обучения. В одних цена почти не меняется, другие зависят от шума, а третьи требуют понять, какие участники заметили событие и как изменили позиции. Равномерное обучение тратило бы одинаковые ресурсы на все эти случаи.
macro2mind обучают с помощью GRPO — метода, который генерирует группу ответов, сравнивает их по награде и усиливает более удачные варианты. Наградой служит близость прогноза к следующей наблюдаемой цене. Перед этим модель проходит короткое обучение на примерах с заданной структурой рассуждения, чтобы освоить формат.
Главное отличие метода — учебная программа на основе ошибки, видимой задним числом. Для каждого кандидата модель, уже зная фактический исход, называет группы, которые двигали рынок. Затем система сравнивает прогнозы без этой подсказки и с ней. Если знание групп заметно улучшает ответ, переход считают содержательным: модель могла бы решить его лучше, если бы верно восстановила участников и их мотивы.
Второй фильтр учитывает текущую сложность примера. Случаи, где все варианты ответа одинаково успешны или одинаково ошибочны, дают GRPO мало сигнала. Поэтому обучение чаще выбирает переходы, на которых ответы различаются по качеству и модель ещё способна улучшиться.
Эти механизмы решают разные задачи. Разложение задаёт форму рассуждения, а учебная программа выбирает события, на которых эта форма чему-то учит. В проверке компонентов одна структура без такого отбора не улучшила перенос на пользователей; рост появился после добавления обоих фильтров.
Когда подход меняет планы разработки симулятора
Метод проверяли на Qwen3-4B, обученной на переходах из SWM-Bench. Рыночный прогноз оценивали на Polymarket и Kalshi, а перенос на людей — на Humanual, OvertonBench, PRISM и CAD. В сравнение вошли базовая модель, обычная GRPO-настройка, методы с подсказками, специализированные симуляторы и персонализированные модели оценки.
На Polymarket macro2mind получила точность направления движения 0,674 и корреляцию прогноза с фактической ценой 0,362, опередив рассмотренные альтернативы по обеим метрикам. На пользовательских наборах она без дополнительного обучения показала конкурентный результат, но не стала лучшей по каждой задаче.
Практически важнее эксперимент с синтетическими данными. Симулятор, обученный на ответах macro2mind, повысил точность на ранее не встречавшихся пользователях с 44,5% до 60,0%. При том же конвейере данные обычной Qwen3-4B дали результат на 13,2 процентного пункта ниже.
Для команды это меняет план, если пользовательских историй мало, но доступен поток агрегированных решений с проверяемым исходом. Рыночное обучение можно поставить перед настройкой на собственных данных или использовать macro2mind как генератор дополнительных примеров. Особенно уместен такой этап там, где нужно предсказывать изменение мнения после новости, чужого сообщения или реакции группы.
Заменять реальные пользовательские проверки рыночными сигналами работа не предлагает. Одинаковый совокупный результат могут породить разные мотивы, поэтому точный прогноз цены сам по себе не доказывает точность модели конкретного человека. Эксперименты подтверждают перенос в перечисленных тестах и масштабе Qwen3-4B; для продукта всё равно потребуется проверка на собственных профилях, сценариях и действиях.
Источники
Иллюстрация: рисунок из статьи «Learning to Simulate Individuals from Macro Social Signals», Yining Zhao, Bushi Liu, Haofei Yu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


