
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Генерацию колонок удалось ускорить без ослабления гарантии оптимальности линейной задачи. В препринте KU Leuven, TU Delft и Cornell Tech, который не прошёл рецензирование и содержит замеры самих авторов, новый метод оказался быстрее стандартной генерации колонок и прежних способов стабилизации. Для внедрения машинного обучения не нужно отдавать модели право принимать окончательное решение: её прогноз остаётся подсказкой, которую проверяет точный алгоритм.
Почему сглаживание по прошлым значениям ведёт поиск назад
Генерация колонок решает линейные задачи, в которых полный набор переменных слишком велик для явного перечисления. Алгоритм начинает с ограниченной главной задачи, куда входит только часть переменных, а затем запускает ценовую подзадачу и ищет новую колонку, способную улучшить решение.
Поиск направляют двойственные оценки ограничений — их можно понимать как текущую цену нехватки ресурса. Для каждой найденной колонки алгоритм вычисляет приведённую стоимость. Если она отрицательна, добавление колонки может улучшить целевую функцию.
Проблема в том, что двойственные оценки зависят от уже добавленных колонок. После очередного обновления главной задачи они могут резко измениться, поэтому ценовая подзадача ищет переменные, полезные лишь на текущем шаге. Главная задача растёт, а сходимость замедляется.
Классическое сглаживание смешивает текущие двойственные оценки с оценками прошлых итераций. Оно уменьшает колебания, но сохраняет в поисковом сигнале уже закрытые потребности. Колонка, которая была полезна раньше, не обязательно останется полезной после следующих обновлений.
Как прогноз встроили без потери корректности
Предсказательное сглаживание двойственных оценок (predictive dual smoothing) заменяет исторический ориентир прогнозом будущего состояния. Модель получает признаки текущей главной задачи, ценовой подзадачи и хода алгоритма, а затем отдельно предсказывает будущую двойственную оценку для каждого ограничения. Один общий предиктор можно применять к задачам с разным числом ограничений.
Модель обучают заранее на обычных траекториях генерации колонок. Состояние алгоритма сопоставляют с двойственными оценками, которые он фактически получил несколькими обновлениями позже. Одна записанная траектория даёт много обучающих примеров, а тот же набор можно повторно использовать при выборе другой дальности прогноза.
Во время решения текущие оценки смешивают с предсказанными и передают получившийся вектор ценовой подзадаче. Прогноз не выбирает колонку напрямую и не меняет главную задачу. Он только сдвигает поисковый приоритет к переменным, которые должны сохранить ценность на следующих итерациях.
Каждую предложенную колонку алгоритм проверяет по настоящим текущим оценкам. Если приведённая стоимость не отрицательна, запускается обычная ценовая подзадача без сглаживания. Она либо находит допустимое улучшение, либо подтверждает, что улучшений больше нет и линейная задача решена оптимально.
После неудачного прогноза влияние модели уменьшается. Благодаря этому метод постепенно возвращается к стандартному поиску по мере приближения к решению, когда будущие двойственные оценки труднее использовать как ориентир. Машинное обучение меняет порядок появления колонок, но не может добавить бесполезную колонку или преждевременно остановить алгоритм.
Когда результат меняет план разработки решателя
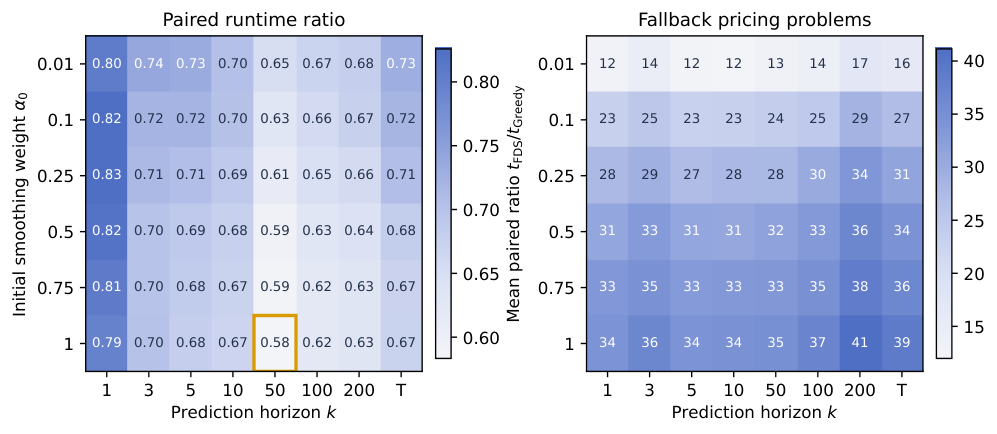
На задаче раскроя предсказательное сглаживание сократило среднее парное время решения на 37% относительно стандартной генерации колонок и добавило на 27% меньше колонок. Оно также обошло Neame smoothing, Du Merle stabilization и обучаемый метод Kraul et al., который прогнозирует конечные двойственные оценки.
В обобщённой задаче о назначениях метод применяли поверх Du Merle stabilization — сильной классической стабилизации главной задачи. Дополнительный прогноз сократил время ещё примерно на 47%, а число колонок — на 22%. Это показывает, что подход не только подавляет колебания, но и направляет поиск к будущим потребностям задачи.
Эксперименты охватывают раскрой и назначение работ машинам. Авторы отдельно проверили перенос на более крупные и более мелкие экземпляры раскроя: на крупных задачах преимущество сохранилось, а на меньших Neame smoothing оказался быстрее. Значит, дальность прогноза нельзя без проверки переносить между масштабами — на короткой траектории тот же горизонт фактически превращается в прогноз конечного состояния.
Работа меняет план команд, которые уже используют генерацию колонок для повторяющихся задач одного класса. Вместо замены решателя можно добавить обучаемый ориентир вокруг существующей ценовой подзадачи, сохранить точную проверку и сравнить выигрыш на собственных траекториях. Для разовых задач подготовка обучающих запусков вряд ли оправдана.
Проверяли решение линейных релаксаций. Перенос на branch-and-price, где генерация колонок многократно работает внутри дерева ветвления, авторы оставляют следующим этапом. Поэтому ускорение полного целочисленного решателя пока нельзя считать установленным.
Источники
Иллюстрация: рисунок из статьи «Predictive Dual Smoothing for Column Generation», Senne Berden, Noah Schutte, Andrea Lodi и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


