
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
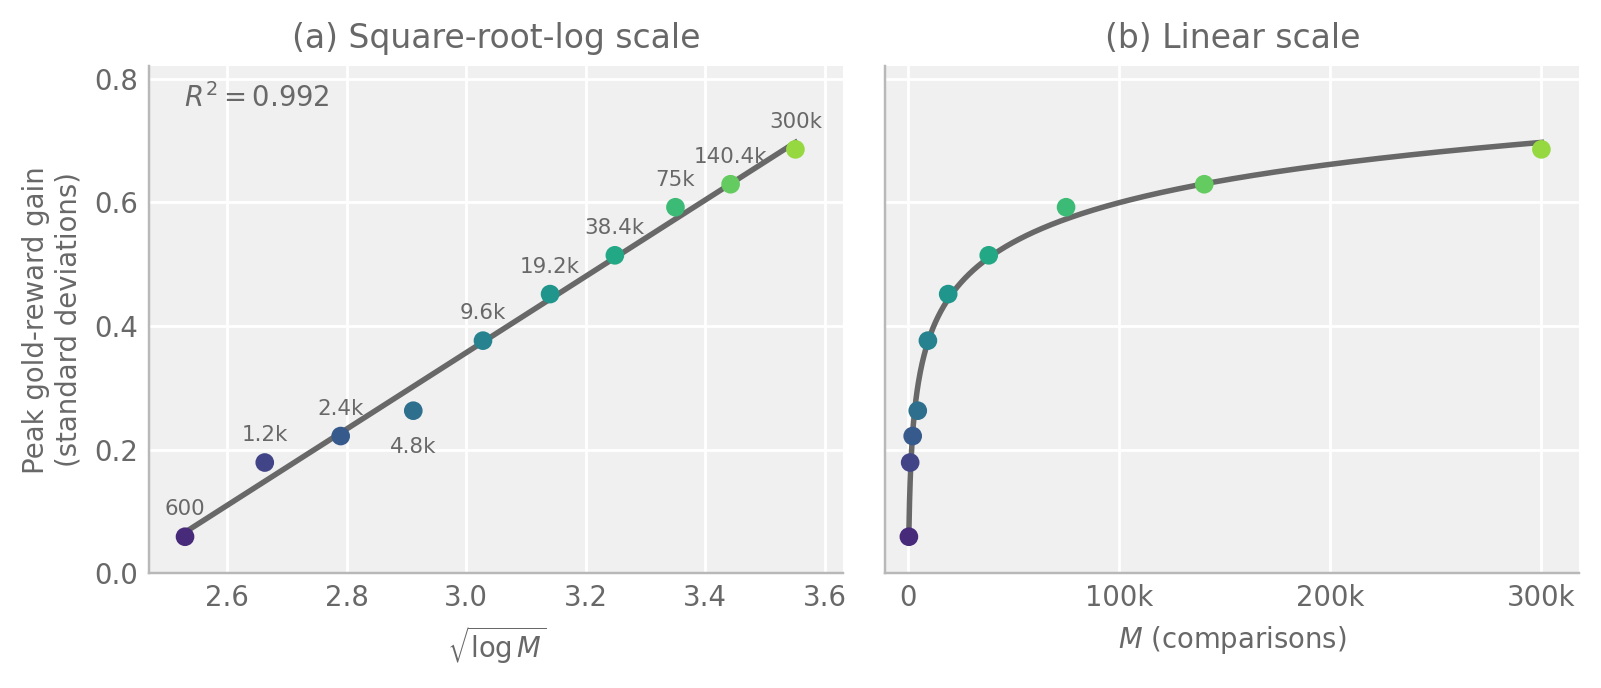
Оптимизацию LLM по модели награды нельзя без пользы усиливать быстрее, чем растёт объём данных о предпочтениях. В препринте MIT, который не рецензирован и приводит замеры самих авторов, найденная зависимость описала 99,2% разброса результата в основном эксперименте. Она даёт ориентир для выбора бюджета постобучения до запуска дорогих прогонов.
Ali Aouad, Aymane El Gadarri и Vivek F. Farias связали прирост истинной награды с двумя величинами: числом парных сравнений M и бюджетом отклонения K. Последний задаёт допустимое KL-расхождение обученной политики с исходной. Прирост подчиняется закону Θ(√min{log M, K}): сначала его ограничивает сила оптимизации, затем — количество сведений о предпочтениях.
Из закона следует практическая граница: бюджет отклонения стоит увеличивать примерно как логарифм числа сравнений. Если K растёт медленнее, часть доступного улучшения остаётся неиспользованной. Если быстрее, модель сильнее подстраивается под ошибки приближённой модели награды, а истинная награда выходит на плато или начинает снижаться.
Зависимость проверили с Llama-3.3-Nemotron-70B-Reward в роли эталонной модели награды и моделями Qwen3 размером от 0,6B до 4B параметров в роли приближённых. Объём обучающих данных меняли от 600 до 300 000 сравнений. Результат сохранялся при шумных метках и двух способах оптимизации: выборе лучшего ответа из набора и экспоненциальном перевзвешивании ответов.
Эксперимент охватывает синтетические предпочтения от модели, 128 тестовых запросов и выбор среди заранее сгенерированных ответов. Поэтому закон уже подходит как ориентир для расчёта сравнений и силы оптимизации, но работа не проверяет его на человеческих оценках и полноценном обучении политики.
Источники
Иллюстрация: рисунок из статьи «Revisiting scaling laws for reward optimization», Ali Aouad, Aymane El Gadarri, Vivek F. Farias, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


