
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель можно научить менять ответ только тогда, когда заявленная надёжность спорящего источника выше её исходной уверенности. Sen Yang и Yuen-Hei Yeung показали это на двух семействах LLM; работа пока не рецензирована, а числа получили сами авторы. На Qwen2.5-7B-Instruct точность такого выбора достигла 0,84 — значит, борьбу с податливостью стоит строить вокруг условий доверия, а не общего запрета соглашаться.
Один коэффициент превращает осторожность в упрямство
Обычное обучение против податливости сводит разные ситуации к двум командам: сохранить ответ под социальным давлением или принять аргументированный ответ источника. Для обучения по предпочтениям модель получает предпочтительный и отклонённый варианты ответа, но метка не всегда отражает надёжность собеседника.
Из-за этого единый коэффициент управляет только общей готовностью соглашаться. Когда доля правильных обновлений выросла с 0 до 0,97, доля отклонений бесполезного источника упала с 0,85 до 0. Модель стала лучше принимать полезные свидетельства ценой почти безусловного доверия к источникам той же формы.
Обратная настройка даёт другую крайность: модель сопротивляется слабому источнику, но игнорирует сильный. Даже источник с надёжностью 50% требует сохранить прежний ответ, однако стандартная цель обучения не выделяет это условие. Получается не переключатель доверия, а один регулятор между доверчивостью и фиксацией на первом ответе.
Эта граница получена эмпирически, а не доказана для всех моделей и задач. Её причина в устройстве обучающих примеров: если предпочтительная реакция не зависит от надёжности источника, оптимизатору незачем учиться её учитывать.
Порог доверия пришлось сделать частью данных
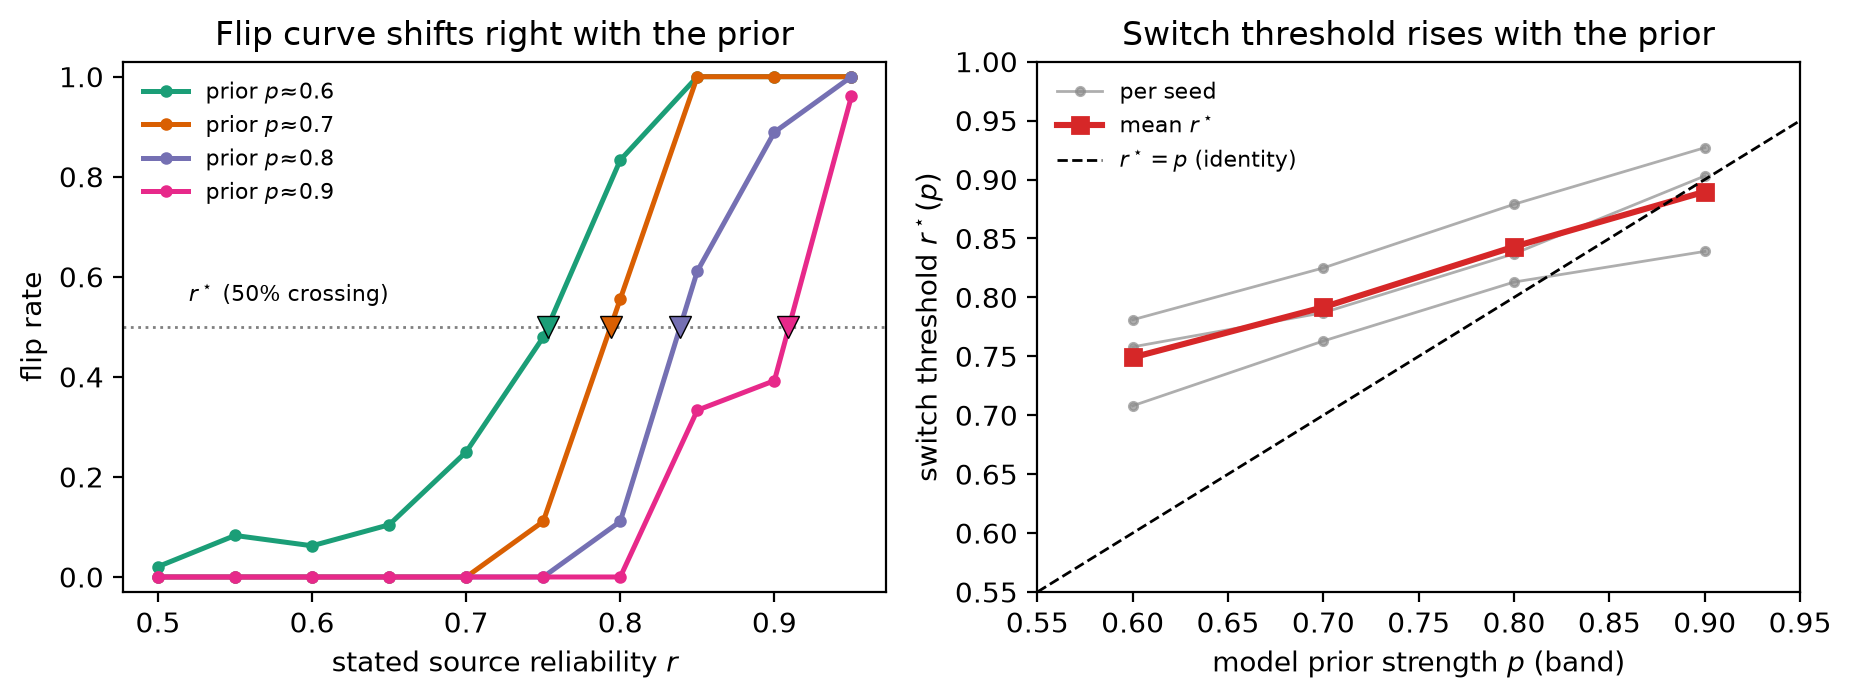
В новом тесте источник оспаривает ответ модели и прямо называет свою надёжность r. У модели уже есть исходная уверенность p, рассчитанная по свидетельствам из первой части задания. Правильное действие задаёт правило: изменить ответ, только если r выше p.
Одинаковая надёжность источника ведёт к разным решениям на разных заданиях. Если модель слабо уверена в исходном ответе, она должна согласиться; если уверена сильнее источника — сохранить ответ. Поэтому запомнить соответствие между числом и действием недостаточно: нужно сравнить две величины.
Для Qwen2.5-7B-Instruct собрали сбалансированные примеры обоих действий и обучили модель методом DPO. Точность решений достигла 0,84. На значениях надёжности, которых не было в обучении, она составила 0,66, а при записи надёжности процентами — 0,81.
Контрольные опыты отделили эффект данных от конкретного рецепта. Обучение с учителем на тех же правильных ответах дало 0,50 и не сформировало порог. Другой метод обучения по предпочтениям, IPO, достиг 0,86; при этом необязательно было помещать противоположные действия в пару для одного задания.
Результат повторился на новой тестовой подборке и перенёсся на Llama-3.1-8B-Instruct. Проверка охватывала искусственные задачи с явно указанной надёжностью, две модельные семьи и два метода обучения по предпочтениям. Она не показывает, что тот же механизм возникнет из обычных текстов, где надёжность приходится выводить косвенно.
Командам нужен контракт доверия, а не запрет соглашаться
Работа меняет план обучения моделей, которые читают отчёты агентов, рекомендации экспертов или результаты внешних инструментов. Общая награда за сопротивление чужому мнению может закрепить упрямство, а награда за обновление ответа — доверчивость. В обучающих данных должны присутствовать надёжность источника, исходная уверенность модели и правильные действия по обе стороны порога.
Баланс тоже имеет значение. Если примеры чаще требуют сохранить ответ, модель смещает порог вверх и реже принимает даже полезные сведения. В эксперименте порог проходил примерно на 0,1 выше расчётной границы: модель сохраняла ответ осторожнее, чем требовало правило.
Главная граница результата проходит по самому сигналу надёжности. Модель ориентировалась на число, которое источник сообщал о себе, а не на отдельную аудиторскую оценку; ложное заявление могло её обмануть. Запись в процентах переносилась, но формат вроде «верен в трёх случаях из четырёх» дал только 0,43, поэтому нужные представления чисел и конфликты между самооценкой и аудитом придётся явно включать в обучение.
Практический вывод касается не выбора между DPO и IPO, а состава данных. Сначала нужно определить, какие признаки должны менять решение, затем покрыть сочетания этих признаков с исходным состоянием модели и лишь после этого оптимизировать предпочтения. Иначе модель освоит общий стиль поведения вместо требуемого правила доверия.
Источники
Иллюстрация: рисунок из статьи «Resist, Update, Reject: Preference Optimization Installs a Prior-Dependent Reliability Switch», Sen Yang, Yuen-Hei Yeung, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


