
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
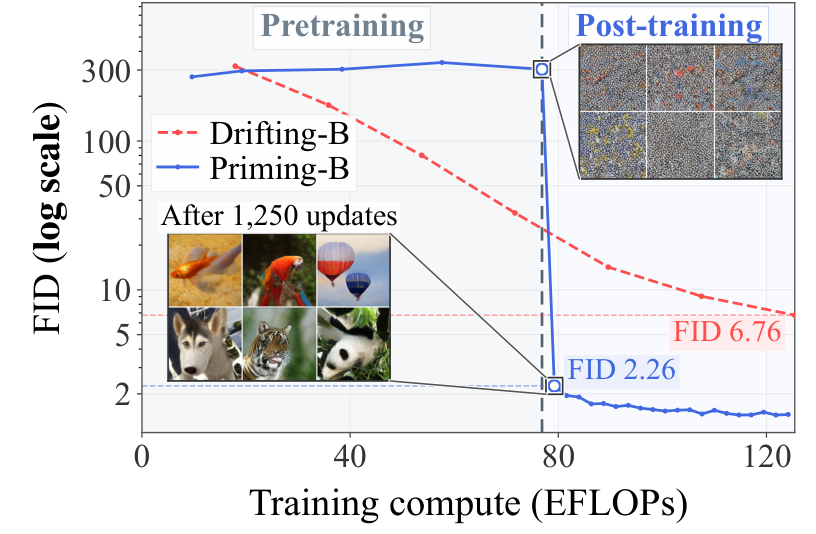
Одношаговый генератор научили создавать изображение за единственный проход сети без предварительно обученного диффузионного учителя. На ImageNet команда Seoul National University и Harvard University получила FID 1,19 при примерно в десять раз меньших вычислениях, чем Drifting; FID измеряет расстояние между распределениями признаков реальных и созданных изображений и должен снижаться, хотя препринт не рецензирован и числа получили сами авторы. Для команд это открывает более короткий путь к генератору с дешёвым выводом: сначала научить сеть реконструкции, затем напрямую подогнать распределение результатов.
Реконструкция готовит сеть к генерации из шума
Priming Models обучает одну и ту же сеть в два этапа. Сначала ей дают настоящее изображение, смешанное с шумом, и требуют восстановить оригинал. В основной конфигурации уровень шума фиксируют на 0,8: вход уже близок к случайному шуму, но всё ещё сохраняет достаточно сведений о целевом изображении.
Такое предварительное обучение не создаёт хороший одношаговый генератор само по себе. Оно учит сеть структуре естественных изображений: расположению объектов, границам, текстурам и другим связям, которые трудно открыть, если начинать сразу со случайного шума.
На втором этапе сеть получает чистый гауссов шум и сразу выдаёт изображение. Замороженные кодировщики переводят созданные и настоящие изображения в пространство признаков, где алгоритм оптимального транспорта сближает их распределения. Дополнительный отталкивающий член не позволяет созданным примерам собраться вокруг нескольких похожих вариантов.
В этой схеме нет заданной диффузионной траектории, учителя для дистилляции и отдельного вектора стиля. Предварительное обучение и финальная подгонка меняют параметры одной сети, поэтому после обучения генерация требует только одного её запуска.
Начальная точка меняет реакцию параметров на ошибку
Главный результат работы касается не качества первых изображений после реконструкции, а управляемости сети. При прямом обучении распределения функция потерь может верно указывать, как следует изменить созданное изображение, но обновление параметров не обязательно сдвинет результат в нужную сторону.
Авторы проверили это через якобиан — матрицу, которая связывает малое изменение параметров с изменением признаков результата. После реконструкции сеть сильнее реагировала именно на те направления, в которых распределительная функция потерь предлагала исправлять изображения. Чем лучше совпадали эти направления, тем быстрее снижался FID при последующем обучении.
Метод проверяли на трёх визуальных задачах: генерации классов ImageNet, создании изображений по тексту и предсказании кадров в моделях мира. Самый подробный эксперимент использовал ImageNet с разрешением 256 × 256, две величины сети и несколько длительностей предварительного обучения; среди сравнений были Drifting, MeanFlow, W-Flow и многошаговая диффузионная модель JiT.
Отдельные проверки показывают, что простой рецепт всё же требует аккуратной настройки. Удаление функции потерь в пространстве визуальных признаков ухудшило FID с 1,38 до 2,07. Предварительное обучение на чистом шуме дало FID 65,08: сети нужен вход, который одновременно похож на будущий шум и сохраняет сведения об исходном изображении.
Оптимальный транспорт оказался лучшим из проверенных способов финальной подгонки по FID, но схема работала и с попарным расстоянием, и с лапласовским ядром. Значит, основной вклад даёт не конкретная распределительная функция потерь, а подготовленная реконструкцией начальная точка.
Когда Priming Models меняет план разработки
Работа меняет порядок экспериментов для команды, которая обучает собственный генератор и хочет сократить число запусков сети при выводе. До построения сложной дистилляции или специальной траектории имеет смысл проверить реконструкцию с сильным шумом, а затем добавить распределительную подгонку в пространстве признаков. Это отдельная ветка прототипа, а не новая архитектура всей системы.
Экономия относится к вычислениям на обучение в сравнении с рассмотренными одношаговыми методами. Для вывода преимущество следует из одного запуска сети, но работа не переводит его в задержку на конкретных GPU или стоимость запроса. Эти показатели придётся измерять на целевой архитектуре и размере пакета.
Заменять многошаговый диффузионный стек только по этому препринту рано. Priming Models всё ещё опирается на заранее обученные кодировщики признаков, а разрыв с многошаговыми моделями закрыт не во всех проверенных задачах. Практический вывод уже уже: сложность прямого распределительного обучения можно вынести в простой подготовительный этап, не начиная с готовой диффузионной модели.
Источники
Иллюстрация: рисунок из статьи «Are We Overthinking One-Step Generation?», Woobin Park, Jaeyeon Kim, Yilun Du и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


