
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Декодирование LLM с длинным контекстом удалось ускорить без заметной потери точности на проверенных задачах. В препринте Soochow University и Baidu, который не прошёл рецензирование, а все числа получили сами авторы, Prism Attention показал ускорение в 3,4 раза относительно FlashAttention на контексте 128K. Для команд с собственным контуром инференса это повод пересмотреть реализацию разреженного внимания, но не архитектуру продукта целиком.
Почему общие индексы перестают работать между слоями
При генерации каждого нового токена модель обращается к кэшу ключей и значений (KV-кэшу), где хранится весь предыдущий контекст. Чем длиннее запрос и ответ, тем больше данных нужно прочитать на каждом шаге, поэтому внимание становится узким местом по пропускной способности памяти и объёму вычислений.
Разреженное внимание сокращает работу: слой выбирает только наиболее важные прошлые токены. Однако для точного выбора нужно сначала оценить весь контекст. Если повторять такой поиск в каждом слое, расходы на построение списка позиций могут съесть выигрыш от последующего разреженного вычисления.
Существующие методы решают проблему через опорные слои. Один слой находит важные позиции, а несколько следующих используют тот же список. Это дешевле, но внимание меняется по мере прохождения данных через модель: чем дальше следующий слой от опорного, тем чаще ему нужны другие токены.
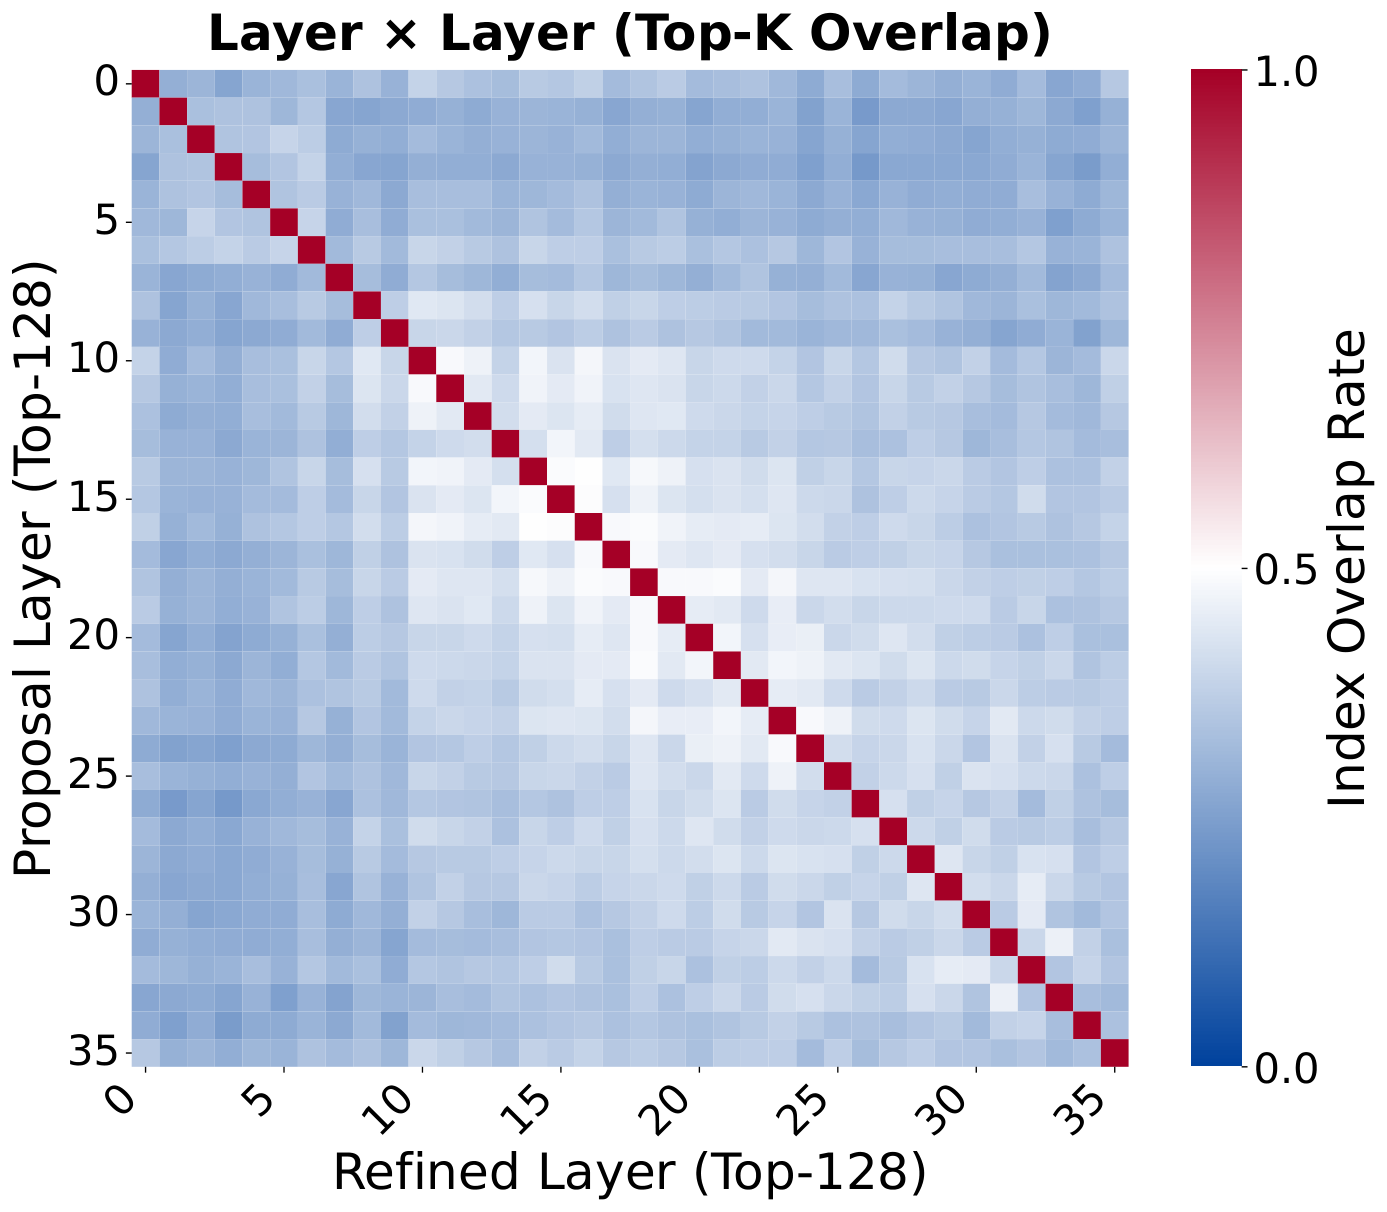
Работа показывает более узкую закономерность. Набор важных токенов меняется не полностью: его основа сохраняется, а новые позиции обычно находятся рядом с границей расширенного списка кандидатов. Значит, следующему слою не обязательно снова просматривать весь контекст — достаточно уточнить выбор внутри заранее подготовленной области.
Как слой уточняет выбор без полного поиска
Prism Attention делит слои на предлагающие и уточняющие. Предлагающий слой оценивает весь контекст и передаёт дальше список кандидатов, который шире итогового разреженного набора. Сам он использует только лучшие позиции из этого списка.
Уточняющий слой не копирует итоговый выбор. Он заново оценивает кандидатов с учётом собственного запроса и оставляет наиболее подходящие токены. Стоимость этого этапа зависит от размера списка кандидатов, а не от общей длины контекста.
В основной конфигурации список кандидатов был в четыре раза шире итогового набора. Такой запас позволяет поймать токены, которые стали важными в следующем слое, но не вошли бы в жёстко переданный список.
Полный просмотр контекста в предлагающих слоях тоже требует читать крупный кэш. Для предварительной оценки ключи переводят в INT2 — представление с двумя битами на значение. Сжатие применяют при поиске кандидатов; после него модель выполняет внимание только по выбранным позициям.
Расположение предлагающих и уточняющих слоёв заранее подбирают на калибровочных примерах по процедуре IndexCache. Поэтому Prism Attention — не замена одного ядра другим: системе нужны калибровка, дополнительное сжатое представление ключей и поддержка нового маршрута вычислений.
Когда результат меняет планы по инференсу
Prism Attention проверяли на Qwen3-4B и Qwen3-8B. В набор задач вошли AIME24, AIME25, MATH500 и GPQA-Diamond для рассуждений, а также части LongBench со средней длиной входа больше 8192 токенов. Сравнение охватывало полное внимание, Quest, LessIsMore, SeerAttention-R и IndexCache; замеры выполняли на NVIDIA H800 с ядрами Triton в SGLang.
В абляционном эксперименте на AIME25 сочетание калибровки и локального уточнения подняло точность с 50,05% при жёстком повторном использовании индексов до 64,43%. Результат показывает, что основную потерю вызывает не совместное использование индексов само по себе, а запрет слоям поправлять переданный набор.
Работа касается прежде всего авторегрессионного декодирования: этапа, на котором модель последовательно пишет ответ. Она наиболее применима к сервисам с длинными входами и длинной генерацией, где команда управляет сервером, ядрами внимания и размещением KV-кэша.
Для закрытого внешнего API планы не меняются: встроить Prism Attention без доступа к внутренней реализации модели нельзя. При самостоятельном инференсе метод стоит добавить в технический прототип рядом с FlashAttention и текущим разреженным вариантом. Проверять нужно задержку целого запроса, потребление памяти и качество именно на рабочем распределении контекстов — заявленное ускорение получено на двух моделях Qwen и конкретном классе GPU.
Источники
Иллюстрация: рисунок из статьи «Prism Attention: Proposal-Refined Index Sharing Mechanism for Efficient LLMs Inference», Zhenxu Tian, Kebin Liu, Zhengwu Yang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


