
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агента можно учить даже на неудачных попытках, если проверять, насколько каждый его ход приблизил среду к нужному состоянию. Команда из Chinese Academy of Sciences, Tongyi Lab, Alibaba Group, UCLA и NTU представила ProCredit: на младшей модели метод обошёл лучший вариант с наградой только за результат на 4,1 процентного пункта, хотя препринт не рецензирован, а все числа получили сами авторы. Для обучения агентов это открывает альтернативу отдельной модели-оценщику: промежуточную награду дают уже существующие проверки задачи.
Почему финальная награда теряет неудачные попытки
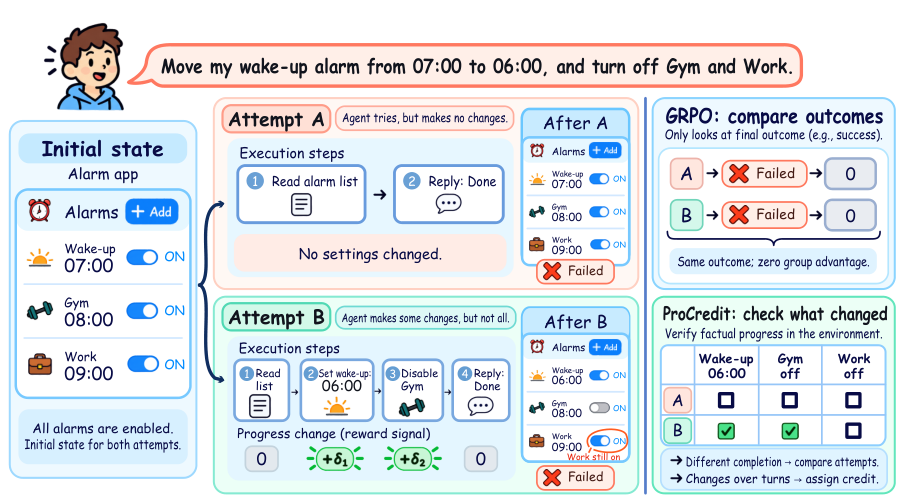
Агент в длинной задаче последовательно вызывает инструменты и меняет состояние среды. Например, ему нужно перенести будильник на другое время и отключить остальные сигналы. Обычно обучение смотрит только на финал: выполнил агент всё условие или нет.
Такой подход приравнивает частично выполненную задачу к полностью проваленной. Попытка, где агент правильно изменил время, но забыл отключить один будильник, получает ту же нулевую награду, что и попытка, где он только запросил список сигналов.
Проблема усиливается, когда все варианты ответа на одну задачу заканчиваются неудачей. Алгоритму не с чем сравнивать их внутри группы, поэтому обновление модели не получает полезного направления. Даже в успешной попытке одна итоговая оценка одинаково поощряет ход, который изменил среду, и ход, который лишь запросил информацию.
Отдельная модель-оценщик может расставить промежуточные баллы, но тогда обучение зависит от её предположений. ProCredit использует другой источник: исполняемые проверки, которые и так определяют, выполнена ли задача.
Как изменение состояния становится наградой за ход
После каждого вызова инструмента ProCredit повторно запускает проверки приёмки. Прогресс равен доле условий, которые выполняются в текущем состоянии среды. Запрос без изменений оставляет его прежним, полезное действие повышает, а ошибочное действие может снизить.
Наградой за ход становится разница между прогрессом до и после действия. Если агент настроил нужный будильник, положительную награду получает именно этот ход. Если позднее он отменил полезное изменение, награда становится отрицательной. Для этого не нужны эталонные траектории, ручная разметка отдельных действий или дополнительная LLM.
Метод распределяет сигнал на двух уровнях. Сначала он сравнивает целые попытки по итоговому успеху и достигнутому прогрессу: так среди провалов можно предпочесть тот, который выполнил большую часть задачи. Затем он сравнивает ходы внутри попытки по тому, сколько полезного прогресса ещё оставалось получить после каждого из них.
Авторы не уменьшают награду ранних ходов только из-за того, что после них потребовалось больше действий. Иначе обучение начинает предпочитать короткие траектории независимо от сложности задачи и обрывает решение там, где агенту нужны дополнительные вызовы инструментов.
Метод проверяли на Qwen3.5-4B, Qwen3.5-9B и Qwen3.5-35B-A3B. Основной средой служил AppWorld с задачами, которые меняют состояние нескольких приложений; одна тестовая часть использовала знакомые приложения, другая — приложения, не встречавшиеся при обучении. Для сравнения взяли GRPO, RLOO, DAPO, SALT, GiGPO и вариант GRPO, который учитывал только финальный прогресс. Направление результата дополнительно проверили в ToolSandbox, а способность вызывать функции — в BFCL.
Когда ProCredit меняет план обучения агента
На двух тестовых частях AppWorld преимущество младшей модели над сильнейшим методом с наградой только за результат составило 4,1 и 3,9 процентного пункта по доле завершённых задач. На более крупных моделях разрыв сократился: они реже создавали группы, где все попытки провалились, поэтому промежуточный сигнал восстанавливал меньше потерянной информации.
Ключевой результат дала не сама оценка частичного выполнения, а её привязка к конкретному ходу. Вариант GRPO-Φ добавлял финальный прогресс к оценке всей попытки, но не улучшал результат последовательно. ProCredit с той же итоговой оценкой выигрывал во всех сочетаниях размеров модели и тестовых частей, потому что отдельно поощрял действие, которое изменило среду.
Отказ от уменьшения ранних наград тоже оказался существенным. По сравнению с таким уменьшением доля завершённых задач выросла примерно на 3, 10 и 13 процентных пунктов от младшей модели к старшей. Короткая траектория сама по себе не стала целью обучения, поэтому агент сохранял действия, необходимые для средних и сложных задач.
Работа меняет план команды, если продукт уже умеет проверять конечное состояние программно. Тесты для кода, проверки записи в базе или набор условий для бизнес-процесса можно запускать после каждого изменения и использовать как обучающий сигнал. На этапе работы готового агента эти проверки для ProCredit не нужны: прогресс считывается только при обучении.
Подход слабее различает действия, если проверок мало или все они срабатывают только в самом конце. Тогда промежуточный прогресс почти не меняется, и ProCredit фактически возвращается к сравнению целых попыток. Проверять метод пока следует в средах, где состояние доступно, а конечный результат уже разложен на исполняемые условия: эксперименты охватывают AppWorld и ToolSandbox, а не произвольные диалоги без проверяемого состояния.
Источники
Иллюстрация: рисунок из статьи «ProCredit: From Outcome Rewards to Progress Credit in Agentic Reinforcement Learning», Ming Ma, Yi Zhu, Yiran Zhong и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


