
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
ProgAgent научил сравнительно небольшие модели управлять длинными цепочками инструментов через исполняемый код, а не последовательность отдельных запросов. Хотя препринт не прошёл рецензирование и числа получили сами авторы, ProgAgent-14B решил 30,7% задач LOCA-bench при состоянии среды на 64 тыс. токенов, тогда как сопоставимые модели не решили ни одной. Для команд это превращает программный вызов инструментов из приёма при запуске модели в отдельную схему подготовки агента.
Как код удерживает результаты вне контекста
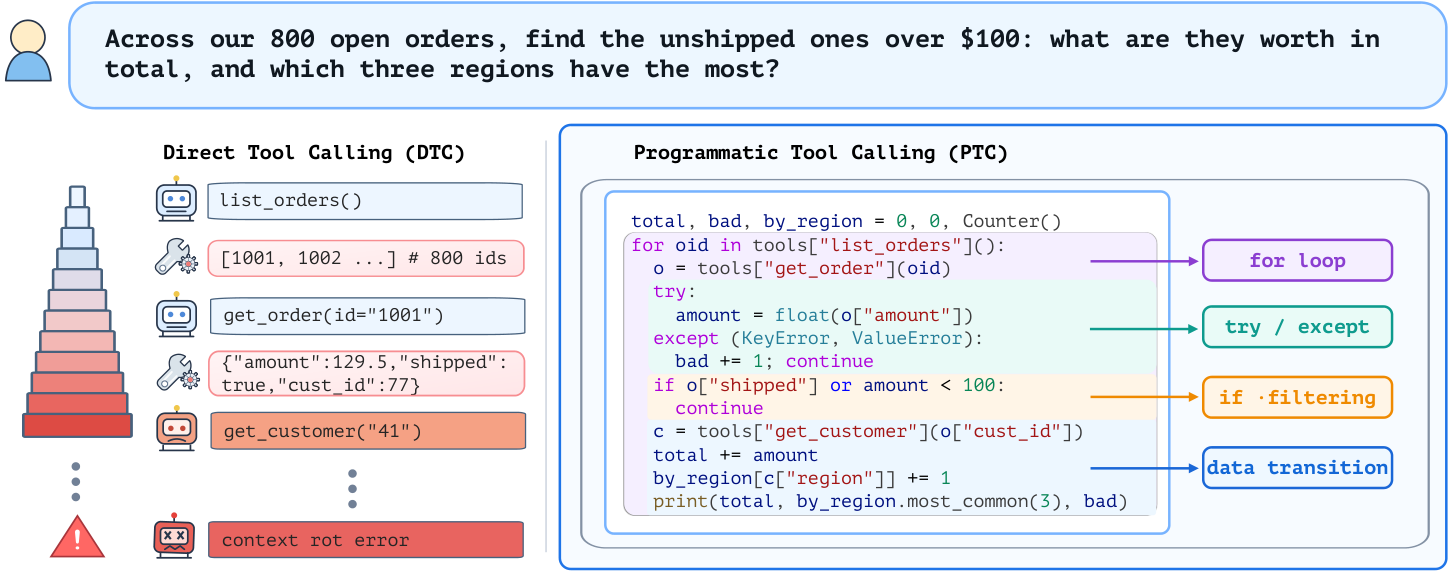
При прямом вызове инструментов (DTC) модель обращается к API по одному действию за раз. Каждый запрос и полный ответ попадают в контекст, поэтому длинная цепочка постепенно заполняется таблицами, файлами и служебными сообщениями. Модели приходится одновременно хранить логику процесса и искать нужные данные среди старых результатов.
При программном вызове инструментов (PTC) модель пишет код, который запускается в изолированной среде. Код может вызывать несколько инструментов, обходить коллекции в цикле, проверять условия и обрабатывать ошибки. Промежуточные данные остаются в переменных, а в контекст возвращается только то, что программа явно напечатала.
ProgAgent добавляет к этому интерфейсу полный учебный контур. Система создаёт задачи с базой данных, файлами, набором скрытых инструментов и проверяющей программой. Для каждой задачи строится эталонное решение, после чего независимый агент проверяет согласованность инструкции, среды и критериев успеха.
После фильтрации осталось 215 задач. Каждую разворачивали в четырёх масштабах: увеличивали базу и рабочие файлы, но сохраняли инструкцию, логику и схемы инструментов. Так сложность росла за счёт объёма среды, а не из-за подмены самой задачи.
Среда выполнения использует постоянное ядро IPython: переменные сохраняются между ходами, а отдельные эпизоды изолируются друг от друга. Сначала Qwen3-8B и Qwen3-14B дообучали на траекториях модели-учителя, затем — с подкреплением, где проверяющая программа давала награду только за полностью выполненную задачу.
Проверку провели на MCPMark, Toolathlon-Verified, MCP-Atlas и LOCA-bench. Модели сравнивали с прямым, программным и смешанным интерфейсами, сохраняя общий набор задач и настройки обучения. Поэтому работа отделяет эффект обучения от простого подключения нового способа вызова инструментов.
Программное обучение оказалось важнее одного интерфейса
После обучения ProgAgent обошёл сопоставимые открытые модели на всех четырёх наборах задач. На Toolathlon-Verified версия ProgAgent-14B достигла 17,1% успешных решений против максимум 1,9% у сравнимых моделей. На MCP-Atlas она получила 45,6% — результат на уровне Claude Sonnet-4.5 с 43,8% при прямых вызовах.
Доступ к среде для исполнения кода сам по себе не объясняет разницу. При одинаковом программном интерфейсе модели, обученные через PTC, решали больше задач, чем модели после обучения на прямых вызовах. Преимущество сохранялось и при обратной проверке: программно обученная модель лучше работала через обычные прямые вызовы.
Во время обучения модель сокращала объём ответов инструментов, попадающих в контекст, примерно на 20% и использовала примерно вдвое меньше вызовов. Она объединяла действия в программы, сохраняла промежуточные значения и печатала сводку вместо необработанных результатов. Число ошибок исполнения также снижалось по мере обучения.
Смешанный режим, где доступны оба способа вызова, уступил чистому PTC. Более широкий выбор действий не помог: единый программный интерфейс, вероятно, упрощал обучение и заставлял модель последовательно применять циклы, условия и обработку ошибок.
Когда ProgAgent меняет план разработки агента
Работа меняет план для систем, которые долго работают с базами, файлами и API, а затем сводят результаты. В таком продукте недостаточно добавить исполнение кода поверх готовой модели. ProgAgent связывает интерфейс с учебными задачами, проверяющими программами и постепенным увеличением среды.
Практический учебный стенд должен сохранять переменные между ходами, изолировать выполнение и возвращать модели только явно выбранные результаты. Задачи стоит масштабировать без изменения цели: добавлять записи и файлы, сохраняя инструменты и критерии успеха. Тогда команда проверяет именно устойчивость к длинной работе, а не способность угадывать новые формулировки.
Перенос результата на прямые вызовы оставляет свободу в рабочей архитектуре. Модель можно обучать через код, даже если продуктовый API требует последовательных запросов. Но этот вывод пока относится к двум версиям Qwen3 и четырём использованным наборам задач, а не к любому агенту.
Для браузерных и других слабо структурированных сред эффект оказался менее устойчивым: на Playwright модель часто возвращалась к одиночным вызовам без условий и обработки результатов. Среда ProgAgent также полагается на корректный признак ошибки от MCP-сервера. Если сервер возвращает сбой как обычный ответ, агент может принять его за успешный результат, поэтому рабочему контуру нужны единая обработка ошибок и строгая изоляция исполняемого кода.
Источники
Иллюстрация: рисунок из статьи «ProgAgent: Learning Tool Orchestration through Programmatic Training», Hao Li, Keqing He, Longtao Zheng и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


