
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
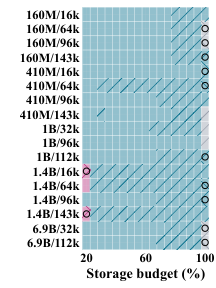
Потери качества после сжатия LLM научились оценивать без проверки каждой возможной конфигурации. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, команда Florida State University и Nokia Applied Research сократила вдвое число проверок для прореживания: прогноз отклонился от модели на полной сетке не более чем на 0,020 ната на токен. Такой подход помогает заранее отсеять конфигурации, которые не сохранят нужную способность модели.
Авторы измеряли, насколько после сжатия растёт перекрёстная энтропия эталонного ответа: чем она выше, тем хуже модель предсказывает правильное продолжение. Прогноз учитывает размер и этап обучения исходной модели, её результат до сжатия и настройки метода. Работа охватывает прореживание весов, снижение их разрядности и перенос знаний в меньшую модель.
Для математики и кода реакция на прореживание сохраняла общую форму, поэтому её удавалось восстановить по меньшему числу плотностей. При снижении разрядности простой плавной формулы оказалось недостаточно: результат зависел одновременно от числа битов и размера группы весов, а потери на панели публичных моделей различались на два порядка при одинаковой настройке. При переносе знаний важны объём независимых данных и число повторных проходов по ним: частое использование одного небольшого набора ухудшало ответы на вопросы, но итог зависел от набора, на котором модель проверяли.
Прореживание проверяли на состояниях Pythia, затем переносили форму зависимости на OLMo-2 и алгоритм Wanda, каждый раз заново подбирая коэффициенты. Снижение разрядности изучали на Pythia, перенос знаний — на моделях Gemma; способности измеряли на MATH-500, MBPP и 2WikiMultihopQA. Поэтому это способ построить собственный прогноз по калибровочным замерам, а не готовая универсальная формула. В независимом выборе между методами числовой прогноз нашёл большую часть доступной выгоды для ответов на вопросы, но фиксированный приоритет методов дал ту же потерю относительно лучшей конфигурации; для математики и кода пространство для улучшения было меньше.
Источники
Иллюстрация: рисунок из статьи «Capability Scaling-Down Laws for LLM Compression», Xueqi Cheng, Liang Wu, Kelly Wan и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


