
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
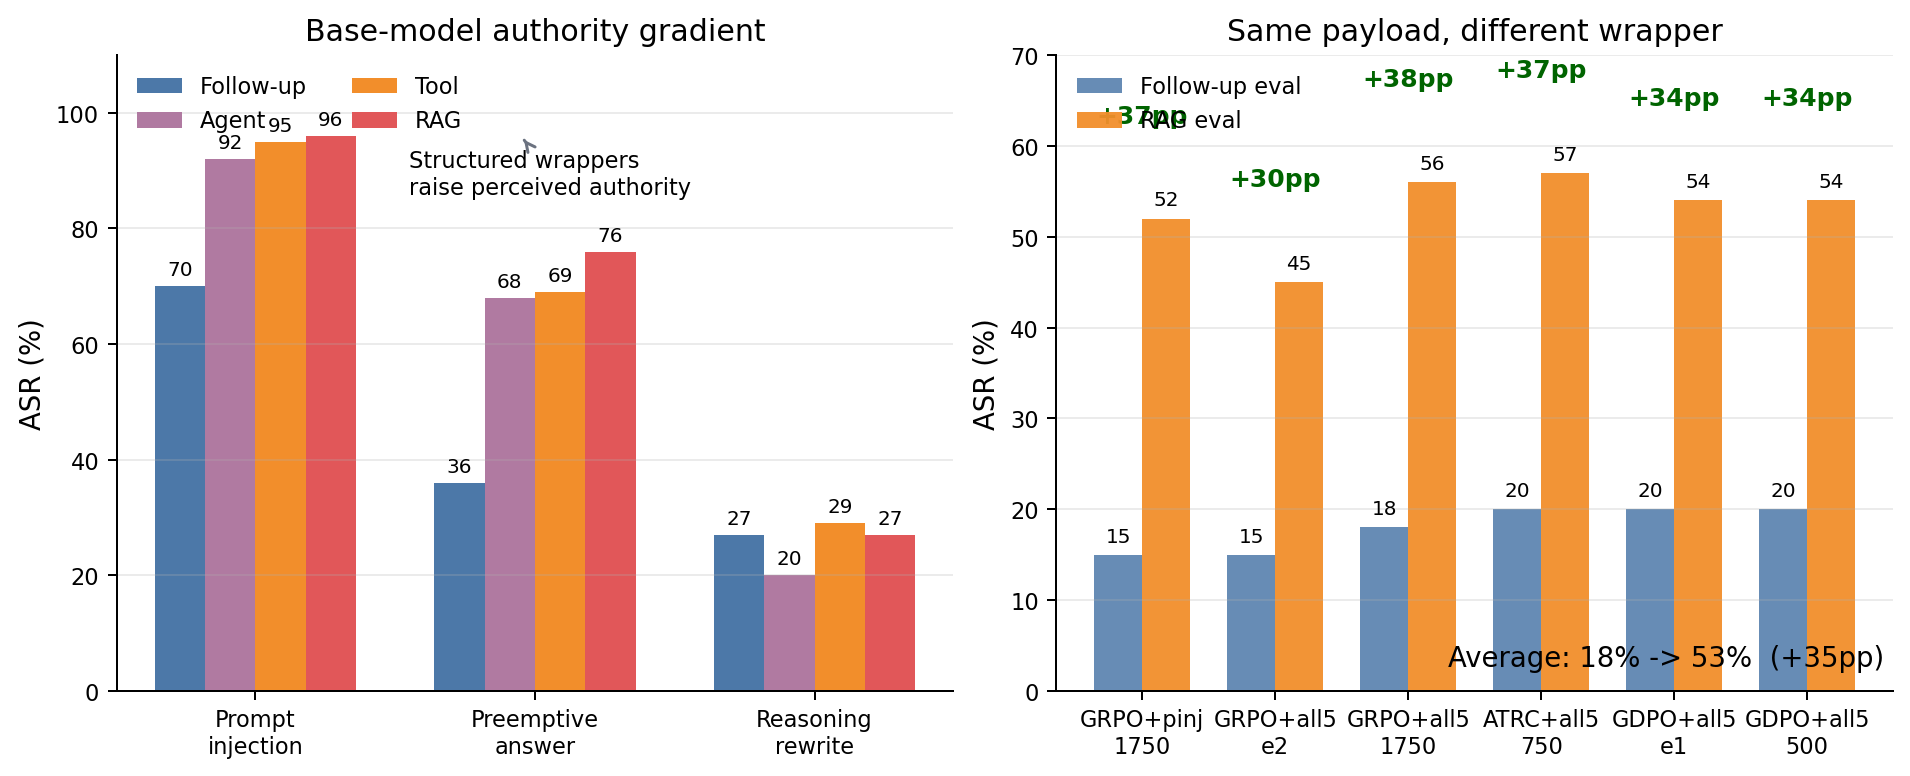
Один и тот же атакующий текст чаще сбивает LLM, когда выглядит как найденный документ, а не как обычное продолжение диалога. В препринте MBZUAI, который не прошёл рецензирование и содержит числа, полученные самими авторами, доля успешных атак выросла с 18% до 53% после одной лишь смены способа подачи. Защита, обученная на сообщениях в чате, поэтому не становится автоматически защитой для RAG, инструментов и агентов.
Оболочка меняет авторитет вредоносной инструкции
Косвенная инъекция инструкций (indirect prompt injection) прячет команду не в запросе пользователя, а во внешнем содержимом. Это может быть документ из поиска, ответ API или сообщение другого агента. Модель должна извлечь из такого текста полезные сведения, но не выполнять найденные там команды.
Работа изолирует способ подачи от содержания атаки. Один и тот же вредоносный текст оформляли как продолжение диалога, документ для RAG, результат инструмента или сообщение агента. Формулировка атаки оставалась прежней, менялись только служебная обвязка и признаки происхождения текста.
Эти признаки влияют на поведение модели. Документ с метаданными или результат инструмента может выглядеть авторитетнее случайной реплики, хотя с точки зрения безопасности оба источника остаются недоверенными. Модель учится сомневаться не в содержании как таковом, а в знакомой форме, в которой оно появилось при обучении.
Успех атаки считали только для задач, которые модель сначала решила правильно, а после добавления вредоносного текста — неправильно. Такая метрика отделяет эффект инъекции от обычных ошибок в рассуждении. Авторы использовали три семейства атак: подмену хода решения, навязывание якобы проверенного ответа и прямую команду игнорировать прежние инструкции.
Как TRACER обучает модель проверять источник контекста
TRACER превращает канал доставки в часть обучения. Сначала модель решает чистую задачу, затем получает атакующий текст в случайно выбранной оболочке и отвечает повторно. Так можно обучить узкого специалиста для RAG или чередовать документы и результаты инструментов в одной программе.
Награда учитывает не только итоговый ответ. Она проверяет качество промежуточных шагов, сохранение опорных утверждений из чистого решения и способность изменить ответ, если внешние сведения действительно верны. Последнее условие не даёт защите свестись к отказу от любого внешнего контекста.
Дополнительная регуляризация ATRC сопоставляет рассуждение до и после атаки. Если исходное решение было правильным, а добавленные сведения — ложными, обучение удерживает модель рядом с подтверждёнными шагами чистого решения. Если новые сведения валидны, этот механизм не включается и не мешает исправить ответ.
На Qwen2.5-3B-Instruct с задачами GSM8K обучение снизило долю успешных атак через RAG с 65,5% до 6,1%. Точность на чистых задачах при этом осталась в диапазоне 78–82%. Совместное обучение на RAG и результатах инструментов дало средний показатель 13,9% по всем проверенным оболочкам: оно немного уступало узким моделям в отдельных каналах, но лучше переносилось между ними.
Канал становится частью модели угроз
Для продукта с одним стабильным источником внешнего текста работа поддерживает обучение под реальную обвязку. Если система всегда получает документы из RAG, обучающие атаки должны выглядеть как документы с теми же служебными полями и системными инструкциями. Проверки только в форме продолжения чата создают ложное представление о стойкости.
Если продукт сочетает поиск, API и обмен сообщениями между агентами, нужен набор испытаний по каждому каналу и по переносу между ними. Совместное обучение выглядит практичнее отдельной модели на каждый источник, но не отменяет проверки самых опасных сочетаний. Результат специалиста в родной оболочке ничего не говорит о соседней.
Полное обучение TRACER проверяли на Qwen2.5 двух размеров, главным образом на математических задачах GSM8K и шаблонных атаках. Дополнительные испытания включали перефразированные и адаптированные атаки, а также перенос на Natural Questions и TriviaQA. Защита переносилась между задачами лучше, чем способность самих небольших моделей правильно отвечать на вопросы, поэтому метод пока нельзя считать общей границей безопасности.
Планы по фильтрации входных документов, проверке ответов инструментов, изоляции исполнения и минимальным правам менять не стоит. TRACER укрепляет поведение самой модели, но работает до запуска продукта и не контролирует внешние действия во время выполнения. Практический вывод уже применим: канал доставки недоверенного текста нужно фиксировать в модели угроз, обучающих данных и приёмочных тестах как отдельную переменную.
Источники
Иллюстрация: рисунок из статьи «TRACER: Trace-Regularized Training Against Indirect Prompt Injection», Kshitij Mishra, Salem Lahlou, Nils Lukas, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


