
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Произношение для разметки речи научились восстанавливать по готовым текстовым и акустическим моделям, без обучения отдельной системы на дорогой разметке. В препринте Hikaru Asano, Yotaro Kubo и So Kuroki, который не прошёл рецензирование и где все числа получили сами авторы, такой конвейер обошёл все проверенные варианты для японского, включая обученную модель и коммерческие мультимодальные LLM. Команда может сначала собрать решение из существующих компонентов и лишь затем решать, нужна ли собственная модель.
Как текст ограничивает варианты, а звук выбирает
Обычный преобразователь написания в произношение G2P видит только текст. Он знает словарные чтения, но не слышит, какой вариант произнёс диктор. Акустическая модель S2P решает обратную задачу по записи, однако без текста может распознать лишние или неправильные звуки.
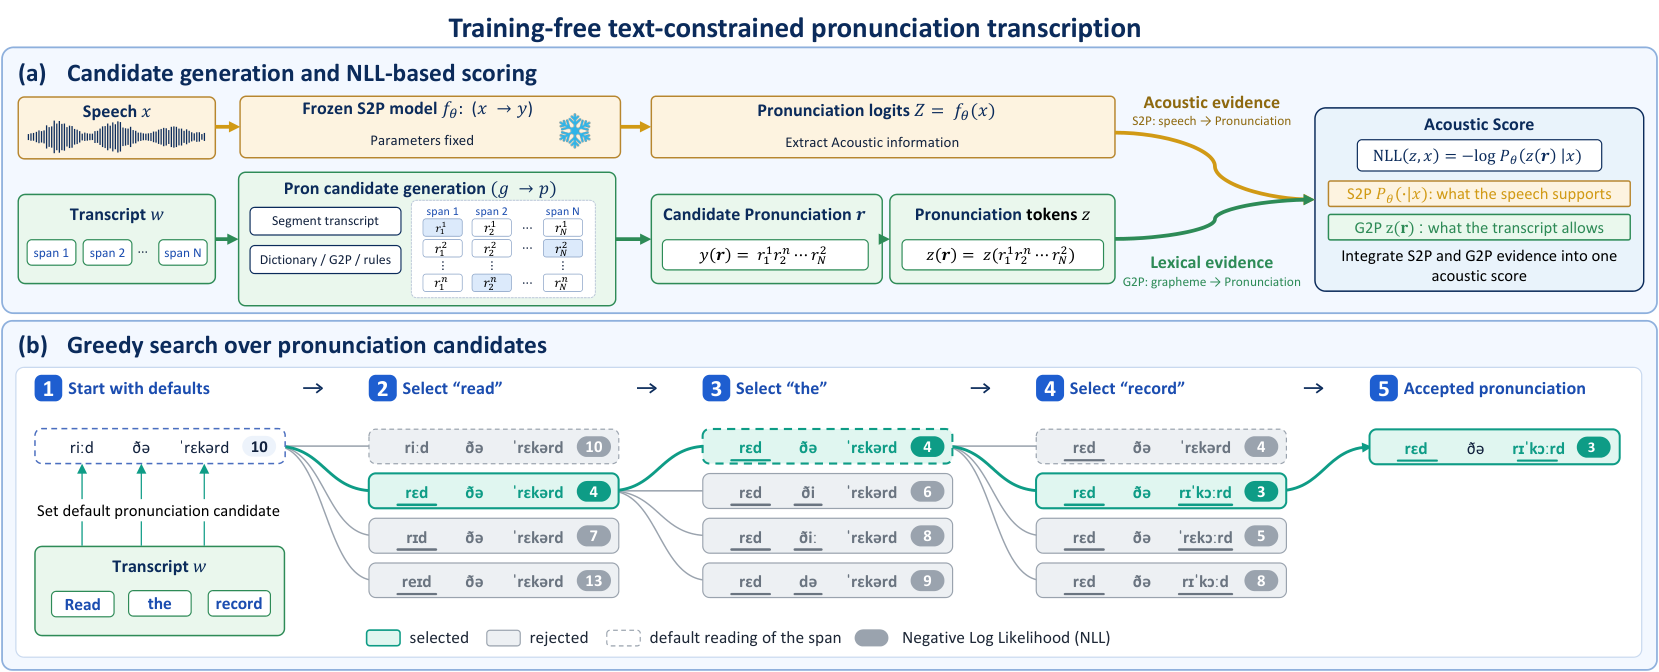
Новый конвейер соединяет эти источники во время обработки. Морфологический анализатор делит расшифровку на отрезки, после чего словари, правила и G2P составляют для каждого отрезка набор допустимых чтений. Один вариант назначается исходным — его выбрала бы система, работающая только с текстом.
Дальше готовая акустическая модель оценивает не отдельный отрезок, а полное произношение фразы. Оценкой служит отрицательный логарифм правдоподобия: чем он меньше, тем лучше предложенная последовательность соответствует записи. Полная фраза сохраняет контекст и позволяет отличить словарно допустимое чтение от того, которое действительно звучит в аудио.
Перебирать все сочетания нельзя: число полных вариантов растёт экспоненциально. Поэтому жадный поиск идёт слева направо. Для очередного отрезка он подставляет каждое чтение в полную фразу, фиксирует лучший вариант и больше к этому решению не возвращается; последующие отрезки пока остаются в исходном состоянии.
Лучевой поиск хранит несколько конкурирующих веток и повторно оценивает больше последовательностей. Здесь это почти не улучшило результат: акустические признаки конкретного чтения обычно сосредоточены рядом с соответствующим отрезком. После поиска дополнительная проверка отменяет замену, если её преимущество перед исходным чтением слишком мало.
В каскаде сначала работает более дешёвая акустическая модель. Вторую подключают только тогда, когда первый проход изменил хотя бы одно чтение. Так дорогая оценка не запускается для фраз, где текстовый вариант уже согласуется со звуком.
Где снизилась ошибка и откуда взялось ускорение
На японских записях с эталонными расшифровками доля ошибочных символов снизилась с 0,60–1,40% у текстового конвейера до 0,04–0,17%. Метрика считает замены, пропуски и вставки в нормализованной последовательности каны.
С расшифровками от Whisper large-v3 ошибка выросла до 0,64–1,58%, но конвейер всё равно оказался точнее остальных проверенных систем. Это показывает границу метода: акустическая оценка выбирает произношение внутри вариантов, заданных текстом, но не исправляет все ошибки самого распознавания речи.
Жадный поиск работал в 3–3,5 раза быстрее лучевого при близком качестве. Каскад оказался в 2 раза быстрее прямого декодирования kana-whisper, поскольку запускал вторую модель только в выбранных случаях и оценивал готовые варианты целиком, а не генерировал произношение последовательно.
Подмена записи чужим аудио или тишиной резко ухудшила результат. Значит, система не просто повторяет словарь: выбор действительно зависит от акустики.
На Spanish, French и предварительной выборке English тот же принцип превзошёл специализированные текстовые системы и все проверенные открытые мультимодальные LLM. Лучший состав моделей различался по языкам: для Spanish выиграл один акустический оценщик, а для French и English — каскад. Универсальной конфигурации работа не предлагает.
Когда обучение отдельной модели можно отложить
Подход меняет порядок разработки конвейера для подготовки TTS-данных. Если у команды уже есть аудио, расшифровки, словарь или G2P и подходящая акустическая модель, сначала можно собрать повторную оценку кандидатов. Для этого не нужны тройки из записи, текста и вручную размеченного произношения, на которых обычно обучают совместную модель.
Экономия возникает не из-за новой базовой модели, а из-за узкого пространства поиска. Текст отсекает фонетически возможные, но лексически бессмысленные последовательности; звук разрешает неоднозначность, которую не видит словарь. Если нужного чтения нет среди кандидатов, акустический оценщик не сможет его создать.
Основные японские замеры провели на трёх корпусах, используя по 512 записей из каждого; скорость измеряли на одной H100 при последовательной обработке. Дополнительную проверку сделали на небольших языковых выборках, причём English сами авторы считают предварительным. Сравнение охватило текстовые и акустические системы, обученную совместную модель, а также открытые и коммерческие мультимодальные LLM.
Отсутствие обучения не означает отсутствие настройки. Для нового языка придётся подобрать словари и акустические модели, согласовать их алфавиты, проверить покрытие вариантов и настроить порог, который отменяет слабые замены. В работе этот порог подбирали отдельно по языкам на проверочных данных.
Для производственного конвейера разумный следующий шаг — прототип на собственных записях с отдельной проверкой ошибок распознавания и пропущенных словарных чтений. Обучать совместную модель стоит после такого теста: он покажет, упирается ли качество в акустический оценщик, набор кандидатов или исходную расшифровку.
Источники
Иллюстрация: рисунок из статьи «Training-Free Pronunciation Transcription via Text-Constrained Acoustic Rescoring», Hikaru Asano, Yotaro Kubo, So Kuroki, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


