
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили исправлять локальные ошибки прямо во время рассуждения, не начиная решение заново. Хотя препринт не рецензирован и числа получили сами авторы, такая проверка сократила долю ошибочных ответов на величину до 14,9%. Для этого не нужна вторая модель: математические выражения проверяет обычная программа на CPU.
Ошибка останавливает только продолжение после неверного шага
Работу выполнила команда Technion. Она предложила проверять не готовый ответ, а отдельные равенства по мере того, как модель пишет решение. Это позволяет поймать неверный знак, ошибочное раскрытие скобок или неправильную замену индекса до того, как модель построит на ошибке остальную цепочку.
Генератор выдаёт текст частями. После каждой новой части программа ищет завершённые математические выражения с помощью регулярных выражений. Цепочку равенств она разбивает на пары, а определения, присваивания и выражения с разными наборами свободных переменных отбрасывает.
Оставшиеся равенства проверяет система компьютерной алгебры. Числовые выражения она вычисляет напрямую, а в выражения с переменными подставляет выбранные значения и сравнивает обе стороны с допустимой погрешностью. Такая проверка занимает примерно 22–25 мс процессорного времени.
Проверка идёт асинхронно: LLM продолжает генерацию на GPU, пока CPU разбирает уже написанный шаг. Если равенство верно или его нельзя надёжно вычислить, процесс не меняется. Если стороны не совпадают, контроллер прерывает генерацию, удаляет текст после ошибочного шага и добавляет короткое сообщение о расхождении.
Сам неверный шаг остаётся в контексте, поэтому модель видит, что именно нужно пересмотреть. Проверяющая программа не предлагает решение и не подсказывает новую стратегию. Она лишь указывает на локальную несогласованность, после чего та же LLM продолжает рассуждение; число откатов ограничили тремя на задачу.
Это не формальное доказательство. Численные подстановки могут не обнаружить некоторые расхождения, а корректное равенство иногда зависит от условий, которых локальная проверка не видит. Метод также пропускает ошибочную трактовку условия, неудачную стратегию и вычисления, которые верны сами по себе, но основаны на неверной предпосылке.
Проверка помогает там, где модель уже умеет решать задачу
Метод испытали на 2700 задачах ASyMoB по символической математике. В тест вошли три модели с открытыми весами из семейств Qwen3 и Gemma-4; каждую сравнивали с обычной генерацией без вмешательства.
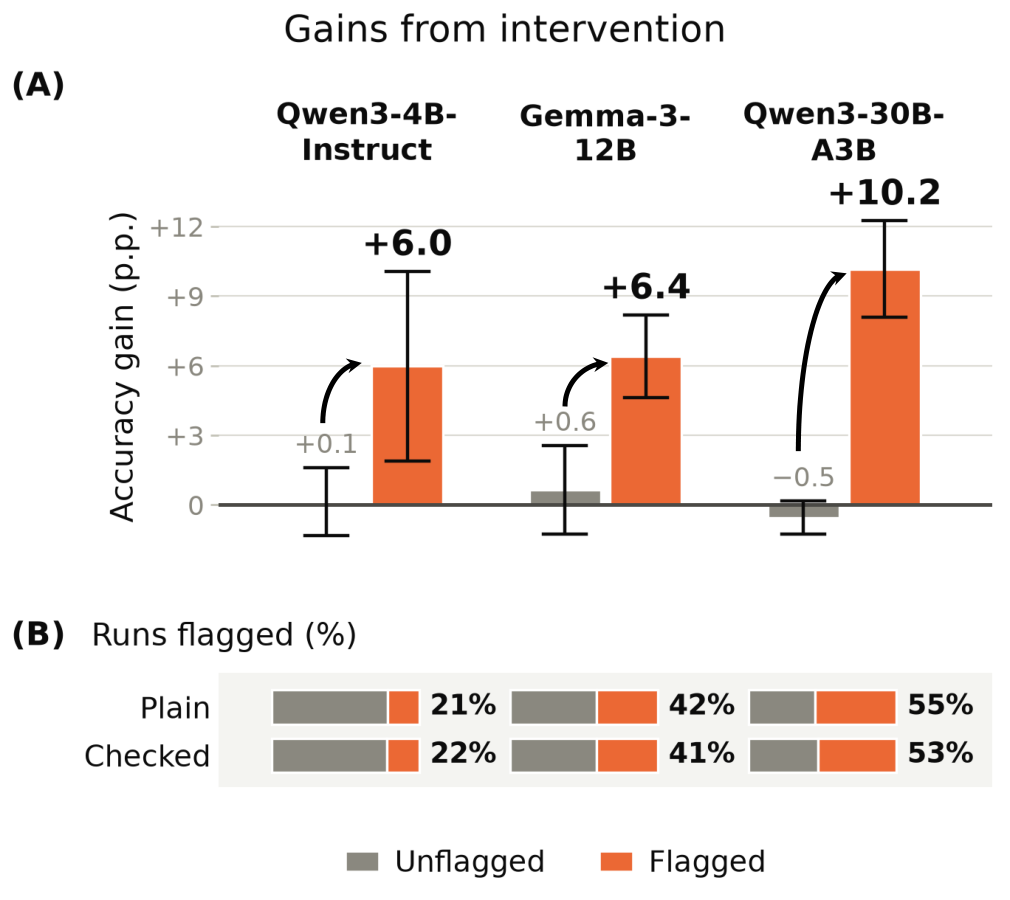
Точность выросла на 1,4–5,6 процентного пункта, а средний расход токенов — на 6–7%. Дополнительные токены уходили в основном на повторное рассуждение после замечания, а не на текст, который успела написать и затем отбросила модель.
Рост сосредоточился в ответах, где проверка действительно нашла ошибку. Если она не срабатывала, точность оставалась в пределах погрешности. Больше всего выиграли задачи, которые модель решала нестабильно: часть попыток завершала верно, а часть портила локальной вычислительной ошибкой.
Проверяли только задачи ASyMoB лёгкой и средней сложности и только модели двух семейств. Результат показывает работу схемы на символической математике, но сам по себе не подтверждает такой же выигрыш для кода, инженерных расчётов или вызовов инструментов.
Планы меняются только для задач с проверяемыми промежуточными данными
Для команд, которые строят математические или инженерные помощники, работа предлагает альтернативу второй LLM-оценщику. Если утверждение можно извлечь из потока и проверить обычным кодом, GPU остаётся занят основной генерацией, а правила проверки не зависят от выбранной модели.
Однако внедрение требует управления самой генерацией. Система должна получать поток токенов, запоминать границы проверяемых шагов, отменять продолжение и возобновлять запрос с исправляющим сообщением. API, который возвращает только готовый ответ, для такой схемы недостаточен.
Рост числа токенов также нельзя напрямую считать ростом задержки. Остановка запроса, повторная обработка контекста, управление кэшем и работа планировщика могут добавить время, которого не видно в токенах. В работе не измеряли итоговую пропускную способность сервиса при такой интеграции.
Расширять подход стоит не на любые рассуждения, а на участки с дешёвой и однозначной проверкой. В коде это могут быть синтаксис и типы, в научных расчётах — размерности, в финансовых документах — арифметические связи, в вызовах инструментов — соответствие схеме данных.
Работа не заменяет проверку конечного результата и не добавляет модели знаний. Она показывает более узкий архитектурный приём: если ошибка выражена в форме, которую понимает обычная программа, её можно поймать в момент появления и дать основной модели шанс продолжить с того же места.
Источники
Иллюстрация: рисунок из статьи «Catch It Where It Happens: Real Time Error Correction During LLM Reasoning», Rotem Elimelech, Michael Shalyt, Ido Kaminer, CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


