
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
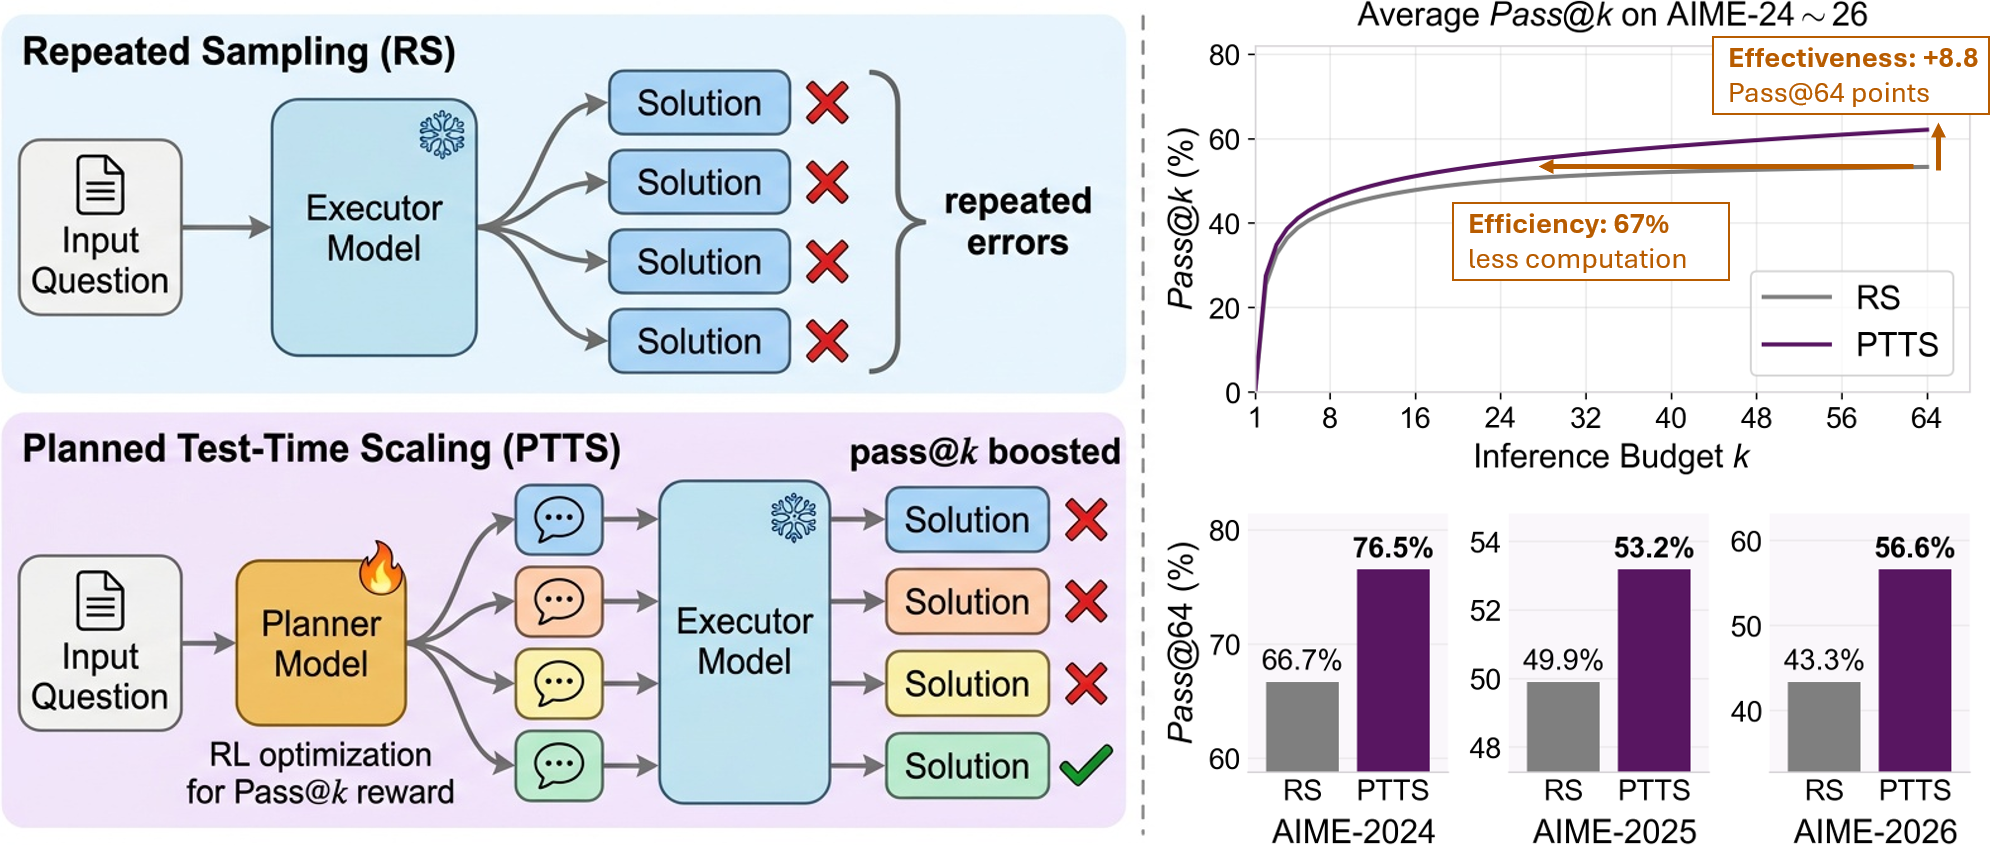
Дополнительные попытки LLM теряют пользу, когда повторяют один и тот же ход решения. В препринте UCLA и Amazon, который не проходил рецензирование и содержит замеры самих авторов, обученный планировщик PTTS-RL обошёл независимые попытки по pass@k на величину до 13,4 процентного пункта. Для систем, которые тратят вычисления на несколько ответов, это переносит внимание с числа веток на то, как между ними распределены стратегии.
Планировщик распределяет стратегии до запуска решений
Обычное масштабирование вычислений при ответе (test-time scaling) запускает модель несколько раз с одним запросом. Метрика pass@k считает задачу решённой, если правильным оказался хотя бы один из k ответов. Такой подход помогает только тогда, когда попытки отличаются содержательно.
Независимая выборка этого не гарантирует. Модель снова выбирает наиболее вероятный способ рассуждения, повторяет сходные промежуточные шаги и приходит к той же ошибке. Особенно узким распределение может стать после обучения с подкреплением: модель чаще успешно отвечает с первой попытки, но реже пробует менее очевидные стратегии.
PTTS добавляет перед исполнителем отдельный планировщик. Он получает исходную задачу и за один последовательный проход выпускает набор разных набросков решения. Затем неизменённая модель-исполнитель разворачивает каждый набросок в полный ответ независимо от остальных.
Вариант PTTS-ZS работает без дополнительного обучения: базовая Qwen3 создаёт планы, а рассуждающая Qwen3 решает по ним задачу. Базовая модель подошла для планирования лучше, потому что рассуждающая модель склонна сразу выбирать одну стратегию и переходить к вычислениям вместо составления нескольких альтернатив.
PTTS-RL обучает только планировщик и выдаёт ему награду, если хотя бы одна ветка решила задачу. Исполнитель остаётся замороженным. Поэтому планировщик учится не создавать несколько правдоподобных формулировок одного подхода, а распределять ветки между дополняющими друг друга способами решения.
Разнообразие помогает, только если ведёт к правильным ответам
Метод проверяли на пяти математических наборах задач с Qwen3-1.7B и Qwen3-4B. Для каждой задачи оценивали до 64 попыток и сравнивали PTTS с независимой выборкой и Guided Sampling, который также предлагает разные концепции перед решением.
PTTS-ZS улучшил pass@k относительно независимой выборки на величину до 6,7 процентного пункта. Обученный PTTS-RL оказался сильнее варианта без обучения: оптимизация прямо по итоговому успеху набора веток отсекала разнообразие, которое меняет форму ответа, но не открывает новый путь к решению.
Анализ кластеров решений подтвердил различие. PTTS-ZS создавал наиболее разнообразный набор ответов в целом, тогда как PTTS-RL чаще разводил по разным кластерам именно правильные ответы. Для продукта это существеннее формального разнообразия: десять непохожих ошибок не полезнее десяти одинаковых.
Теоретическая часть объясняет этот эффект через совместное распределение веток. Независимая выборка оптимизирует качество каждой попытки отдельно, а PTTS может учитывать весь набор. При этом архитектура включает обычную выборку как частный случай: если планировщик выдаёт пустые или одинаковые планы, поведение сводится к прежней схеме.
Менять стоит оркестрацию, а не основную модель
Работа предлагает локальное изменение для систем, где уже запускают несколько решений одной проверяемой задачи. Исполнителя не требуется переобучать: перед ним появляется планировщик, а существующий пул параллельных запросов получает разные наброски. Небольшой планировщик в экспериментах также переносился на более крупного исполнителя, поэтому обе части не обязаны масштабироваться вместе.
Увеличивать число планов без границ не потребовалось. В основных опытах обучали планировщик создавать четыре ветки, а затем масштабировали вычислительный бюджет повторением наборов. Более крупный набор планов повышал стоимость обучения, но не давал устойчивого выигрыша.
Качество сигнала при обучении зависело и от длины ответа исполнителя. При лимите в 4 тысячи токенов планировщик получал наиболее полезную обратную связь. Когда лимит поднимали до 10 тысяч, исполнитель успевал отказаться от плохого плана и самостоятельно найти ответ, из-за чего итоговый pass@k снижался на 7,8 процентного пункта: награда доставалась наброску, который фактически не помог.
Результаты относятся к задачам с автоматически проверяемым ответом, математическим наборам и двум размерам Qwen3. Они прямо поддерживают внедрение PTTS в решатели, где можно проверить каждую ветку и достаточно успеха одной из них. Для диалогов, генерации текста и процессов без однозначного критерия правильности работа не показывает, как обучать планировщик или выбирать лучший итоговый ответ.
Командам с одной попыткой на запрос PTTS не даёт отдельного преимущества: его предмет — распределение уже выделенного параллельного бюджета. Если же стоимость создают десятки сходных прогонов, сначала стоит измерить повторяемость стратегий, а затем сравнить общий план с добавлением новых независимых веток.
Источники
Иллюстрация: рисунок из статьи «Planned Test-Time Scaling with Coordinated Reasoning Paths», Xueqing Wu, Langxing Bai, Hritik Bansal и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


