
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
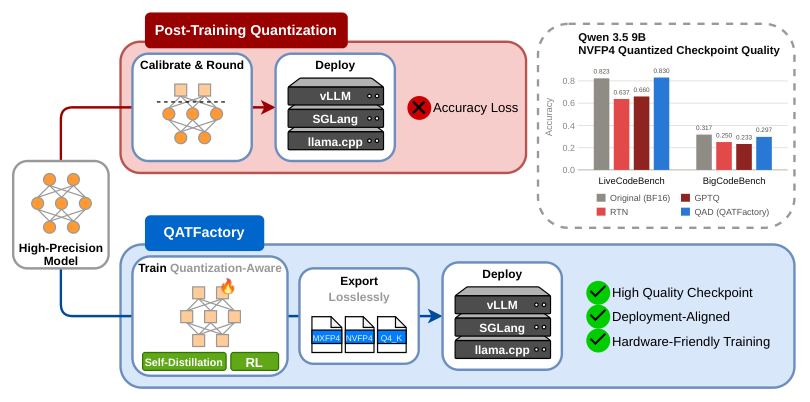
QATFactory позволяет готовить LLM к четырёхбитному запуску на оборудовании, которое не умеет выполнять такие вычисления напрямую. Команда University of Illinois Urbana-Champaign и The University of Texas at Austin показала на Qwen3.5-9B, что в MXFP4 средняя доля правильных ответов выросла на 9,6 процентного пункта относительно квантования после обучения, хотя препринт не рецензирован и все числа получили сами авторы. Командам больше не нужно ждать целевые ускорители, но формат развёртывания придётся выбирать до обучения.
Как обучение повторяет арифметику целевого движка
Квантование сокращает разрядность весов и промежуточных значений модели. Это уменьшает требования к памяти и позволяет использовать быстрые низкоразрядные блоки ускорителя, но округление и обрезка значений меняют ответы модели. При квантовании после обучения параметры уже не могут приспособиться к этой ошибке.
QATFactory вставляет квантование и обратное преобразование прямо в проход модели во время обучения. Для каждого формата система повторяет набор допустимых значений, правила округления, границы диапазона, разбиение на блоки и уровни масштабирования, которые использует целевой движок. При этом матрицы перемножаются в BF16, поэтому NVFP4 можно отрабатывать на H100 без FP4 Tensor Cores.
В основном сценарии замороженная исходная модель служит учителем, а её квантованная копия — учеником. Ученик получает те же входные данные и учится воспроизводить распределение ответов учителя с учётом ошибок округления. Авторы называют этот процесс дистилляцией с учётом квантования.
После обучения QATFactory упаковывает веса сразу в формат целевого движка. Контрольную точку можно загрузить в vLLM, SGLang или llama.cpp без дополнительного преобразования, собственных операций и накладных расходов при генерации. Поддерживаются NVFP4, MXFP4 и Q4_K, а также обычные плотные модели и модели со смесью экспертов.
NVFP4 и MXFP4 требуют разных стратегий
Максимально точное повторение развёртывания во время обучения оказалось не всегда лучшей стратегией. Для NVFP4 лучший совокупный результат обычно давало обучение, при котором квантовали только веса: оно обошло лучший вариант квантования после обучения на 3,5 процентного пункта. Во время запуска формат всё равно снижает разрядность и весов, и активаций.
Для MXFP4 сработал противоположный подход: модель лучше переносила развёртывание, когда при обучении квантовали и веса, и активации. Поэтому обозначения W4A4 и W4A16 описывают не только конечный файл. W4A4 означает четырёхбитные веса и активации, а в W4A16 активации остаются шестнадцатибитными; выбор между ними влияет на устойчивость оптимизации.
Длину обучающих примеров тоже нельзя сводить к общему числу токенов. При одинаковом бюджете более редкие последовательности длиной 32K дали в среднем на 1,9 пункта больше, чем большее число примеров длиной 4K. Выигрыш проявился не на каждом тесте, но длинные примеры лучше сохранили качество в совокупности задач по математике и программированию.
Проверка охватывала модели размером от 8 до 230 млрд параметров. Авторы экспортировали контрольные точки в рабочие движки и оценивали уже исполняемые низкоразрядные модели, а не только имитацию внутри обучающей среды. Это важная граница результатов: работа сравнивает конкретные форматы и движки, а не предлагает универсальное правило для любого квантования.
Когда QATFactory меняет план внедрения
Работа меняет процесс для команд, которые рассчитывают получить скорость W4A4, но не хотят принимать потерю качества после обычного квантования. Формат запуска теперь нужно зафиксировать до дообучения: выбрать движок, воспроизвести его арифметику, обучить модель с этими искажениями, экспортировать контрольную точку и проверить её в том же движке.
Перенос рецепта между форматами рискован. Настройка, которая помогает MXFP4, может ухудшить NVFP4, поэтому сравнивать стоит экспортированные модели, а не только обучающую ошибку. Это также означает, что собственный формат квантования потребует точной реализации его округления, масштабов и блочной структуры внутри обучающего контура.
Полное обновление параметров дало лучшее качество, но требует держать в памяти учителя, ученика и состояние оптимизатора. LoRA снизила расход памяти в 2,9 раза, однако увеличение ранга адаптера не устранило отставание от полного обучения. Для ограниченного кластера LoRA остаётся способом проверить гипотезу, но не равноценной заменой полного цикла.
Если продукт уже укладывается в допустимую потерю качества после обычного квантования, работа не показывает, что дополнительное обучение окупит себя. QATFactory прежде всего полезен там, где команда заранее выбрала низкоразрядный формат, измерила неприемлемое ухудшение и готова включить целевую арифметику в обучение.
Источники
Иллюстрация: рисунок из статьи «QATFactory: A Versatile, Deployment-Aligned Framework for Quantization-aware Training and Distillation of LLMs», Weili Xu, Jisen Li, Yuqing Jian и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


