
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM можно заставить чаще находить нужные фрагменты в середине длинного контекста, не удаляя и не переставляя исходный текст. Работа University of Southern California и Amazon Web Services пока не рецензирована, а все числа получили сами авторы; QGPM дал лучший средний результат на всех четырёх проверенных LLM. Метод можно добавить при инференсе, если команда запускает модель с открытыми весами и может менять её внутренние вычисления.
Почему середина контекста теряется внутри RoPE
Длинное окно ещё не означает, что модель одинаково хорошо использует весь текст. Она чаще находит сведения в начале и конце, а фрагменты из середины пропускает. Особенно заметно это там, где формулировки вопроса и ответа почти не совпадают.
Одна из причин связана с вращательным позиционным кодированием (RoPE). Оно представляет позицию токена как набор вращений с разной частотой. Быстрые вращения помогают различать близкие токены, но на больших расстояниях успевают сделать много полных оборотов и перестают надёжно передавать дистанцию до запроса.
Чем дальше находится нужный фрагмент, тем меньше частотных компонентов сохраняют устойчивый сигнал о его положении. Поэтому авторы не расширяют окно, а сокращают вычисляемое расстояние между запросом и подходящими предложениями.
Другие методы обычно сжимают вход, усиливают уже рассчитанное внимание или заранее переназначают позиции для всего текста. В первом случае модель теряет удалённые токены. Во втором позиционный сигнал уже успевает ослабнуть. В третьем один и тот же порядок действует для любых запросов, хотя разные вопросы требуют разных частей документа.
Как запрос меняет виртуальные позиции токенов
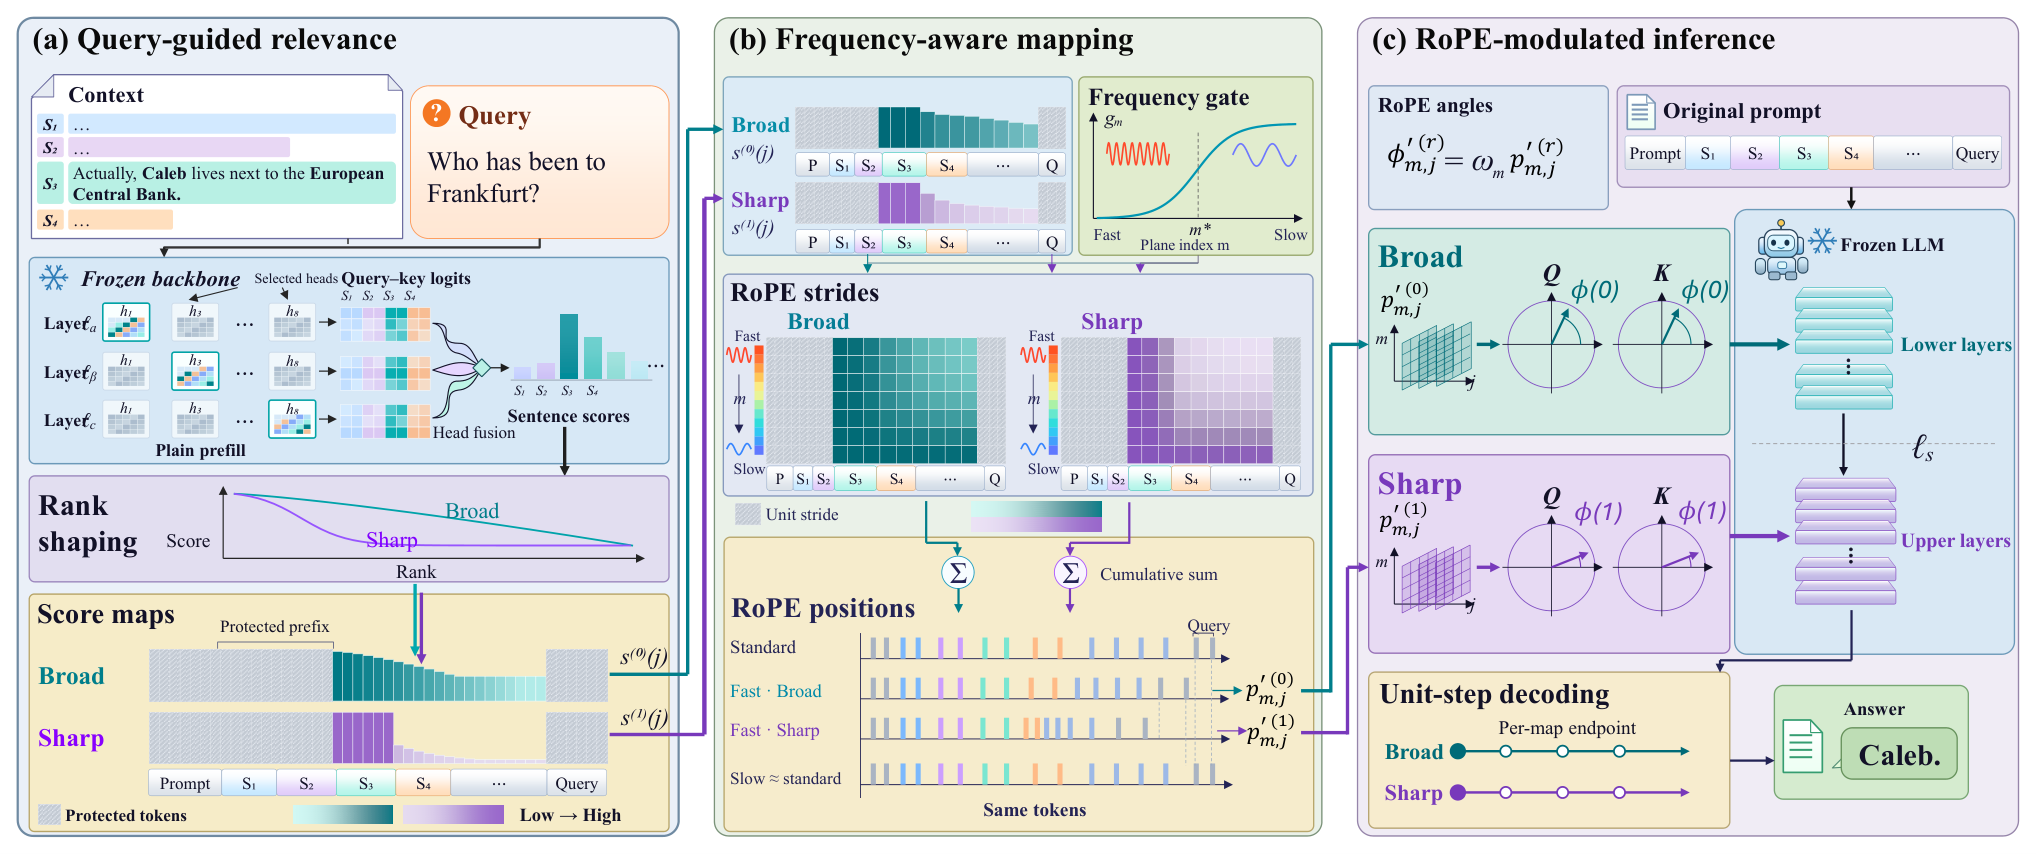
QGPM сначала прогоняет контекст через базовую модель без изменений и смотрит, какие предложения сильнее связаны с запросом в выбранных головах внимания. Эти головы один раз подбирают для каждой модели на отдельном наборе примеров с размеченными ответами. Сам контекст делят на предложения, после чего каждому присваивают место в рейтинге релевантности.
Из рейтинга строятся две карты. Широкая сохраняет несколько возможных фрагментов и работает в нижних слоях модели. Узкая оставляет меньше кандидатов и применяется в верхних слоях, где модель уже может точнее отделять ответ от отвлекающего текста.
Затем QGPM меняет шаг позиции на быстрых частотных компонентах RoPE. Токены из слабо связанных предложений продвигаются меньше обычного, поэтому важный фрагмент виртуально приближается к запросу. На медленных компонентах позиции остаются прежними и продолжают передавать общий порядок документа.
Текст до первого подходящего предложения тоже не сжимается. Он участвует в построении представления этого предложения, поэтому его изменение могло бы испортить сам фрагмент с ответом. После защищённого префикса метод сжимает только промежуток между важным фрагментом и запросом.
Токены при этом не исчезают и физически не меняются местами. Модель получает новые координаты только внутри RoPE, а её веса остаются прежними. Для ответа требуется дополнительная начальная обработка контекста, но стоимость генерации каждого следующего токена и размер кэша ключей и значений не меняются.
Когда QGPM меняет планы команды
Метод проверили на четырёх моделях семейств Qwen, Ministral и Granite, на задачах NoLiMa и RULER с контекстом от 4K до 64K токенов. В сравнение вошли исходные модели, удаление малозначимых токенов и несколько способов переназначить позиции без учёта запроса. Для Ministral верхняя длина выходила за предел настроенного окна модели.
QGPM улучшил средний результат исходных моделей на 2,4–8,9 пункта и ни на одной базовой модели не опустился ниже них по общему среднему. Основной выигрыш пришёлся на поиск фактов и ключей в длинном тексте. В обычных вопросах и ответах результат в основном остался на уровне исходной модели, поэтому позиционное расстояние там, вероятно, не было главным препятствием.
Отдельное сравнение с удалением и перестановкой фрагментов провели только на Qwen2.5-7B. QGPM лучше справился с поиском и сохранил исходный порядок документа, но это сравнение пока нельзя переносить на все проверенные семейства. Оно показывает более узкий вывод: если релевантность уже можно получить из внимания самой модели, необязательно подключать внешний ранжировщик или выбрасывать часть контекста.
Работа меняет планы команд, которые самостоятельно запускают LLM с RoPE и уже упираются в поиск по длинным документам. QGPM можно испытать как модификацию инференса без нового обучения и подготовки датасета. Однако реализация требует доступа к векторам запросов и ключей, головам внимания и таблицам RoPE, поэтому поверх закрытого API метод применить нельзя.
Дополнительный прогон увеличит задержку до первого токена. При нескольких вопросах к одному документу часть вычислений можно переиспользовать, но в интерактивном продукте с единственным запросом этот расход придётся сравнить с приростом точности. Поэтому QGPM пока выглядит не поводом менять выбранную модель, а отдельной оптимизацией для систем поиска по большим неизменным документам.
Источники
Иллюстрация: рисунок из статьи «Query-Guided RoPE Modulation for Lost-in-the-Middle Mitigation in Long-Context LLMs», Peiyu Zhang, Heng Ping, Shinibali Bhattacharyya и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


