
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
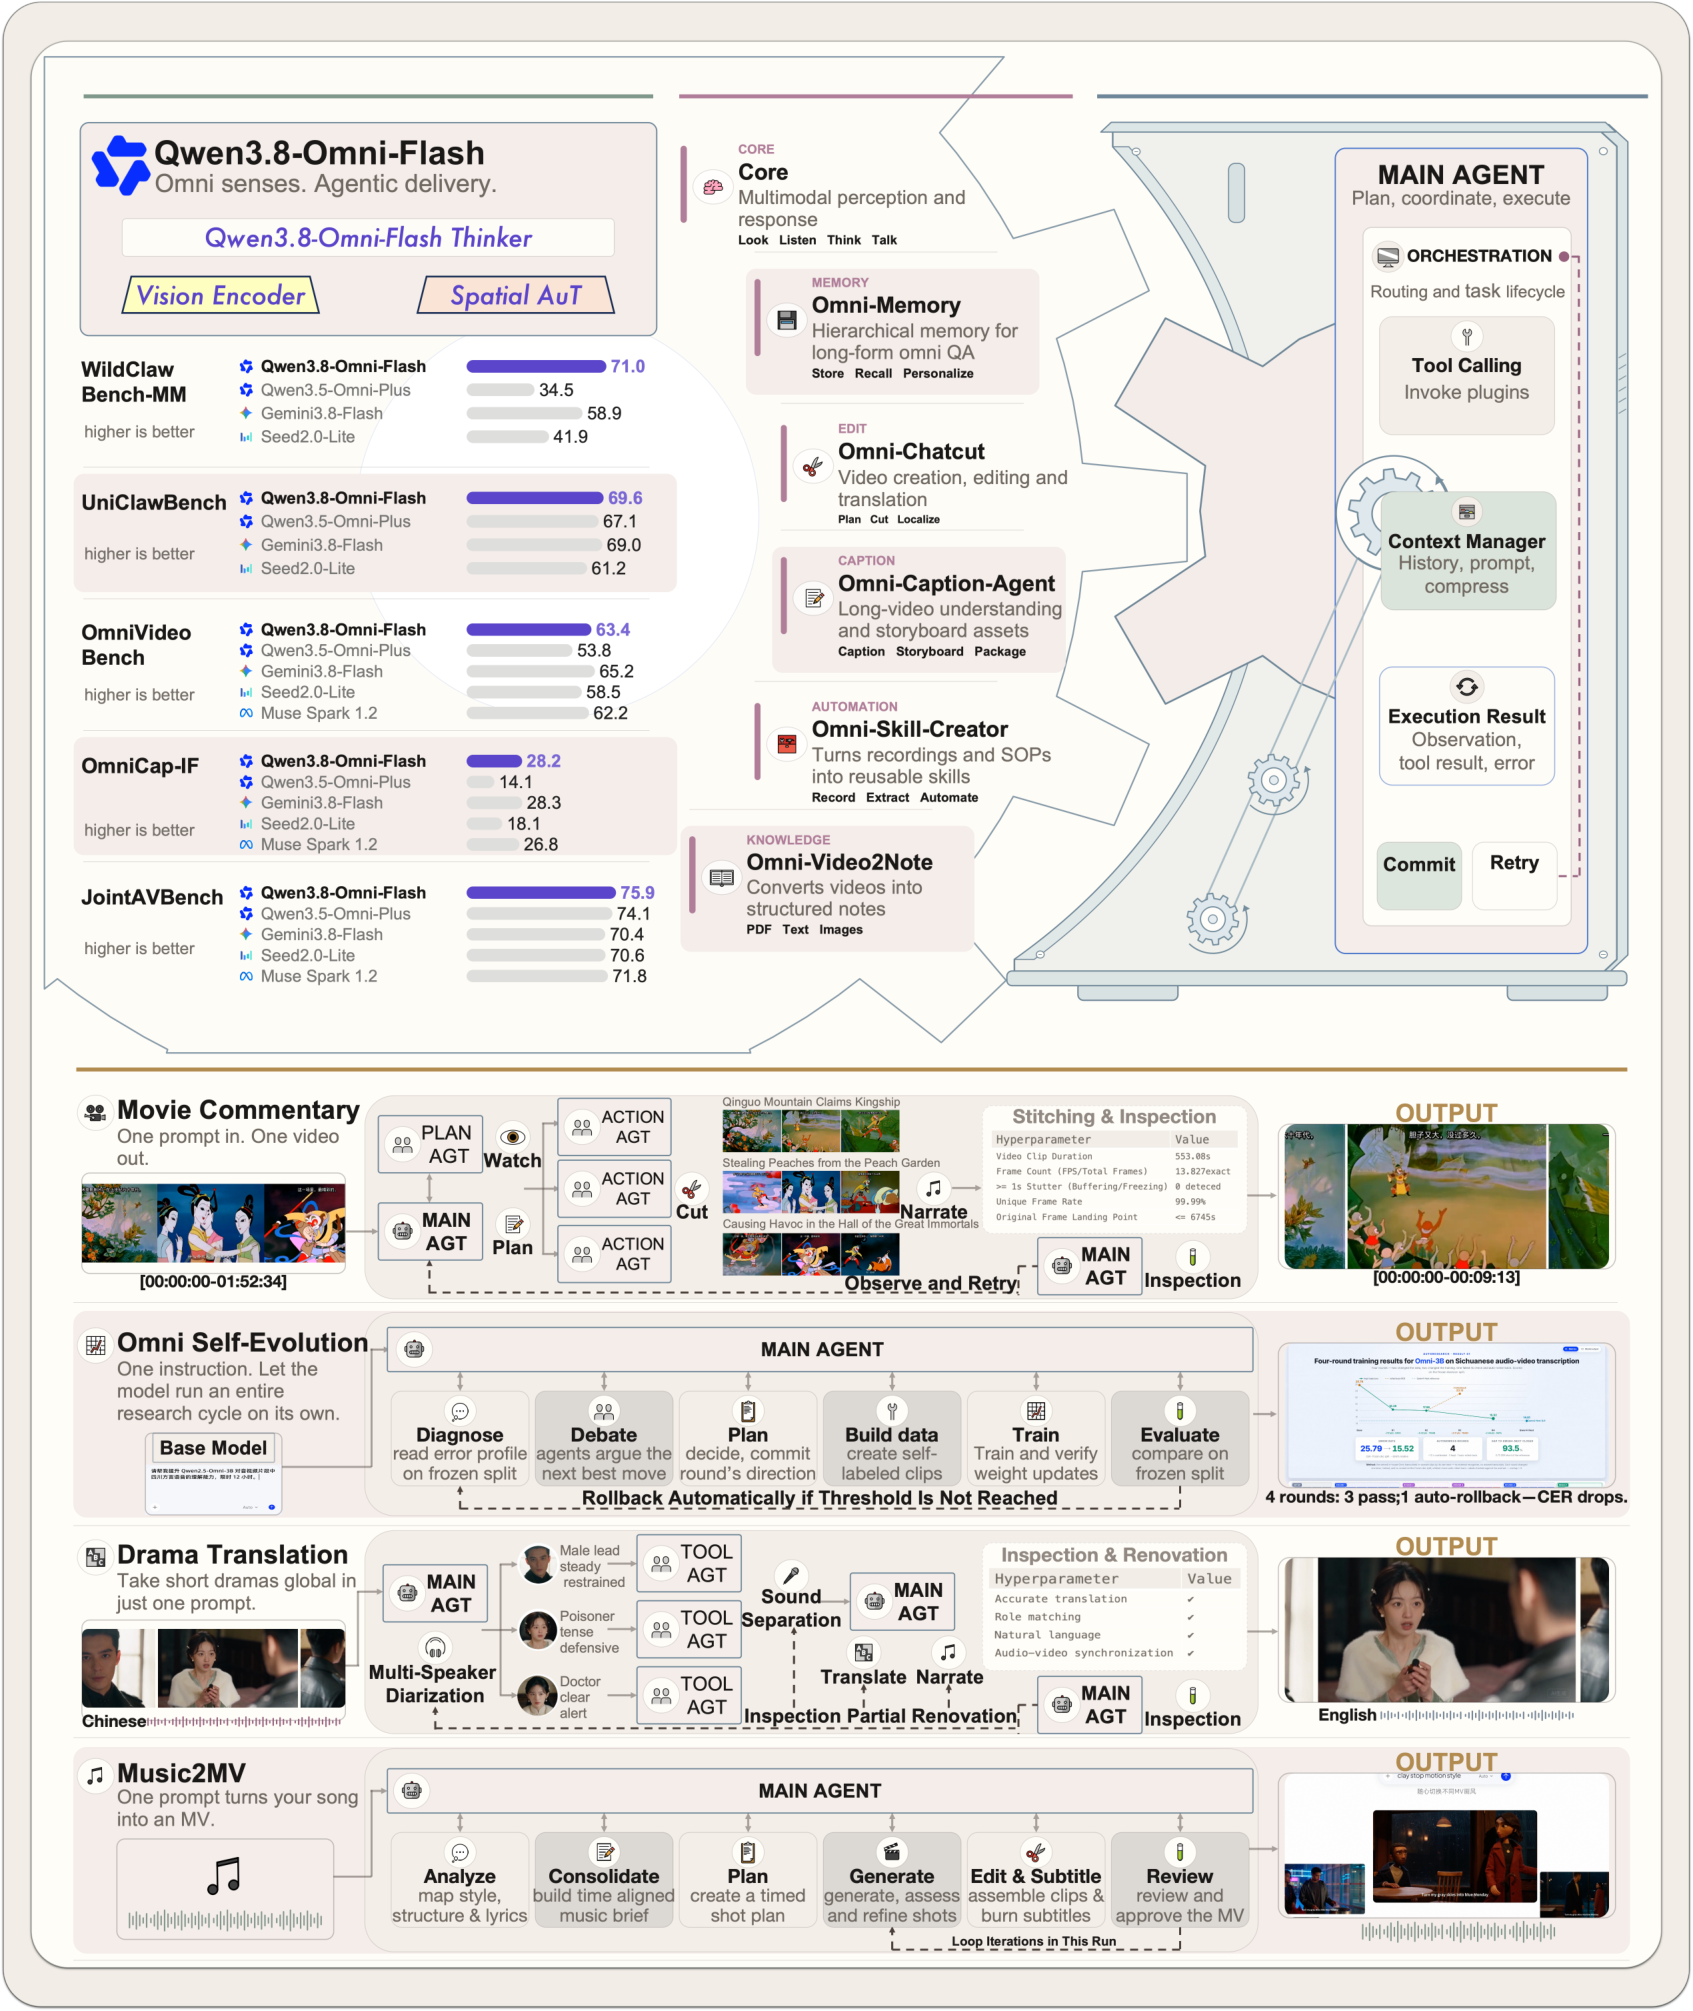
Мультимодальную модель научили планировать длинные задачи, вызывать инструменты и работать с текстом, изображениями, аудио и видео в едином процессе. В нерецензированном препринте, где все числа получили сами авторы, Qwen Team сообщает о приросте более 25% относительно Qwen3.5-Omni-Plus. Для разработки это сигнал, что аудио и видео переходят из отдельных распознавателей в основной контур агента.
Qwen3.8-Omni-Flash сводит входные данные разных типов в общую последовательность и сохраняет временные метки, чтобы связывать события в звуке и кадрах. Разреженная смесь экспертов выбирает для каждого фрагмента лишь часть специализированных блоков модели, а контекст на миллион токенов позволяет удерживать длинные записи и планы без постоянной нарезки на независимые запросы.
Модель дополняют два открытых проекта. Qwen-MM-Plugins превращает видео в подробные описания и структурированные заметки, загружает нужные фрагменты по запросу и собирает исполняемые навыки из видеоинструкций. Qwen-Live-Harness управляет контекстом, памятью, инструментами и передачей задач вспомогательным агентам в системах, которые отвечают в реальном времени.
Средний результат вырос более чем на 25% по 29 проверкам аудиорассуждений, работы с аудио и видео и агентных задач. Расчётные затраты API на входные данные относительно предшественника сократились более чем на 98% для аудио и на 93% для видео со звуком. Это оценка стоимости обработки входа, а не полная экономика приложения с генерацией, инструментами и хранением данных.
Проверки охватывают понимание и рассуждения по тексту, изображениям, аудио и видео, работу с интерфейсами, создание видеоматериалов и синтез речи. Модель сравнивали с Qwen3.5-Omni-Plus и профильными решениями других компаний; часть речевых наборов была внутренней. Практический вывод относится прежде всего к архитектуре: при выборе основы для мультимодального продукта теперь стоит оценивать не только качество модели, но и то, как она управляет памятью, выборочно читает длинные записи и передаёт работу инструментам.
Источники
Иллюстрация: рисунок из статьи «Qwen3.8-Omni: Towards Native Omni-Modal Agents», Qwen Team, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


