
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Очень длинный набор документов удалось обработать без перехода на более крупную языковую модель. В препринте University of Washington небольшие варианты Qwen3.5 с R3Con обошли все сравниваемые системы на модели с 35 млрд параметров; поскольку работа не прошла рецензирование, все числа получили сами авторы. Для таких продуктов это переносит главный архитектурный выбор с размера модели на способ подготовки контекста.
Почему найденных фрагментов недостаточно
Вопросы по большим архивам редко сводятся к поиску одного подходящего абзаца. Ответ приходится собирать из фрагментов, которые находятся в разных документах и обретают смысл только вместе.
Обычные системы заранее выбирают форму представления корпуса. Одни строят граф связей, другие сохраняют текстовую память, третьи создают дерево кратких изложений или выдают агенту инструменты поиска. Если такая форма отбросила малозаметную деталь, последующая модель уже не восстановит цепочку доказательств.
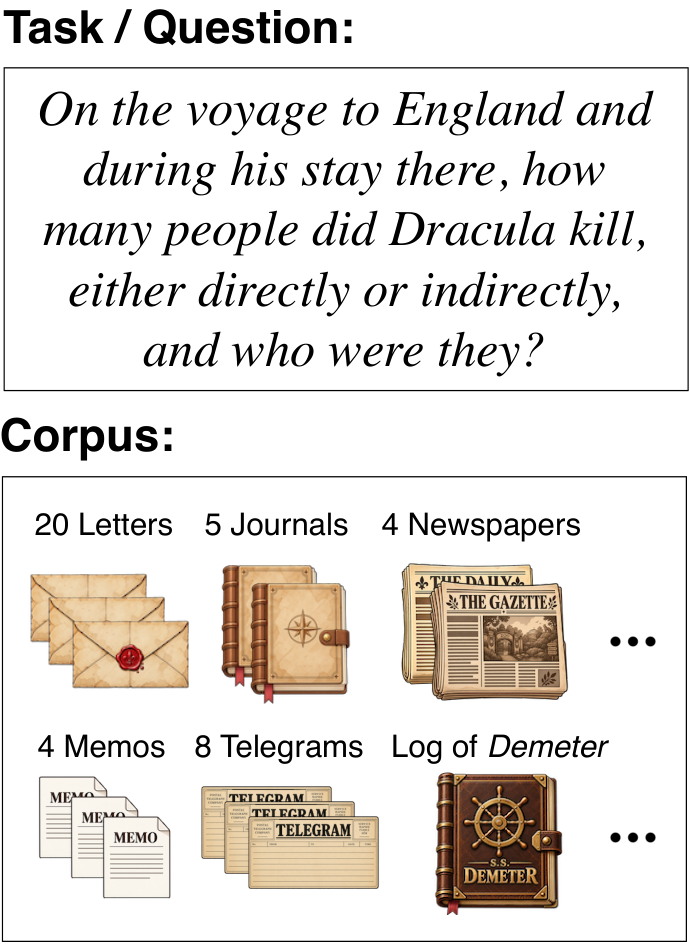
Работа показывает проблему на вопросе о жертвах Дракулы. Судовой журнал сообщает, что капитан собирается привязать себя к штурвалу, а отдельная газетная заметка описывает неопознанное тело у штурвала. Ни один фрагмент сам по себе не называет капитана очередной жертвой: системе нужно сопоставить их, а затем связать происшествие с описанием таинственного пассажира.
Фиксированный граф не создаёт связь, которой нет в тексте напрямую. Последовательная память со временем забывает ранние смерти, а локальный поиск по журналу не захватывает позднюю газетную заметку. R3Con возвращается к уже прочитанным документам после знакомства с остальным корпусом и поэтому может изменить оценку их важности.
Как R3Con пересобирает контекст под задачу
Сначала система несколько раз просматривает каждый документ. Модель получает вопрос, исходный текст и краткие выдержки из остальных документов, после чего заново формулирует, чем этот текст помогает ответу. Собственную выдержку из прошлого прохода ей не показывают, чтобы раннее и неполное толкование не закрепилось.
Затем модель выбирает структуру данных под конкретный вопрос. Это может быть таблица событий, иерархия компаний и отчётных периодов, граф отношений или вложенный список. Выбор не ограничен одной заранее заданной формой: состав полей и связей зависит от уже найденного релевантного контекста.
После этого R3Con снова обращается к исходным документам и заполняет структуру. Финальный агент получает краткие выдержки и доступ к структурированным данным через среду Python, поэтому может фильтровать записи, сопоставлять значения и проверять цепочки без помещения всего корпуса в контекстное окно.
Метод проверяли на CorpusQA и Loong. Первый набор требует собирать ответы по сотням взаимосвязанных документов, второй разделяет задачи на поиск, сравнение, группировку и соединение свидетельств. R3Con сравнили с графовыми системами, текстовой памятью, поиском по фрагментам и агентами с программными инструментами; долю правильных ответов определяла модель-оценщик gpt-5.4-mini.
На CorpusQA преимущество над сильнейшим способом сравнения составило 19,88 процентного пункта, на Loong — 8,42 пункта. R3Con с Qwen3.5-4B и Qwen3.5-9B также обошёл все проверенные варианты, использовавшие Qwen3.5-35B-A3B. Разрыв возник не из-за новой базовой модели: менялся слой, который отбирает, пересматривает и организует сведения до финального ответа.
Что менять в планах продукта
Для систем, которые анализируют договоры, отчёты, исследования или архивы обращений, работа даёт практический порядок прототипирования. До замены модели на более крупную стоит отдельно проверить три этапа: повторный отбор важных фрагментов, построение структуры под вопрос и программную обработку этой структуры.
Такой конвейер сложнее обычного поиска по смысловой близости. Он несколько раз вызывает модель, хранит промежуточные выдержки и строит новую схему для задачи. Зато команда получает явное представление контекста, которое можно просмотреть, исправить и проверить отдельно от ответа модели.
Экономический результат зависит не только от размера модели, но и от числа проходов по корпусу. В проведённом сравнении R3Con с Qwen3.5-35B-A3B оказался точнее Claude Code с Claude-Sonnet-5 и стоил примерно в 3,7 раза меньше. Это аргумент в пользу замера всего конвейера, а не цены одного вызова API.
Вывод относится к задачам, где свидетельства распределены по большому набору документов и требуют нескольких логических переходов. На этом классе задач представление контекста уже нельзя считать вспомогательным слоем вокруг LLM: результаты показывают, что оно может влиять на качество сильнее, чем переход к модели следующего размера.
Источники
Иллюстрация: рисунок из статьи «Realize What Matters: Principled Context Representation for Large-Scale Reasoning», Michael Theologitis, Dean Light, Shuyue Stella Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


