
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
В квантованных моделях для рассуждений научились находить токены, которые раздувают цепочку решения, и подавлять их без дообучения. RATIO оказался лучше фиксированных штрафов одновременно по доле правильных ответов и длине рассуждений; результат описан в препринте Chengzhu Bao и коллег, который не прошёл рецензирование и содержит замеры самих авторов. Команда может сохранить выбранный способ квантования и добавить отдельный этап калибровки перед выпуском модели.
Как находили лишние токены
Посттренировочное квантование (PTQ) хранит параметры уже обученной модели с меньшей точностью. Оно сокращает требования к памяти и вычисления на каждом шаге, но у моделей для рассуждений появляется встречный эффект: модель чаще колеблется, повторно проверяет выводы и генерирует больше текста.
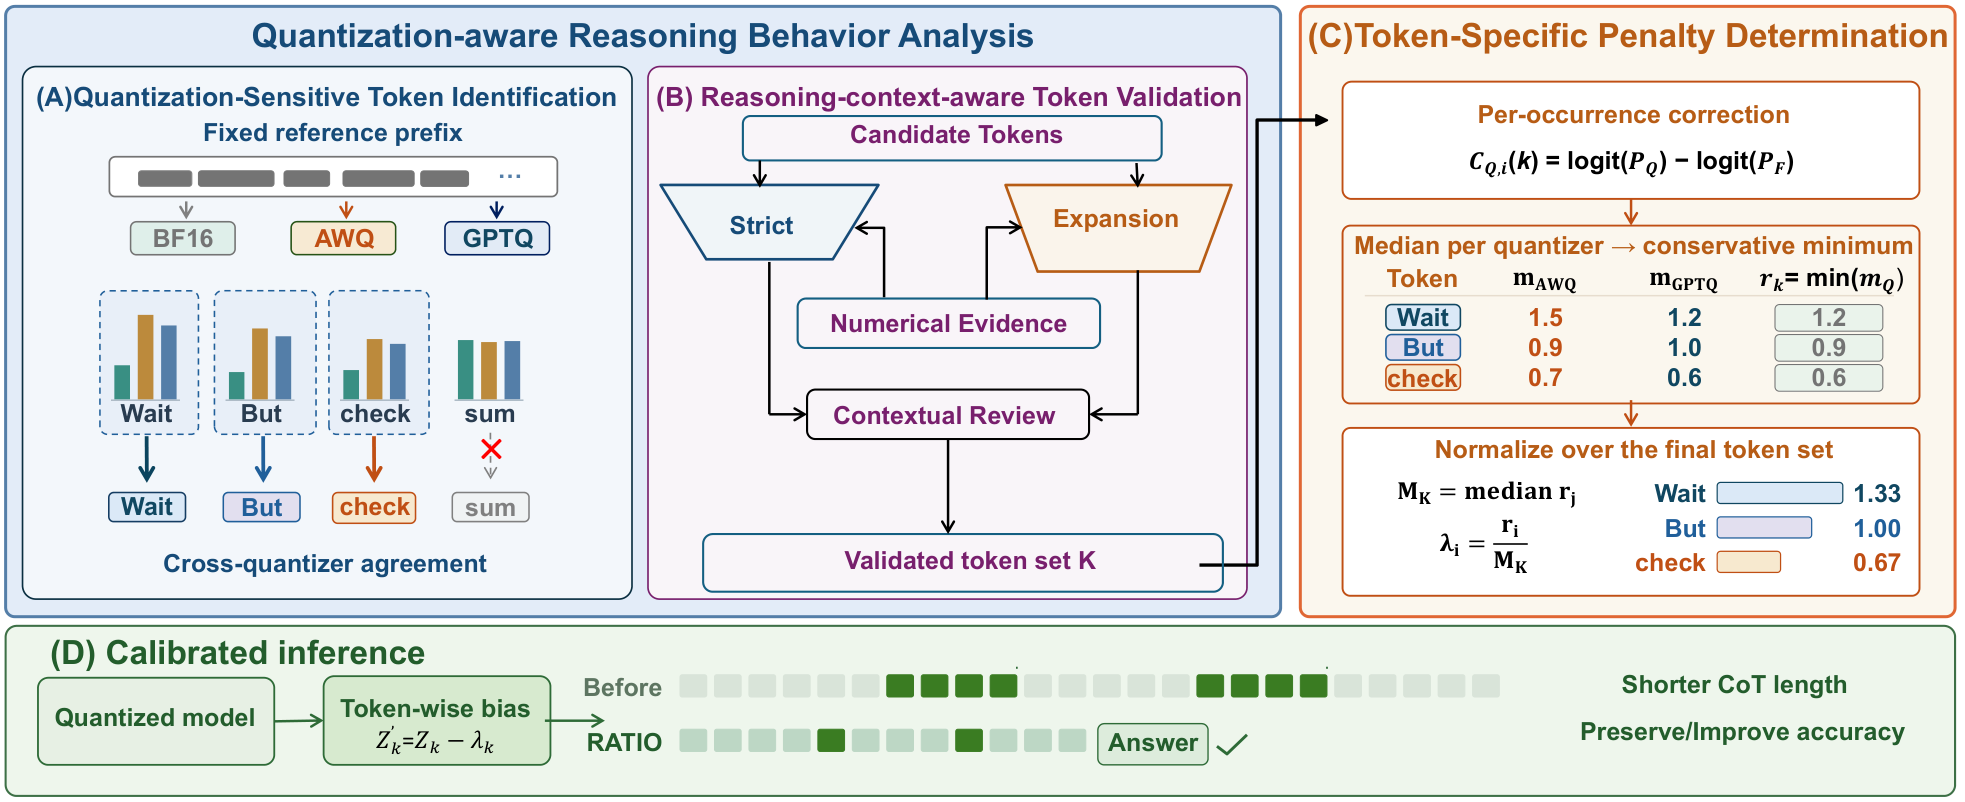
RATIO ищет не универсальные слова вроде «однако» или «проверим ещё раз», а отклонения конкретной модели после квантования. Токен здесь означает фрагмент текста, который модель выбирает на очередном шаге генерации.
Сначала полноточной и квантованной версиям дают одинаковые начала рассуждений. Модели не продолжают их свободно: на каждом шаге обе оценивают возможный следующий токен в одном и том же контексте. Это отделяет эффект квантования от различий, которые возникли бы из-за уже разошедшихся цепочек решения.
Для каждого токена RATIO сравнивает вероятности в полноточной модели и в вариантах, подготовленных с помощью AWQ и GPTQ. Кандидатом становится токен, вероятность которого устойчиво выросла при обоих способах квантования. Для Qwen-1.5B анализ оставил 21 такой токен, но сам по себе сдвиг вероятности ещё не означает бесполезное рассуждение.
Поэтому кандидатов проверяют на свободно сгенерированных ответах. RATIO смотрит, сохраняется ли сдвиг вероятности в реальных цепочках, чаще ли токен встречается в ошибочных ответах и связан ли он с повторами или явными циклами. Затем анализирует окружение токена, чтобы не принять полезную самопроверку за лишнее колебание.
Почему каждому токену нужен свой штраф
После отбора RATIO вычисляет отдельный штраф для каждого токена. Он берёт только случаи, когда квантованная модель предпочитает токен сильнее полноточной, и измеряет разницу в логитах — внутренних оценках, из которых модель получает вероятности.
Разовые выбросы отсекает медиана по всем появлениям токена. Затем метод выбирает более осторожную из поправок для AWQ и GPTQ и нормализует штрафы относительно всего найденного набора. Во время генерации система просто вычитает готовую поправку из оценки соответствующего токена.
Это отличие от прежнего лёгкого подхода, где заранее заданный список маркеров получал один общий штраф. Один токен может быть тесно связан с повторами, а другой — лишь изредка появляться рядом с ними. Одинаковое подавление либо не остановит первый, либо начнёт мешать полезным операциям со вторым.
На Qwen-1.5B с AWQ-W3 RATIO повысил среднюю долю правильных ответов на 9,78 процентного пункта и сократил цепочки рассуждений на 51,34%. При GPTQ метод также улучшил оба показателя, а варианты с универсальным списком токенов или единым штрафом дали менее устойчивый баланс.
Когда RATIO меняет план внедрения
Работу проверяли на трёх моделях семейства Qwen, включая варианты разного масштаба, с квантованием через AWQ и GPTQ. В набор задач вошли AIME, MATH и GSM8K для математики, GPQA для вопросов повышенной сложности и HumanEval для программирования. Основное сравнение проводили с квантованной моделью без вмешательства и методом, который штрафует заранее выбранные маркеры.
Для команды, которая уже квантирует модель рассуждений, RATIO добавляет к выпуску калибровочный прогон. В описанной схеме нужно сохранить доступ к полноточной версии, построить эталонные цепочки и подготовить варианты с обоими способами квантования. Дообучать параметры не требуется, а в рабочем контуре остаётся таблица статических поправок.
Переносить готовый список штрафов между моделями работа не предлагает. Именно модельный отбор токенов дал преимущество над универсальными маркерами, поэтому после смены основы, квантователя или режима рассуждений калибровку придётся повторить.
Проверять метод перед внедрением стоит на собственных задачах и вместе измерять качество ответа и число сгенерированных токенов. Статический штраф не учитывает текущий этап решения: один и тот же токен может обозначать как бесполезный повтор, так и нужное исправление. Авторы рассматривают штраф, который меняется по контексту, как следующий шаг, но в RATIO он пока остаётся постоянным.
Источники
Иллюстрация: рисунок из статьи «RATIO: Reasoning Analysis and Token-level Inference Optimization for Quantized Reasoning Models», Chengzhu Bao, Xianglong Yan, Tianao Zhang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


