
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
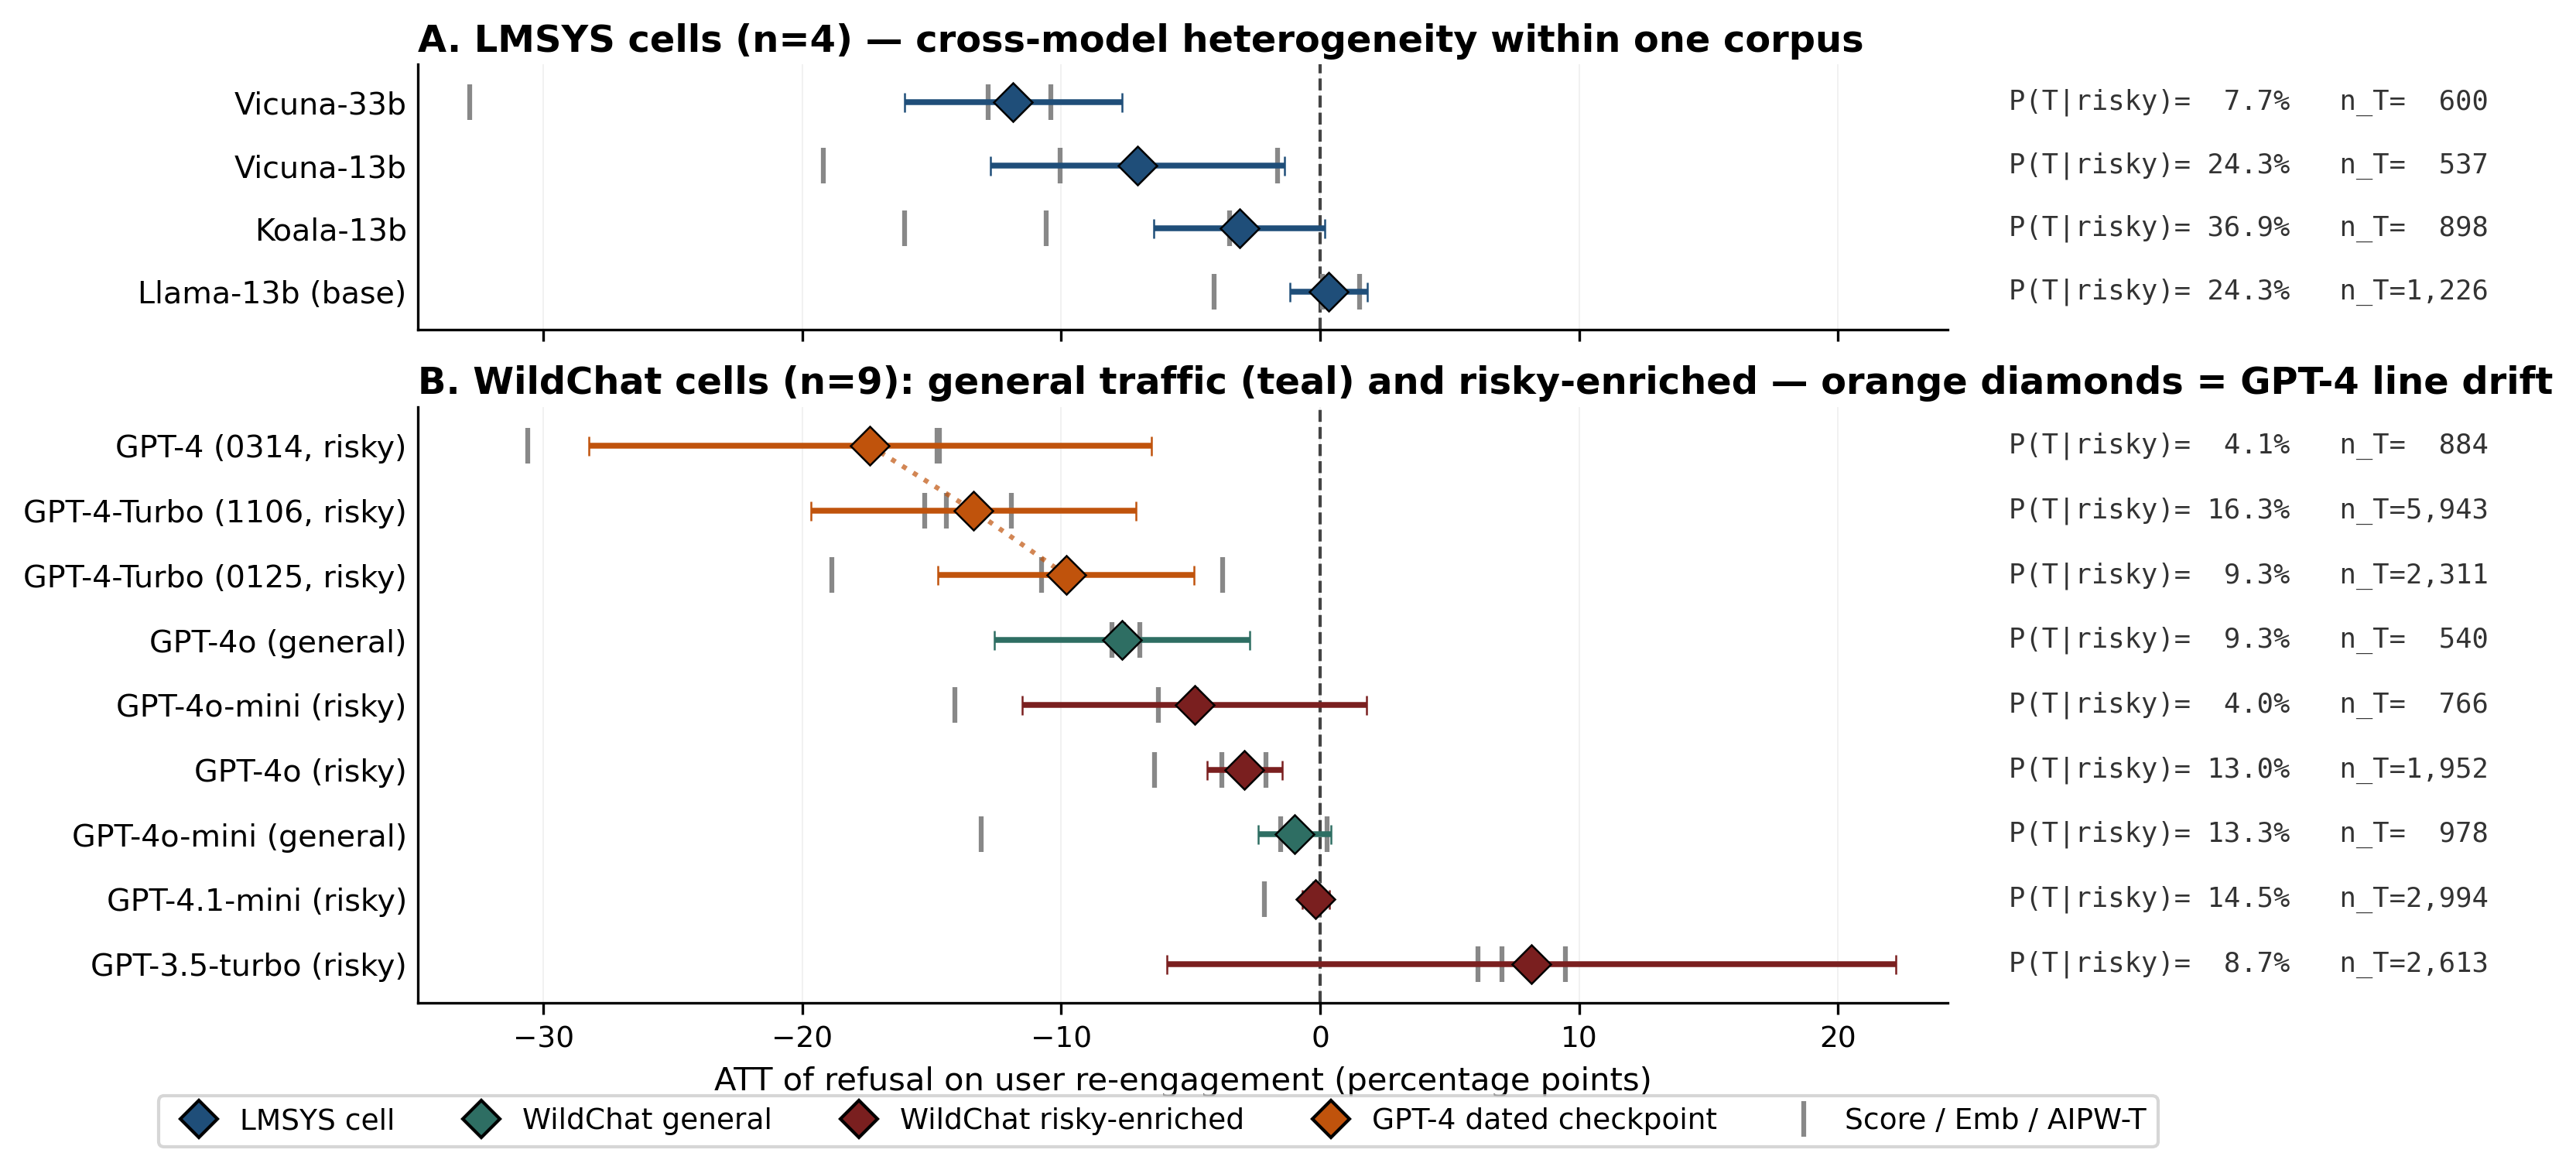
Цену отказа LLM для продолжения диалога научились оценивать по уже собранным рабочим логам. Pavel Kireyev из London School of Economics сообщает в препринте, который не прошёл рецензирование и содержит его собственные расчёты: отказ снижал вероятность следующей реплики пользователя на 3–17 процентных пунктов примерно у половины моделей с достаточно точной оценкой. Метод позволяет проверять правила отказа, даже если продукт работает через API и не может менять поведение модели для A/B-теста.
RAW находит близкие по смыслу запросы, на которые одна версия модели иногда отвечает, а иногда отказывает из-за случайности генерации. Метод сопоставляет содержание запроса и риск по оценке модерации, а затем сравнивает, продолжил ли пользователь разговор после первой реплики модели. Такое сравнение должно отделить влияние отказа от влияния самого запроса.
Эффект зависит не только от модели, но и от аудитории конкретного продукта. В остальных достаточно точных случаях разница оказалась в пределах погрешности. В одном развёртывании отказ даже формально повышал продолжение диалога: настойчивые пользователи повторяли отклонённый запрос, поэтому следующая реплика не всегда означала, что разговор развивается успешно.
Метод проверили на 15 развёрнутых моделях в LMSYS-Chat-1M и WildChat. Он применим к логам с фиксированной версией модели, случайной генерацией и достаточным числом похожих запросов, где встречаются оба исхода. RAW измеряет продолжение текущего разговора после отказа, а не долгосрочный отток или ценность пользователя; причинная трактовка также опирается на допущение, что учтённые признаки запроса не пропустили фактор, который влияет и на отказ, и на поведение пользователя.
Разметка отказов стоит около $0,30 на тысячу разговоров, отдельно потребуются вычисления для представления запросов и статистической оценки. Поэтому RAW подходит как диагностика перед изменением правил безопасности: команда может найти сегменты, где отказы действительно обрывают диалог, не ослабляя защиту ради эксперимента.
Источники
Иллюстрация: рисунок из статьи «RAW: Refusal Aversion in the Wild, A Causal Measurement Method for Deployed LLMs», Pavel Kireyev, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


