
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модели после обучения с подкреплением решают больше новых задач, если до него видят правильные решения с разными ходами рассуждения. В препринте Dylan Zhang, Mingyuan Wu и Jinning Li из University of Illinois Urbana-Champaign и Google, который не прошёл рецензирование и где все числа получили сами авторы, такой отбор повысил pass@8 модели OLMo3-7B на незнакомых ей средах на 16,9 процентного пункта. Для команд это превращает разнообразие цепочек решения в отдельный критерий сборки обучающего набора.
Почему одинаково правильные решения по-разному влияют на RL
Во многих конвейерах модель сначала проходит дообучение с учителем (SFT) на проверенных решениях, а затем обучение с подкреплением за правильный ответ. Первый этап задаёт, какие способы рассуждения модель сможет воспроизвести во время второго.
Обычный фильтр проверяет ответ, длину или оценку качества. Но два верных решения одной задачи могут повторять один и тот же путь либо использовать разные разбиения задачи, промежуточные проверки и обходные ходы. Работа рассматривает такую последовательность шагов как маршрут рассуждения.
Разница проявляется при групповом обучении с подкреплением. Для одного задания модель генерирует несколько ответов, после чего алгоритм сравнивает их награды. Если все ответы верны или все ошибочны, сравнение почти не даёт сигнала, который подсказывает, какое поведение усиливать.
Разнообразное SFT чаще оставляет модель в промежуточном состоянии: на одном задании она может получить и правильные, и неправильные ответы. Средняя точность перед RL при этом иногда ниже, но больше заданий помогают модели учиться.
Как маршруты сравнивают без другой модели
Для каждого решения строят числовой отпечаток. Он учитывает типы шагов, их частоту и положение, переходы между ними и общую форму цепочки. Если датасет содержит размеченные действия, правила читают их; в остальных случаях они разбирают текст решения.
Отпечаток не требует вызовов LLM, дополнительной генерации или расчёта градиентов. Его можно построить на CPU: в работе метод применяли к пулам, которые превышали два миллиона решений.
Дальше отпечатки группируют. Каждая группа получает долю общего бюджета, пропорциональную своему размеру, а внутри неё алгоритм последовательно выбирает решение, наиболее далёкое от уже отобранных. Контрольный вариант, напротив, берёт кандидатов рядом с центром плотной области и тем самым собирает похожие маршруты.
На RLVE разнообразная модель решила почти всё, что решил вариант с похожими маршрутами, и дополнительно покрыла 1 133 задания. Когда все кандидаты генерировала одна модель, преимущество достигало 6,2 пункта по доле задач, решённых хотя бы раз за восемь попыток. До RL смешанные результаты возникали на 54,7% заданий вместо 46,9%, что согласуется с объяснением через более частый обучающий сигнал.
На OpenThoughts3, INTELLECT-3 и Nemotron-Cascade 2 метод также превзошёл случайный отбор и варианты по близости текста, эмбеддингам, градиентам и упрощённой топологии во всех сравнениях средней оценки после RL. Это результат на уровне средних показателей: на отдельных бенчмарках встречались проигрыши.
Когда стоит менять конвейер подготовки данных
Работа меняет планы команд, которые уже генерируют несколько проверяемых решений, выбирают часть из них для SFT и затем запускают RL. Между проверкой ответа и сборкой обучающего набора можно добавить дешёвый этап отбора по маршрутам, не увеличивая число примеров и не привлекая несколько моделей-учителей.
Разнообразие не заменяет проверку правильности и покрытие типов задач. Практический порядок выглядит так: сначала удалить неверные ответы и сохранить нужные категории заданий, затем распределить оставшийся бюджет между различающимися маршрутами. Если для каждого задания существует только одно решение, выбирать разнообразие внутри него не из чего.
Проверки охватывают Qwen3 и OLMo3-7B, синтетические головоломки, математику и открытые корпуса рассуждений. Условия в парных экспериментах сохраняли одинаковые модели, бюджеты SFT, рецепты RL и этапы контрольной оценки; менялся состав решений. Главное сравнение OLMo3-7B проводили как одиночный запуск, поэтому размер эффекта лучше перепроверять на собственном наборе.
Для продуктов, которые заканчивают обучение на SFT или не могут автоматически проверить итоговый ответ, вывод уже не переносится напрямую. Исследование показывает преимущество именно в связке SFT и последующего RL с проверяемой наградой, а не универсальный способ улучшить любое дообучение.
Источники
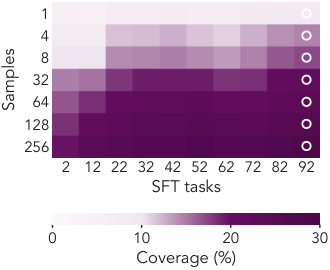
Иллюстрация: рисунок из статьи «Selecting Diverse SFT Traces Improves Post-RL Generalization», Dylan Zhang, Mingyuan Wu, Jinning Li, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


