
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Мультимодальную модель научили быстрее генерировать ответы, повторно используя её прежние прогнозы без обучения отдельной вспомогательной модели. В препринте, который не прошёл рецензирование и содержит замеры самих авторов, Recap обошёл лучший из сравненных способов без обучения на обеих проверенных моделях. Для последовательной генерации это кандидат на ускорение без замены целевой модели, но не готовый расчёт производительности пакетного сервиса.
Почему одного последнего токена недостаточно
При спекулятивном декодировании (speculative decoding) система заранее предлагает несколько следующих токенов, а целевая модель проверяет их за один проход. Если предложение совпадает с её собственным выбором, система подтверждает сразу часть последовательности и сокращает число последовательных запусков модели.
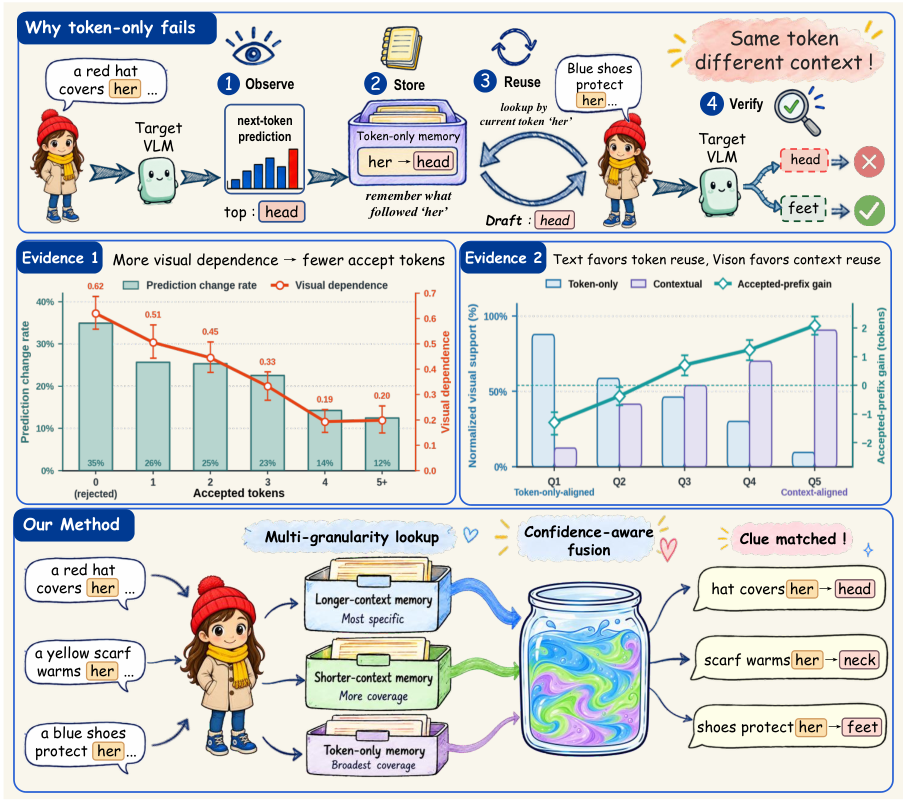
Отдельную модель для предложений обучать необязательно. Во время проверки целевая модель уже рассчитывает вероятности продолжений во всех узлах дерева кандидатов, хотя затем использует лишь одну ветвь. Token Recycling сохраняет эти расчёты и позднее ищет продолжение по последнему токену.
Для мультимодальной модели такой ключ слишком грубый. Один и тот же токен может появиться после разных фраз и изображений: продолжение после слов о надписи на вывеске зависит от конкретного изображения, а не только от последнего слова. В диагностике работы полностью отклонённые предложения чаще совпадали с состояниями, где замена изображения меняла следующий токен.
Более длинный ключ точнее различает контексты, но встречается реже. Recap поэтому хранит прогнозы на трёх уровнях: по последнему токену, а также по коротким последовательностям длиной до трёх токенов. Память одиночных токенов сохраняется между запросами, а более контекстные записи живут только внутри текущего запроса и тем самым остаются связаны с его изображением.
Как Recap собирает и проверяет дерево кандидатов
Когда доступно несколько записей, Recap не выбирает автоматически самую длинную. Система назначает больший исходный вес более точному ключу, а затем учитывает энтропию прогноза: если вероятность сосредоточена на небольшом числе продолжений, такой источник получает больше веса. Рассеянный прогноз влияет слабее, даже если найден по более длинному контексту.
После смешивания система оставляет наиболее вероятные токены и строит дерево поиском сначала по лучшим вариантам. На каждом следующем узле она снова обращается к памяти уже с учётом предложенной ветви. Дополнительные продолжения берутся из совпадающих фрагментов запроса и ранее подтверждённого ответа.
Целевая модель проверяет всё дерево одним упакованным проходом. Она подтверждает самую длинную совпавшую ветвь и сама выбирает следующий токен; если ни один кандидат не подошёл, генерация продолжается обычным способом. Поэтому Recap не меняет результат жадного декодирования, а сокращает число последовательных проходов, необходимых для его получения.
Прогнозы из всех проверенных узлов обновляют память, включая ветви, которые модель не выбрала. Это позволяет повторно использовать расчёт, если позднее встретится совместимый контекст, но только подтверждённые токены попадают в историю ответа.
Когда результаты меняют планы по инфраструктуре
Коэффициент ускорения здесь означает отношение пропускной способности генерации к обычному авторегрессионному декодированию. На Qwen2.5-VL-7B Recap показал 1,66 против 1,51 у Token Recycling, а на LLaVA-1.6-7B — 1,56 против 1,37. На MMSpec преимущество сохранилось и для категории с диалогами в несколько ходов.
Основной выигрыш дала сама структура памяти: контекстные ключи повышали точность совпадений, а откат к короткому ключу сохранял охват. Взвешивание по уверенности добавило около 1% пропускной способности в отдельной проверке. Это важная инженерная граница результата: сложная формула смешивания полезна, но не она объясняет большую часть ускорения.
Метод проверяли на двух моделях с изображениями, жадной генерацией, единичным размером пакета и GPU NVIDIA A100. Основные замеры охватывали семь наборов однократных запросов, а MMSpec добавлял диалоги. Такой режим близок к сервисам визуальных вопросов, распознавания текста и анализа диаграмм, но не отвечает на вопрос о производительности при пакетной обработке и конкурентных запросах.
Для команды без ресурсов на обучение и сопровождение вспомогательной модели Recap упрощает эксперимент: нужны доступ к распределениям целевой модели, собственный цикл генерации, дерево проверки и память прогнозов. Менять веса модели или готовить отдельный набор данных не требуется.
Постоянная память делает декодер состоянием сервиса, а не полностью независимой функцией запроса. В многопользовательской системе её придётся разделять по выбранной границе изоляции и очищать при переходе между областями, которые не должны обмениваться следами запросов.
Планы по последовательному обслуживанию мультимодальной модели работа меняет достаточно, чтобы включить Recap в нагрузочный тест рядом с Token Recycling. Планы по ёмкости пакетного сервиса менять рано: сначала нужно измерить ускорение на реальном распределении длины ответов, параллелизме и используемом оборудовании. Работа оценивает скорость генерации, а не прикладное качество ответов.
Источники
Иллюстрация: рисунок из статьи «RECAP: Context-Aware Prediction Recycling with Request-Local and Persistent Memories for Multimodal Speculative Decoding», Hengjie Zhu, Dayan Wu, Xinze Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


