
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель можно научить убирать повторения и тупиковые ветви из рассуждения, не вырезая шаги, от которых зависит ответ. В препринте George Mason University и Amazon, который не прошёл рецензирование, а приведённые числа получили сами авторы, метод RECAP сократил ответы Qwen2.5-Math-7B до 31% относительно GRPO. Для команд это способ снизить расход токенов на инференсе через обучение, а не через жёсткий лимит длины ответа.
Как RECAP отличает опорный шаг от лишнего
GRPO обучает модель по результату целой попытки. Для одной задачи он создаёт группу решений, сравнивает их награды и усиливает удачные последовательности, но внутри каждой последовательности назначает всем токенам одинаковый сигнал.
Из-за этого правильный вывод, повторная проверка и брошенная ветвь закрепляются вместе. Штраф за длину решает проблему грубо: он подталкивает модель писать меньше, но не указывает, какие части решения можно убрать безопасно.
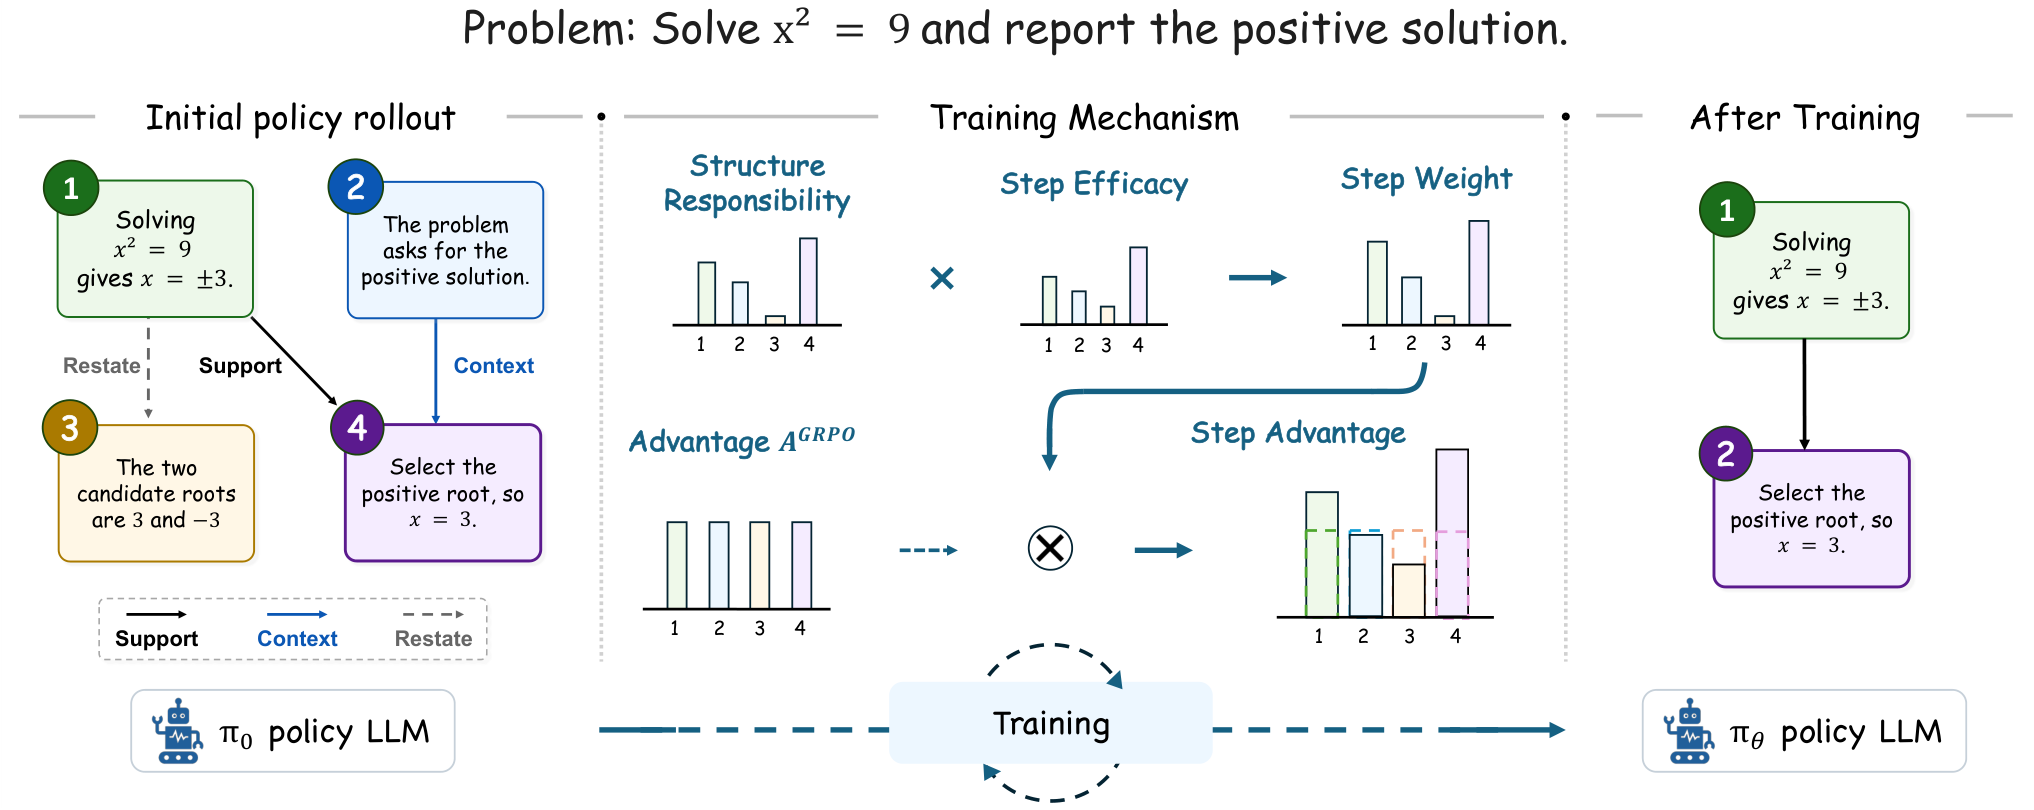
RECAP сначала делит рассуждение на шаги и превращает их в направленный граф зависимостей. Отдельная LLM отмечает связи трёх типов: следующий шаг опирается на предыдущий, использует его как контекст или просто повторяет уже известное. Шаги, которые не ведут к финальному ответу, остаются в боковых ветвях.
Затем метод распространяет ответственность назад от ответа. Опорная связь получает полный вес, контекстная — частичный, а повторение не передаёт вес. Поэтому ранний вывод может получить сильный сигнал, если на нём держится дальнейшее решение, даже когда между ними находится несколько промежуточных операций.
Одного графа недостаточно: последовательная цепочка может вести к неверному результату. RECAP отдельно измеряет полезность шага по тому, как после его добавления меняется логарифмическая вероятность эталонного ответа. Рост означает, что шаг приблизил модель к решению, снижение — что увёл в сторону.
Оба сигнала меняют исходную награду GRPO для каждого шага. В удачных решениях модель сильнее закрепляет полезные опорные действия и слабее — повторы. В неудачных попытках она не штрафует одинаково всё рассуждение: полезные промежуточные выводы сохраняются, а шаги, которые поддержали ошибочную ветвь, получают больший штраф.
Сокращение происходит за счёт тупиков, а не плотного текста
На Qwen2.5-Math-7B доля задач, решённых с первой попытки, выросла на 2,0–3,7 процентного пункта относительно GRPO на всех проверенных наборах. Значит, экономию токенов получили не обменом точности на краткость.
Анализ структуры ответов показывает, откуда взялась разница. В зависимости от модели-оценщика около 6% шагов RECAP не имели пути к финальному ответу, тогда как у GRPO доля таких тупиков составляла примерно 20–25%. Метод также уменьшил число предложений, уравнений и отдельных операций, а расход токенов на одну операцию существенно не изменился.
Иными словами, модель не стала упаковывать прежнее длинное решение в более плотные фразы. Она выполняла меньше действий, реже начинала бесполезные ветви и меньше повторяла уже полученные результаты.
Когда RECAP меняет план обучения модели
Метод проверяли на двух моделях размера 7B и четырёх наборах математических задач. Основное сравнение — с GRPO, а также с обучением через штраф за длину, сжатием цепочек и другими способами назначать награду отдельным шагам. Работа показывает результат в математике с проверяемым эталонным ответом, поэтому перенос на код, диалоги и открытые аналитические задачи из этих экспериментов не следует.
RECAP не требует заранее собирать короткие образцовые решения или обучать отдельную модель награды за процесс. Это упрощает подготовку данных, если команда уже обучает модель через GRPO и располагает задачами с правильными ответами.
Дополнительная цена возникает во время обучения. Для каждого нового рассуждения нужно выделить шаги, построить связи между ними с помощью LLM и несколько раз оценить вероятность эталонного ответа. Значит, RECAP стоит рассматривать не как бесплатную замену GRPO, а как обмен более тяжёлого обучения на более короткие ответы при последующем использовании модели.
Планы имеет смысл менять командам, у которых стоимость длинных рассуждений заметна в масштабе продукта и которые дообучают собственную модель. Если модель доступна только через чужой API, применить RECAP к ней напрямую нельзя. Для собственного контура практический следующий шаг — сравнить метод со штрафом за длину на реальном распределении задач и считать одновременно точность, токены ответа и затраты на обучение.
Источники
Иллюстрация: рисунок из статьи «Giving Credit Where It's Due: Redundancy-Aware Learning for Efficient Reasoning», Yuqing Zhou, Hong Wang, Manqing Mao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


