
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
RECAST научилась собирать основание для ответа из разрозненных источников, даже когда готового фрагмента для поиска в них нет. Хотя препринт не рецензирован и все числа получили сами авторы, система обошла сильнейшее крупное базовое решение на 15,9 процентного пункта. Для продуктовой команды это переносит узкое место RAG с выбора поисковика на проектирование конвейера, который умеет считать, фильтровать и соединять данные.
Маршрутизатор выбирает между поиском, SQL и новым кодом
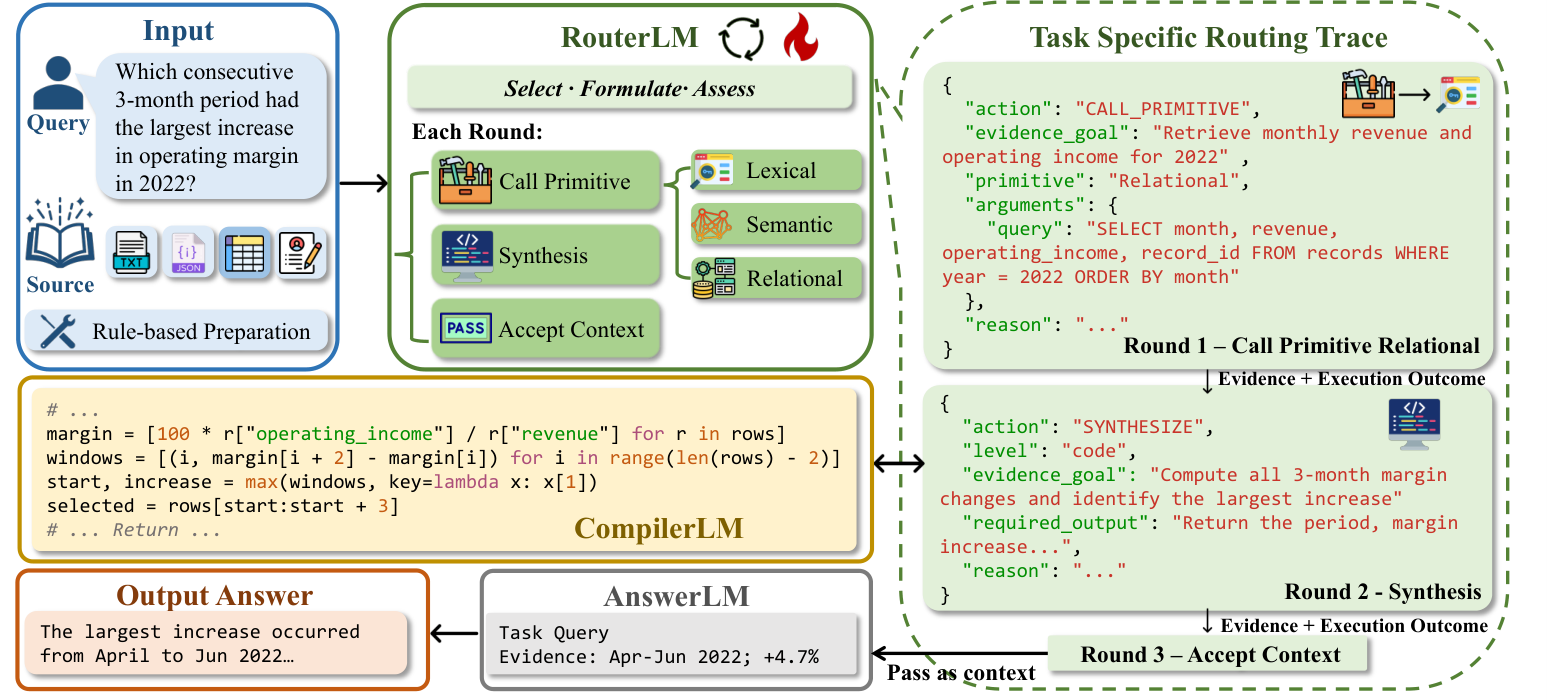
Обычная RAG-система предполагает, что нужный факт уже есть в одном из документов. Это не работает для вопроса о периоде с максимальным ростом операционной маржи: система должна найти выручку и прибыль за разные месяцы, вычислить показатели, сравнить изменения и только затем передать результат модели.
RECAST отделяет построение такого контекста от подготовки финального ответа. Сначала обычный программный обработчик приводит документы, таблицы, записи JSON и профили пользователей к единому списку записей. Он также составляет краткое описание структуры источника, чтобы языковой модели не приходилось читать его целиком.
Затем RouterLM получает задачу, описание источника, уже найденные данные и историю предыдущих действий. На каждом шаге он выбирает лексический поиск BM25, семантический поиск через BGE-M3, запрос SQL к нормализованным записям или создание новой операции. SQL поддерживает фильтрацию, соединение таблиц, группировку, сортировку и арифметику.
Если этих средств недостаточно, RouterLM описывает требуемое преобразование. Замороженная CompilerLM превращает описание в программу на Python и запускает её над источником. Примечательная деталь: CompilerLM не видит исходный вопрос, поэтому маршрутизатор должен сам сохранить в задании все существенные условия.
После каждого вызова RouterLM получает найденные данные, число совпадений, состояние выполнения и ошибки. Он может уточнить запрос, сменить операцию или признать контекст достаточным. Только после этого замороженная AnswerLM вызывается один раз и формирует ответ.
Обучение меняет не модели, а последовательность действий
Авторы обучали только RouterLM на базе Qwen3.5-9B. CompilerLM и AnswerLM оставались неизменными, а поисковые и реляционные операции выполнялись обычным кодом. Это позволяет улучшать поведение системы без дообучения модели, которая пишет программы или отвечает пользователю.
Сначала для вопросов собирали несколько полных траекторий: последовательностей операций, промежуточных результатов и финального ответа. Модель-оценщик сопоставляла ответ с эталоном, после чего успешные и корректно выполненные траектории использовали для обучения с учителем. Затем маршрутизатор дополнительно обучали по относительной награде: для одного вопроса сравнивали удачные и неудачные способы собрать контекст.
Без обучения полный набор поисковых и вычислительных операций давал среднюю долю успеха 64,1%, а после двух этапов — 75,6%. Если награда учитывала только правильность ответа и не поощряла частично верный результат и корректную структуру действий, показатель снижался до 68,9%.
Проверка охватила DataBench, FinQA, HiTab, HotpotQA, LaMP и MultiHiertt: таблицы данных, финансовые отчёты, иерархические таблицы, коллекции текстов и пользовательские профили. На не использованных при обучении 2WikiMultiHopQA, TAT-QA и WikiTableQuestions RECAST получила 79,3% против 64,3% у сильнейшего базового решения. Успех означал, что замороженная модель-оценщик признала ответ правильным при сравнении с эталоном.
Когда архитектуру продукта стоит пересмотреть
Работа меняет планы систем, где ответ нельзя извлечь одним поисковым запросом. К таким задачам относятся расчёты по финансовым периодам, соединение записей из разных таблиц, выбор элементов по нескольким условиям и агрегация истории пользователя. Здесь отдельный обучаемый маршрутизатор может заменить набор вручную написанных ветвлений между поиском, SQL и кодом.
RECAST при этом не выглядит готовой заменой существующего RAG-конвейера. Для неё нужно нормализовать источники, реализовать несколько исполнителей операций, собирать полные траектории и иметь проверяемые эталонные ответы для обучения. Сгенерированные программы также придётся запускать изолированно, а запросы к рабочим данным ограничивать правами на чтение.
Для прямого поиска фактов такая схема добавит лишние вызовы моделей. Авторы прямо отмечают, что последовательные обращения к RouterLM и периодическая генерация кода повышают задержку и вычислительные расходы относительно однопроходного поиска. Поэтому маршрутизацию разумно включать только для классов запросов, где обычный поиск систематически возвращает релевантные документы, но не даёт готового основания для ответа.
Практический вывод касается границы между RAG и агентом. Если продукт уже содержит таблицы, документы и вычислительные инструменты, полезнее учить небольшую модель выбирать и проверять операции, чем поручать одной крупной модели одновременно искать данные, писать код и отвечать. Работа показывает результат на вопросах с проверяемым эталоном; перенос на процессы с неоднозначным итогом потребует другого сигнала для обучения и оценки.
Источники
Иллюстрация: рисунок из статьи «RECAST: Learning to Compute the Right Context through Adaptive Evidence Routing», Yilun Hao, Krishna Sayana, Isabella Ye и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


