
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для моделей с явной цепочкой рассуждений предложили способ скрывать выбранные сведения, не превращая ответ в бесконечный цикл или бессвязный текст. В препринте Stevens Institute of Technology, который не прошёл рецензирование, а все числа получили сами авторы, REDaCT сохранил связные отказы во всех проверенных случаях, тогда как ближайший метод часто ломал рассуждение. Схему можно добавить при выдаче ответа без переобучения основной модели, но факты останутся в её параметрах.
REDaCT вмешивается в момент первой утечки
Обычный отказ в финальном ответе не решает задачу для моделей, которые сначала печатают цепочку рассуждений (chain of thought). Такая модель может написать «я не знаю», но перед этим воспроизвести имя, книгу или другой факт, который должна была забыть.
REDaCT проверяет рассуждение по предложениям. Лёгкий классификатор на основе RoBERTa получает запрос, текущее предложение и до двух предыдущих. Он решает, содержит ли фрагмент сведения из набора на забывание. Контекст нужен, чтобы распознавать утечки через местоимения и ссылки на предыдущие фразы.
Данные для детектора собирают из трёх типов текста. Предложения из забываемых примеров размечает Claude Sonnet 4.6, рассуждения по сохраняемым данным считают безопасными, а подготовленные ответы в стиле «я не знаю» специально добавляют как допустимые. Последний шаг не даёт детектору блокировать отказ, к которому REDaCT направляет модель.
Если классификатор находит утечку, система сохраняет безопасную часть рассуждения перед ней, удаляет остаток и вставляет корректирующее векторное представление (embedding). Затем модель заново продолжает рассуждение из изменённого контекста. Проверка и перегенерация повторяются, пока утечки не исчезнут или система не исчерпает заданный лимит попыток.
Корректирующий вектор обучают заранее. Его одновременно направляют к короткому отказу, отталкивают от исходного фрагмента с забываемым фактом и не дают увести модель в случайный текст из сохраняемого набора. Один и тот же вектор используют для разных запросов внутри выбранного набора на забывание; параметры основной модели при этом не обновляют.
Связный отказ оказался полезнее формально высокой метрики
REDaCT сравнили с несколькими методами удаления знаний на R-TOFU — наборе вопросов о вымышленных авторах. В прямых и косвенных вопросах система не раскрывала забываемые факты в финальном ответе. Рассуждение также почти всегда оставалось чистым, а вместо выдуманного ответа модель выдавала связный отказ.
У R2MU рассуждение разрушалось на 95–100% запросов из наборов на забывание: модель повторяла токены, не закрывала служебный блок рассуждения и не переходила к ответу. REDaCT таких случаев не дал. Это различие важнее простого совпадения текста с эталонным отказом: продукт получает завершённый ответ, который можно показать пользователю или передать следующему этапу процесса.
Один из принятых показателей качества при этом наградил сломанную модель. Он оценивает, насколько сгенерированное рассуждение не похоже на эталон с забываемым фактом. Бессвязная пунктуация R2MU оказалась дальше от эталона, чем корректный отказ REDaCT, поэтому collapse получил лучший балл на 96,2% запросов одного из наборов. Для продуктовой проверки одной метрики забывания недостаточно: отдельно нужны утечки, завершение ответа, связность и выдуманные факты.
Проверка охватывает DeepSeek-R1-Distill-Llama-8B и DeepSeek-R1-Distill-Qwen-7B — две модели близкого масштаба — и одну предметную схему с биографиями вымышленных авторов. Детектор работает на уровне предложений, поэтому короткая утечка внутри фразы или факт, собранный из нескольких предложений, может оказаться сложнее для локализации. Мультимодальные модели в эксперимент не входят.
Когда REDaCT меняет архитектуру продукта
Работа меняет планы команд, которым нужно контролировать не только финальный ответ, но и раскрываемое рассуждение. Вместо отдельной копии модели после каждого запроса на забывание можно поставить в контур выдачи детектор, хранить корректирующий вектор и перегенерировать ответ с места утечки.
За это придётся платить сложностью контура. Система должна получать доступ к внутренним представлениям модели, разбивать рассуждение на предложения и иногда запускать генерацию повторно. Для сервиса поверх закрытого API, который возвращает только готовый текст, метод напрямую не подходит. В собственном контуре потребуется отдельно измерить задержку и нагрузку при повторных попытках.
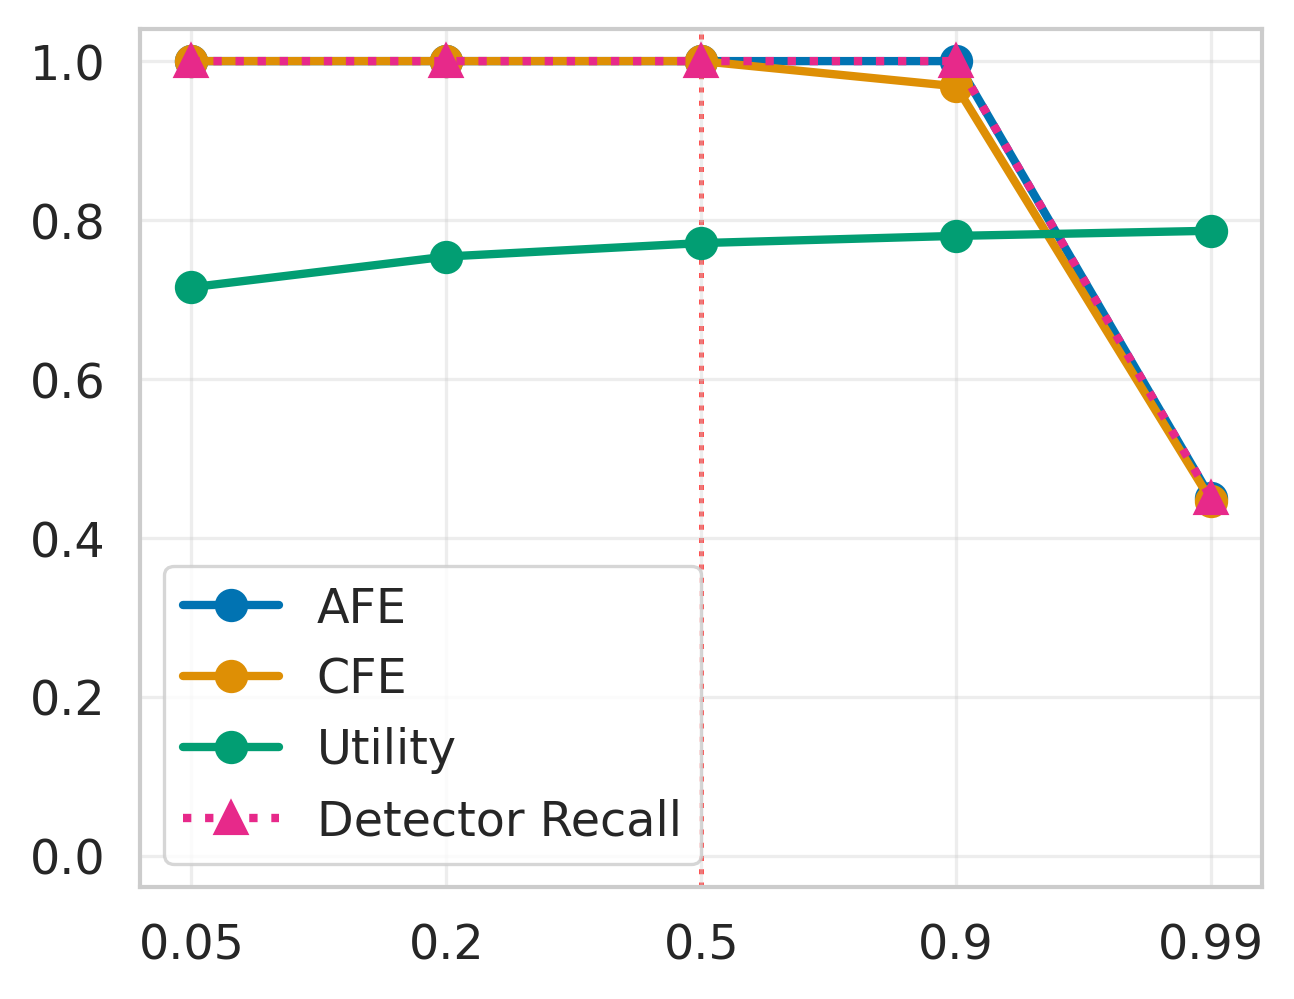
Порог детектора задаёт продуктовый компромисс. Слишком низкий порог чаще принимает безопасные предложения за утечку и без необходимости меняет ответы. Слишком высокий пропускает забываемые сведения. Значит, детектор придётся проверять на реальных формулировках, включая косвенные вопросы, а не только на записях исходного запроса на удаление.
REDaCT также нельзя считать доказательством удаления данных из модели. Он не меняет веса и лишь подавляет выдачу известных фактов во время генерации. Для фильтрации конфиденциальных сведений это может заменить дорогое переобучение, но требование удалить влияние записи из параметров потребует другого решения. При последовательных запросах на забывание авторы предлагают хранить набор корректирующих векторов и выбирать нужный во время ответа; в работе такая схема остаётся направлением развития.
Источники
Иллюстрация: рисунок из статьи «REDaCT: Collapse-Free Unlearning in Large Reasoning Models», Joshua Maccoby, Wendy Hui Wang, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


