
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Дообучение модели на сообщениях сообщества меняет не только сходство ответа с принятыми советами, но и сам набор способов поддержки: практические рекомендации начинают вытеснять эмоциональные. В препринте Georgia Institute of Technology и Magic Hour, который не прошёл рецензирование и где числа получили сами авторы, соответствие стратегий у моделей общего назначения выросло более чем на 50%. Для продуктовой команды это аргумент оценивать не только среднее качество после дообучения, но и то, какие виды помощи модель стала предлагать чаще.
COPES сравнивает модель с нормами сообщества, а не с клиническим эталоном
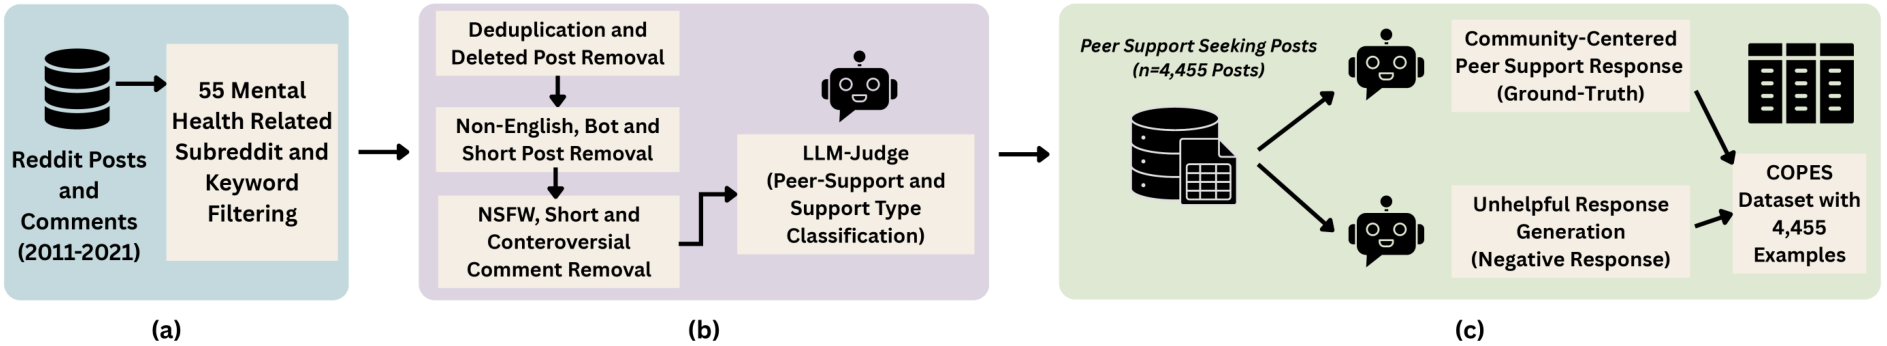
Авторы собрали COPES из 4 455 публикаций в сообществах Reddit о психическом здоровье. Исходные обсуждения относятся к 2011–2021 годам и охватывают темы травмы, тревоги, компульсивных расстройств, терапии и расстройств настроения.
В набор попали публикации, где человек искал не клинический диагноз, а поддержку, личный опыт или совет. GPT-4.1 разметила запросы по четырём видам помощи: практические действия для решения проблемы, эмоциональное самоуспокоение, поиск смысла и обращение к другим людям.
Эталонный ответ не копировали из одного комментария. GPT-4.1 сводила несколько положительно оценённых комментариев в цельный текст, удаляла повторы и сохраняла стиль взаимной поддержки. Для обучения на предпочтениях та же модель создавала неудачный вариант ответа с обесцениванием эмоций, неуместным оптимизмом или другим нежелательным поведением.
Поэтому COPES измеряет близость к отобранным нормам Reddit, а не медицинскую корректность. Даже «предпочтительный» ответ здесь остаётся машинным пересказом комментариев, а положительная оценка сообщества служит лишь косвенным признаком полезности.
Как измеряли совпадение советов
Проверяли Qwen 3-4B Instruct, Gemma-4-E4B и MediPhi-Instruct — три небольшие модели примерно по четыре миллиарда параметров. Для каждой сравнили ответы без примеров, обучение с учителем (SFT) и его сочетание с прямой оптимизацией предпочтений (DPO).
Главная метрика показывает, насколько рекомендации модели совпадают с советами из похожих обсуждений того же типа. Длинный ответ сначала разбивали на отдельные действия: например, обратиться к близкому человеку, изменить распорядок или использовать технику самоуспокоения. Затем действия сопоставляли по смыслу через векторные представления; совпадение засчитывали при косинусном сходстве не ниже 0,8.
Две дополнительные метрики проверяли, не противоречат ли рекомендации друг другу и насколько эмоции и тон ответа похожи на эталон. Это разделяет три свойства, которые одна итоговая оценка обычно смешивает: содержание совета, связность действий и манеру разговора.
Средний рост скрывает перекос между видами поддержки
После дообучения соответствие стратегий у Qwen выросло примерно на 60%, у Gemma — на 55%. Медицинская MediPhi начинала с более сильной позиции и прибавила лишь 4,5%. Лучший результат всё равно означал совпадение примерно половины рекомендаций, поэтому рост относительно слабой исходной версии не равен готовности к эксплуатации.
Самый большой выигрыш получили запросы, где человек пытался найти смысл в пережитом: улучшение доходило до 74%. Но эффект зависел и от конкретного сообщества. Одни группы запросов после дообучения получали более подходящие стратегии, другие сохраняли заметно худшие результаты.
Без дообучения модели отвечали довольно однообразно: предлагали самоуспокоение и переосмысление почти независимо от ситуации. COPES сделал ответы чувствительнее к контексту, но одновременно сдвинул распределение в сторону практического решения проблем и подавил эмоциональные стратегии. Дополнительная оптимизация предпочтений после обычного дообучения почти не улучшила основные результаты.
Эта работа меняет планы команд скорее на уровне проверки продукта, чем выбора базовой модели. Средняя оценка после дообучения должна дополняться срезами по аудиториям, типам запроса и долям разных стратегий: иначе улучшение общей метрики скроет исчезновение нужного вида поддержки.
Проверка охватывала небольшие модели с открытыми весами, неclinical peer-support, отвеченные ветки фиксированного набора сообществ и два способа дообучения. COPES стоит использовать как исследовательский ориентир для норм сообщества, но не как доказательство безопасности или эффективности помощи: для реального сервиса всё ещё нужны клиническая проверка, распознавание кризисных ситуаций, передача случая человеку и оценка с участием затронутых групп.
Источники
Иллюстрация: рисунок из статьи «Aligning with Lived Experience: Heterogeneous Benefits of Fine Tuning in Mental Health Support Generation», Mohit Chandra, Nabin Kim, Eli Min и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


