Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Защиту отказов LLM нельзя надёжно привязать к найденным слоям: при дообучении атака переносит повреждение выше замороженной области. В препринте, который не прошёл рецензирование и приводит замеры самих авторов, заморозка выбранных слоёв не сохранила отказ ни на одной из проверенных версий моделей. Такая защита может смягчить случайное загрязнение данных, но не выдерживает атакующего, который знает её устройство.
Как нашли слои, в которых возвращается отказ
Авторы сначала проверили, перестаёт ли модель отличать вредоносные запросы от безопасных. Они обучили линейный классификатор на внутренних состояниях исходной модели, а затем без изменений применили его к модели после вредоносного дообучения.
Классификатор продолжал разделять два типа запросов, хотя модель уже не отказывалась выполнять опасные инструкции. Значит, внутреннее представление запроса сохранило полезный сигнал, но верхние части модели перестали превращать его в отказ. При этом фиксированный порог классификатора работал хуже из-за общего сдвига оценок: высокая разделимость сама по себе ещё не даёт готового детектора.
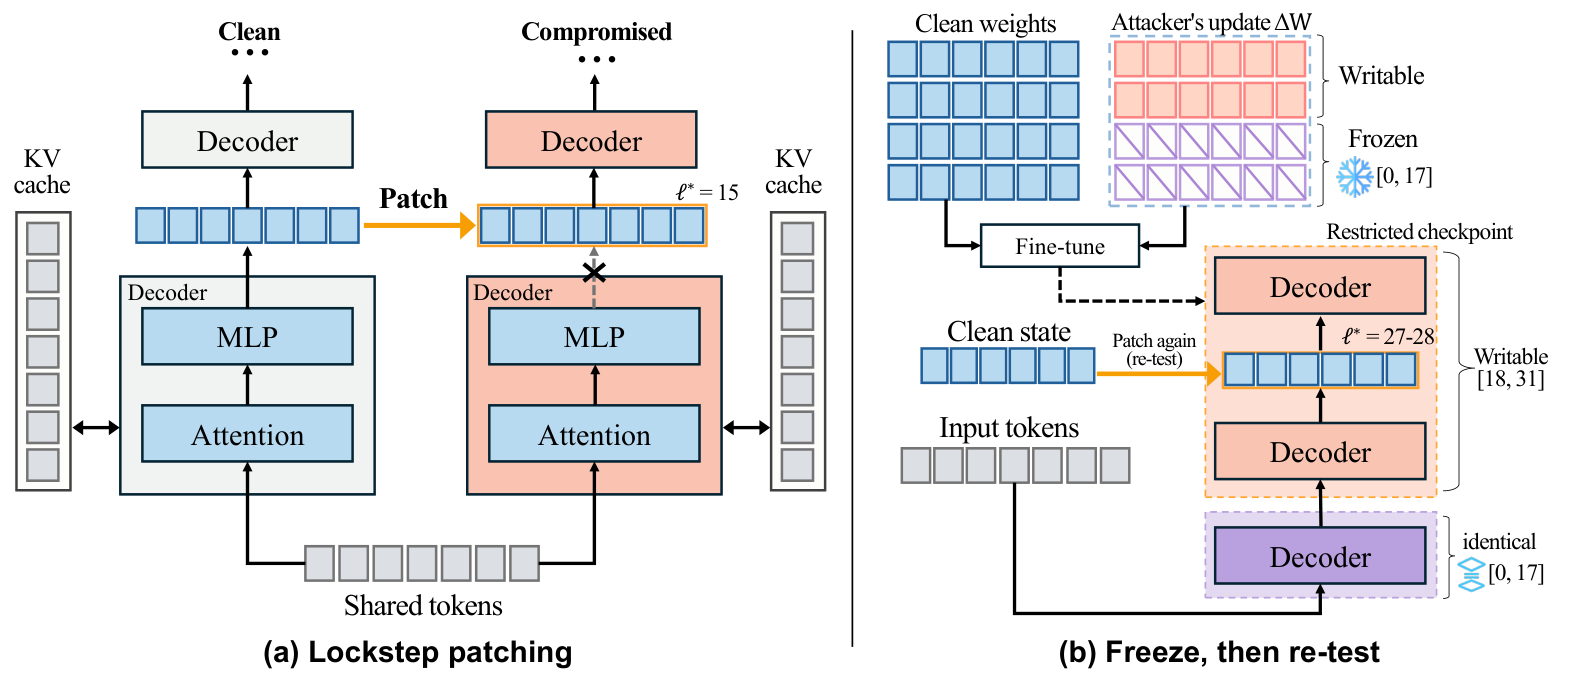
Затем авторы запускали исходную и повреждённую модели на одинаковых токенах. На выбранном слое они заменяли всё скрытое состояние повреждённой модели состоянием чистой — как при обработке запроса, так и при генерации каждого следующего токена. Если после такой подмены отказ возвращался, этот слой считали границей, после которой чистого состояния уже достаточно для безопасного ответа.
Восстановление происходило не постепенно, а резким переходом на определённой глубине. Подмена состоянием от постороннего безопасного запроса не давала того же эффекта, поэтому результат нельзя объяснить простой перезагрузкой внутренних активаций.
Проверка охватила шесть версий моделей из семейств Llama, OLMo, Qwen и Yi размером от 7 до 14 млрд параметров. Их дообучали через LoRA на наборах от пяти до ста вредоносных примеров, а поведение проверяли на AdvBench и XSTest-safe. Авторы отдельно считали явные отказы и безопасные ответы: модель может выдать предупреждение или уклончивый текст, который классификатор безопасности примет, хотя формального отказа в нём нет.
Почему заморозка и спектральный ремонт не удержали защиту
Найденная граница выглядела естественным местом для защиты: можно запретить обновлять все слои до неё и разрешить дообучение только выше. Но атакующий повторно обучал модель с учётом этого ограничения. На Llama слои 0–17 оставались неизменными, а граница восстановления отказа переместилась к слоям 27–28.
То же произошло на остальных проверенных версиях. Заморозка иногда снижала долю ответов, которые Llama-Guard считал опасными, но явный отказ не возвращала. Контрольный опыт, где блокировали такое же количество слоёв с другого конца модели, показал, что важна позиция заморозки, а не только сокращение доступных параметров.
Второй способ защиты работал уже с обновлением весов. Авторы раскладывали его на направления и удаляли два направления, в которых было сосредоточено больше всего изменений. После короткого дообучения только проекций внимания такой ремонт восстановил отказ на четырёх версиях моделей.
Результат не пережил изменения условий обучения. Более длинное обучение и обновление дополнительных проекций ослабили ремонт. Адаптивная атака распределила изменения между направлениями так, что удаление ведущих компонентов перестало помогать.
Спектральный детектор тоже не решил проблему. Его настроили на безопасных дообучениях Llama, однако он отметил лишь 3 из 14 случаев, когда ремонт не восстановил отказ. Большинство пропусков дали обычные варианты обучения, а не специально замаскированная атака.
Что меняется в планах команд, которые дообучают LLM
Работа не отменяет локализацию внутренних механизмов. Она показывает более узкую границу: слой, где поведение можно восстановить подменой состояния, необязательно подходит для блокировки весов. Диагностический эксперимент отвечает на вопрос, где сейчас возникает отказ, но не доказывает, что модель не научится обходить это место.
Заморозка остаётся полезной при случайном попадании вредоносных данных. На небольшой дозе она помогала нескольким моделям, в том числе при пяти вредоносных примерах, но к сотне защита переставала удерживать отказ. Поэтому её стоит рассматривать как ограничитель ущерба при загрязнении набора, а не как границу безопасности против пользователя, который управляет данными дообучения.
Для сервисов с управляемым дообучением это означает, что запрета на изменение выбранных слоёв недостаточно. Для открытых весов такая мера ещё слабее: атакующий сам выбирает доступные параметры. Спектральная очистка обновления также требует проверки на разных длительностях обучения, наборах проекций и способах распределить изменение между направлениями.
Авторы предлагают пять практических проверок защиты: сообщить атакующему её устройство; измерить рабочий диапазон по объёму вредоносных данных; проверить ложные отказы на безопасных запросах; сравнить метод с контролем, который удаляет такой же объём обновления без специального правила; дать защитнику наблюдаемый сигнал, по которому можно заранее понять, сработает ли ремонт.
Главное изменение для плана разработки — перенос критерия приёмки с локализации на адаптивную проверку. Найденный слой или направление можно использовать как гипотезу для защиты, но выпускать механизм стоит только после атаки, которая заранее знает эту гипотезу и может изменить обучение под неё.
Источники
Иллюстрация: рисунок из статьи «Refusal Localizes, the Damage Relocates: Safety Layers Under Few-Sample Fine-Tuning», Jungseob Lee, Dongyub Jude Lee, Sugyeong Eo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.