
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили сохранять несколько правильных способов решения, а не сводить ответы к одному привычному варианту. Хотя препринт не рецензирован и числа получили сами авторы, Re:Max одновременно повысил точность и разнообразие ответов по сравнению с обычным обучением. Для продуктов с поиском кандидатов и повторным ранжированием это меняет сам критерий обучения: одной точности недостаточно.
ModeBench отделяет правильность от разнообразия
Обучение с подкреплением по проверяемой награде (RLVR) обычно оценивает только итог. Если два ответа проходят автоматическую проверку, модель получает одинаковую награду, даже когда один вариант встречается постоянно, а второй предлагает другой путь.
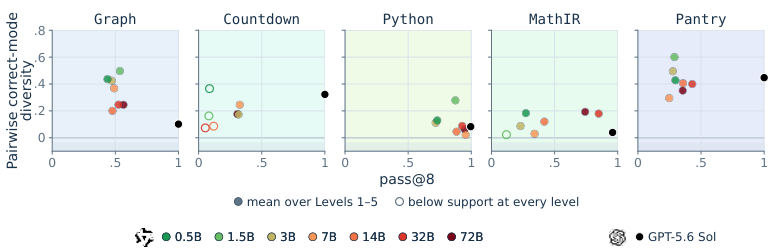
Чтобы увидеть потерю вариантов, авторы собрали ModeBench. Он охватывает раскраску графов, арифметическую игру Countdown, алгебраические преобразования MathIR, исполняемый Python и планирование PantryPlan. Для каждой задачи проверяющая программа сообщает не только правильность, но и режим решения — конкретный ответ или путь, который привёл к нему.
Определение режима зависит от предметной области. В Graph две допустимые раскраски считаются разными решениями. В Countdown и MathIR различаться должен путь вычисления, даже если конечное число совпадает. Поэтому перестановка слов не создаёт искусственного разнообразия, а для группировки не нужна отдельная модель-оценщик.
Главная метрика ModeBench — попарное разнообразие правильных режимов, PCMD. Она показывает вероятность того, что два правильных ответа относятся к разным режимам. Нулевое значение означает, что модель всегда выбирает один вариант; значение 1/2 получается, когда вероятность равномерно разделена между двумя вариантами.
PCMD считают отдельно от pass@8 — шанса получить хотя бы один правильный ответ из восьми попыток. Такое разделение важно: модель может чаще проходить проверку, но всё реже предлагать альтернативные решения. Обычная метрика точности этого не покажет.
Равная награда запускает цикл «победитель забирает всё»
Сужение возникает не потому, что проверяющая программа предпочитает определённый ответ. Во время обучения модель чаще генерирует уже вероятный вариант, чаще получает на нём награду и ещё сильнее повышает его вероятность. Редкий правильный способ постепенно перестаёт попадать в новые выборки, поэтому почти не влияет на обновление весов.
Простое увеличение числа попыток не всегда возвращает потерянные варианты. На ModeBench кривые разнообразия выравнивались даже при 512 ответах на задачу. У проверенных передовых моделей оставалось менее 1,5 эффективного режима при задачах, где могло существовать до 355 допустимых решений.
Re:Max разрывает этот цикл с помощью буфера повторения. Когда модель впервые находит новый правильный режим, система сохраняет один проверенный пример. Последующие копии того же режима ничего не добавляют, а все сохранённые варианты повторяются с одинаковым весом независимо от того, как часто модель генерирует их сама.
Обучение идёт по двум путям. MaxRL продолжает работать со свежими ответами модели, а отдельное обновление возвращает в обучение ранее найденные решения. Буфер не меняет награду и не подмешивает сохранённые ответы в проверку: итоговые замеры проводят на отложенных заданиях.
Повторение повысило и pass@8, и PCMD на трёх масштабах моделей и с разными целями RLVR. В сводном сравнении по всем предметным областям методы с равномерным буфером обошли восемь альтернатив по сочетанию правильности и разнообразия. Частотное повторение работало хуже: оно снова давало преимущество режимам, которые и без того встречались чаще.
Когда буфер стоит добавить в план продукта
Работа меняет планы команд, которым нужны несколько пригодных кандидатов: например, для последующего ранжирования, восстановления после отклонения одного варианта или выбора между разными планами. Если продукт принимает первый прошедший проверку ответ и альтернативы не дают пользы, обычной точности может быть достаточно.
Первый практический шаг — научить проверяющую систему возвращать идентификатор режима вместе с вердиктом. Без этого нельзя отличить новый способ от переформулировки старого. Подход проще применить к коду, планам с формальными ограничениями и задачам с исполняемой проверкой, чем к открытым текстовым ответам, где различия приходится оценивать семантически.
Второй шаг — измерять PCMD рядом с точностью ещё до изменения обучения. Если разнообразие не падает или не связано с продуктовой ценностью, буфер добавит хранение и отдельные обновления без очевидной отдачи. Если редкие правильные режимы исчезают, равномерное повторение даёт прямой способ удержать их без увеличения числа свежих генераций.
Проверка охватила Qwen2.5-0.5B, Falcon3-1B и Qwen2.5-3B на пяти исполняемых типах задач; более трудные варианты подробно изучали на самой маленькой модели. Размещённые у провайдеров модели проверяли только в режиме генерации, поэтому работа не показывает, как Re:Max повлияет на их закрытые процессы обучения.
Число режимов также не говорит, полезны ли они в продукте. Два формально допустимых фрагмента кода могут различаться по стоимости, скорости или риску. Поэтому разнообразие стоит учитывать вместе с правильностью, долей непрошедших проверку ответов и прикладной оценкой каждого варианта.
Источники
Иллюстрация: рисунок из статьи «Measuring and Mitigating Solution Mode Collapse in RLVR», Liv G. d'Aliberti, Marwa Abdulhai, Sofiia Druchyna и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


