
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Зрительно-языковые модели часто распознают, что изображение не содержит ответа, но всё равно выдумывают его. В работе The Hong Kong University of Science and Technology (Guangzhou), которая пока не рецензирована и все числа в ней получены самими авторами, доля правильных отказов составила в среднем 11,4% у открытых моделей и 16,3% у закрытых. Значит, одной способности оценить изображение недостаточно: решение об отказе нужно отдельно связывать с генерацией ответа.
VAD-R убирает подсказки, которые выдают неразрешимый вопрос
Обычный тест на отказ часто прямо просит модель выбрать между вариантами «можно ответить» и «нельзя ответить». Такой формат измеряет ответ на подсказку, а не способность самостоятельно остановиться во время обычного диалога.
В датасете также могут оставаться обходные признаки. Например, в TUBench неразрешимые вопросы создавали, удаляя ячейки из таблиц. Классификатор мог определить нужный класс только по изображению с точностью выше 99%, даже не видя вопроса. Модель училась замечать следы обработки картинки, а не искать недостающие доказательства.
Для нового бенчмарка VAD-R авторы взяли естественные фотографии из DOCCI и подготовили 1852 пары изображения и вопроса. Половина вопросов разрешима, а в остальных нужная деталь отсутствует, неразличима или не подтверждается изображением. У каждого примера есть пошаговое объяснение; неразрешимые вопросы дополнительно размечены по шести типам пробелов в доказательствах.
Сначала вопросы фильтровали с помощью классификатора, который видел только текст и искал языковые подсказки. Затем другая модель сверяла оставшиеся вопросы с изображениями. При итоговой проверке модель получает только фотографию и вопрос: отдельного варианта «ответа нет» в запросе не показывают.
На VAD-R проверили восемь открытых и три закрытые модели. Ответы оценивала Qwen3.6-27B: она определяла, ответила ли модель по существу или отказалась. Поэтому результат зависит не только от проверяемой модели, но и от модели-оценщика, хотя для части экспериментов авторы также разбирали содержание ответа.
Сигнал о нехватке данных появляется до начала ответа
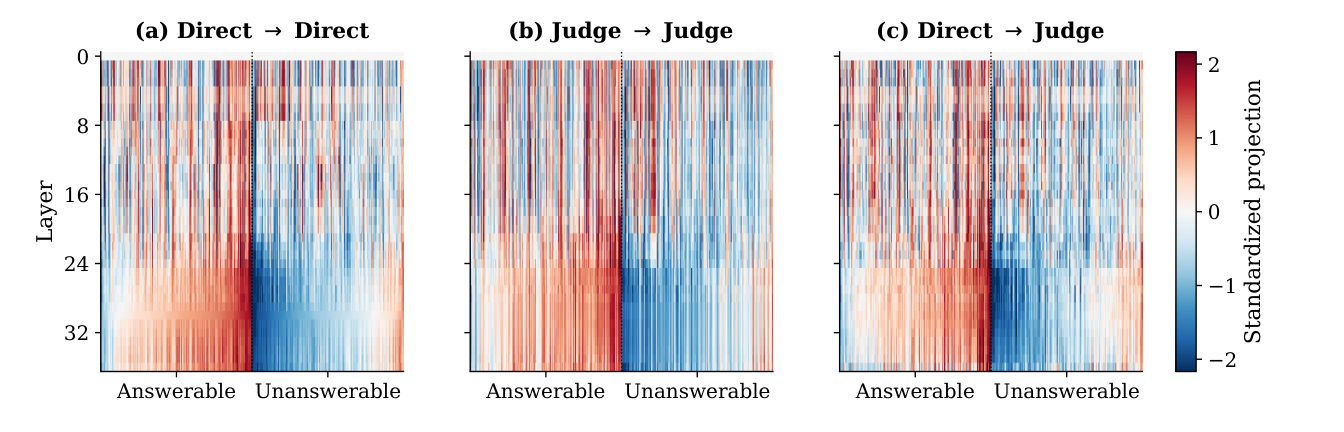
Авторы извлекали внутренние представления из разных слоёв Qwen2.5-VL и проверяли, можно ли по ним разделить разрешимые и неразрешимые вопросы. В средних и поздних слоях граница проявлялась как при прямом ответе, так и при явной просьбе сначала оценить достаточность изображения.
Это меняет диагноз проблемы. Модель ошибается не только потому, что не распознала объект, текст или отражение. Во многих случаях она уже кодирует нехватку визуальных доказательств, но стандартная генерация всё равно тянет её к содержательному ответу.
Rep2Act ставит перед генерацией дискретный переключатель: отвечать или отказаться. Отдельная классификационная головка читает представления из выбранных глубоких слоёв, а модель одновременно выбирает соответствующий служебный токен из словаря. Эти два сигнала объединяются, после чего объяснение и финальная реплика строятся по выбранному маршруту.
Обучение решает две разные ошибки. Функция отступа разводит оценки двух маршрутов, чтобы решение не оставалось пограничным. Контрастная функция сравнивает продолжение при правильном и перевёрнутом маршруте: если выбран отказ, последующий текст не должен внезапно содержать уверенный ответ, а после выбора ответа модель не должна уходить в общий отказ.
На VAD-R точность правильного выбора между ответом и отказом у Qwen2.5-VL-3B выросла с 56,67% до 86,33%. Сходный эффект получили на более крупной Qwen2.5-VL-7B. На внешнем TUBench версия Rep2Act меньшего размера достигла F1 53,3% — эта метрика одновременно учитывает, как часто модель находит неразрешимые вопросы и как часто её отказы действительно уместны.
Для продукта нужен отдельный маршрут отказа, а не только новый запрос
Работа поддерживает архитектурное решение, при котором генератор не сам определяет режим ответа на первом слове. Между распознаванием изображения и формированием реплики полезно поставить явный шлюз: он выбирает ответ, запрос уточнения или отказ, а генератор обязан следовать этому выбору.
Rep2Act нельзя просто добавить к закрытому API одной инструкцией. Метод требует доступа к скрытым представлениям, дополнительной классификационной головки и обучения на размеченных объяснениях. Он подходит командам, которые дообучают собственную зрительно-языковую модель; для внешнего API практическим приближением остаётся отдельный вызов, который сначала проверяет достаточность данных.
Пересматривать стек только из-за этого препринта рано. Rep2Act обучали на двух размерах Qwen2.5-VL, основной результат получили на VAD-R, а перенос проверяли на TUBench и UNK-VQA. Работа показывает механизм и рабочую схему обучения, но не устанавливает надёжность отказов на документах, медицинских снимках, производственных камерах или данных конкретного продукта.
Планы стоит менять на уровне прототипа и метрик. Если ложный уверенный ответ обходится дороже отказа, в испытания нужно включить вопросы с реально недостающими доказательствами и отдельно измерять выбор маршрута, обоснованность причины и соответствие финального текста этому выбору. Обычной точности ответов для такой системы недостаточно.
Источники
Иллюстрация: рисунок из статьи «From Knowing to Abstaining: Bridging the Representation-Action Gap in Vision-Language Models», Jialuo He, Huangxun Chen, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


