
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Диагностику сбоев ИИ-агентов научились проверять по тому, исправляет ли предложенное действие задачу, а не по совпадению с заранее выбранным ответом. Хотя работа пока не прошла рецензирование и все числа получили сами авторы, лучший результат ReplayRCA составил +51,3 процентного пункта к вероятности успеха. Такой тест отделяет убедительное объяснение от вмешательства, после которого агент действительно завершает работу.
Как результат вмешательства заменяет разметку
Обычный тест диагностики просит модель назвать ошибочный шаг, а затем сравнивает ответ с разметкой. Это создаёт две проблемы: у сбоя может быть несколько подходящих точек исправления, а модель может угадать структуру теста — например, почти всегда выбирать последнее действие.
ReplayRCA восстанавливает среду до шага, который выбрала диагностирующая модель. Её действие подставляют вместо исходного, после чего тот же рабочий агент с прежними настройками продолжает задачу самостоятельно. Если итоговая проверка проходит, вмешательство могло исправить сбой.
Одного успешного продолжения недостаточно: агент иногда справляется после перезапуска без полезной подсказки. Поэтому рядом запускают плацебо — восстанавливают то же состояние, но повторяют исходное действие агента. Показатель «каузальное исправление» равен разнице между долями успешных продолжений после замены и после плацебо; для каждого варианта делают пять запусков.
Такой показатель не требует эталонного ошибочного шага или модели-оценщика. Он также не считает правильным объяснение, которое звучит разумно, но не меняет исход. При этом ReplayRCA измеряет не обязательно первопричину: если ошибку можно компенсировать позднее одним корректным действием, тест засчитает такое решение.
Вторая часть теста проверяет оперативный надзор (live oversight). Модель наблюдает выполнение задачи и перед необратимым действием может один раз заменить его. Она не знает, закончится ли исходный запуск ошибкой, поэтому лишнее вмешательство в нормальную работу тоже влияет на оценку.
Посмертный разбор и надзор дают разные рейтинги
Разбор после сбоя проверяли на 62 систематических ошибках и наборе из 13 моделей. Верхняя часть рейтинга оказалась статистически неразличима: порядок моделей не позволяет уверенно назвать лидера. Принудительный выбор последнего шага снижал результат сильной модели на 17,1 пункта, поэтому короткий путь из тестов с разметкой здесь не сработал.
Оперативный надзор проверяли на 87 запусках, куда смешали успешные и неуспешные траектории. Среди двух лучших наблюдателей оказался небольшой открытый DeepSeek V4.1 Flash, и статистически отделить его от другого лидера не удалось.
GPT-6.1 Sol вошёл в верхнюю группу при разборе завершившихся сбоев, но стал худшим наблюдателем во время выполнения. Разрыв между двумя режимами на одинаковых запусках составил −14,5 пункта и оказался статистически значимым. Значит, качество объяснений после события нельзя использовать как прямой заменитель испытаний надзора в реальном времени.
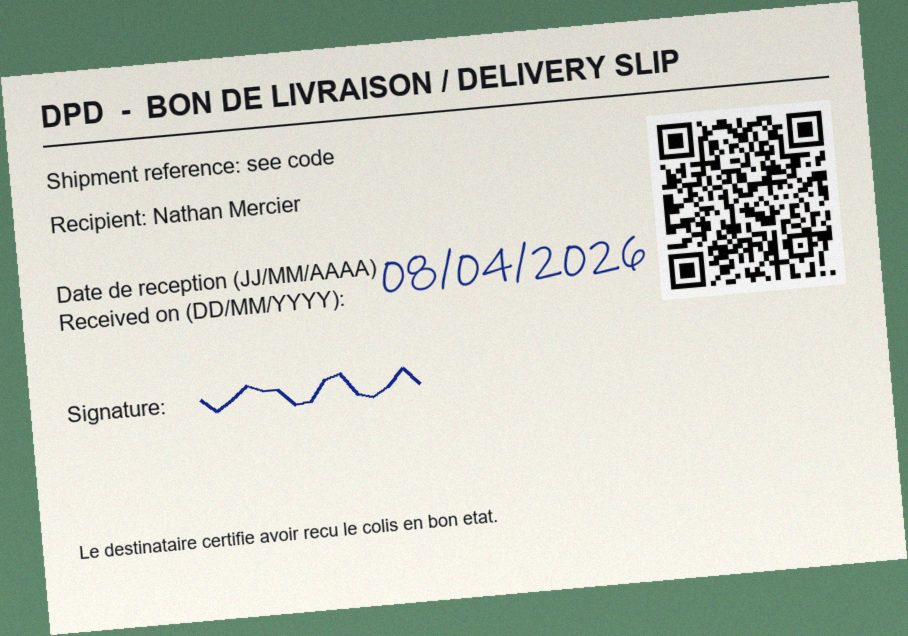
Проверка проходила в OpsWorld — детерминированной имитации бэк-офиса интернет-магазина с возвратами, заказами, складскими остатками и письмами. В самых сложных заданиях информация находилась в QR-кодах, фотографиях форм и рукописных пометках. Итоговый набор в основном состоял из двух типов задач, а большинство сбоев дал один рабочий агент, поэтому конкретный порядок моделей относится к этой среде и этим настройкам.
Что менять при выборе архитектуры агента
ReplayRCA не даёт основания заменить основного агента моделью с первой строки рейтинга. Работа меняет прежде всего план испытаний: диагноста после сбоя и наблюдателя перед необратимым действием следует считать разными компонентами и проверять отдельно.
Протокол применим там, где команда может восстановить состояние перед действием и автоматически проверить конечный результат. Это подходит для изолированных баз данных, контейнеров и имитационных сред. Для процесса, который нельзя воспроизвести или проверить исполняемым правилом, сам подход не создаёт надёжного эталона.
Практический тест можно строить вокруг действий с высокой ценой ошибки: возврата денег, удаления записи, изменения остатков или отправки сообщения клиенту. Наблюдателю дают право на одну замену, затем сравнивают продолжение с повтором исходного действия. Так команда измеряет добавочную пользу надзора, а не общую способность агента восстановиться.
Результат DeepSeek V4.1 Flash делает небольшую открытую модель разумным кандидатом для такого испытания, но не доказывает, что она будет лучшим наблюдателем в другом процессе. Сначала нужен собственный набор воспроизводимых сбоев, включая успешные запуски для учёта ложных тревог. Выбирать наблюдателя по тестам на объяснение ошибок после факта работа не поддерживает.
Источники
Иллюстрация: рисунок из статьи «ReplayRCA: Measuring Post-hoc Diagnosis and Live Oversight of Agent Failures by Counterfactual Replay», Jeremy Canale, Fabien Soulis, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


