
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одинаковый запрос к LLM-агенту может дать разные ответы в зависимости от того, какие запросы система обработала раньше. Пересчёт непрерывных фрагментов снизил расхождение ответов с 69,0% до 26,1%, хотя работа не прошла рецензирование и все числа получили сами авторы. Значит, повторное использование KV-кэша нельзя оценивать только на отдельных запросах с чистым состоянием.
Почему история запросов остаётся в KV-кэше
Перед генерацией модель обрабатывает входной текст и сохраняет для его токенов внутренние представления ключей и значений — KV-кэш. Если следующий запрос начинается с того же текста, сервер может пропустить полный предварительный проход (prefill) по совпавшей части и быстрее выдать первый токен.
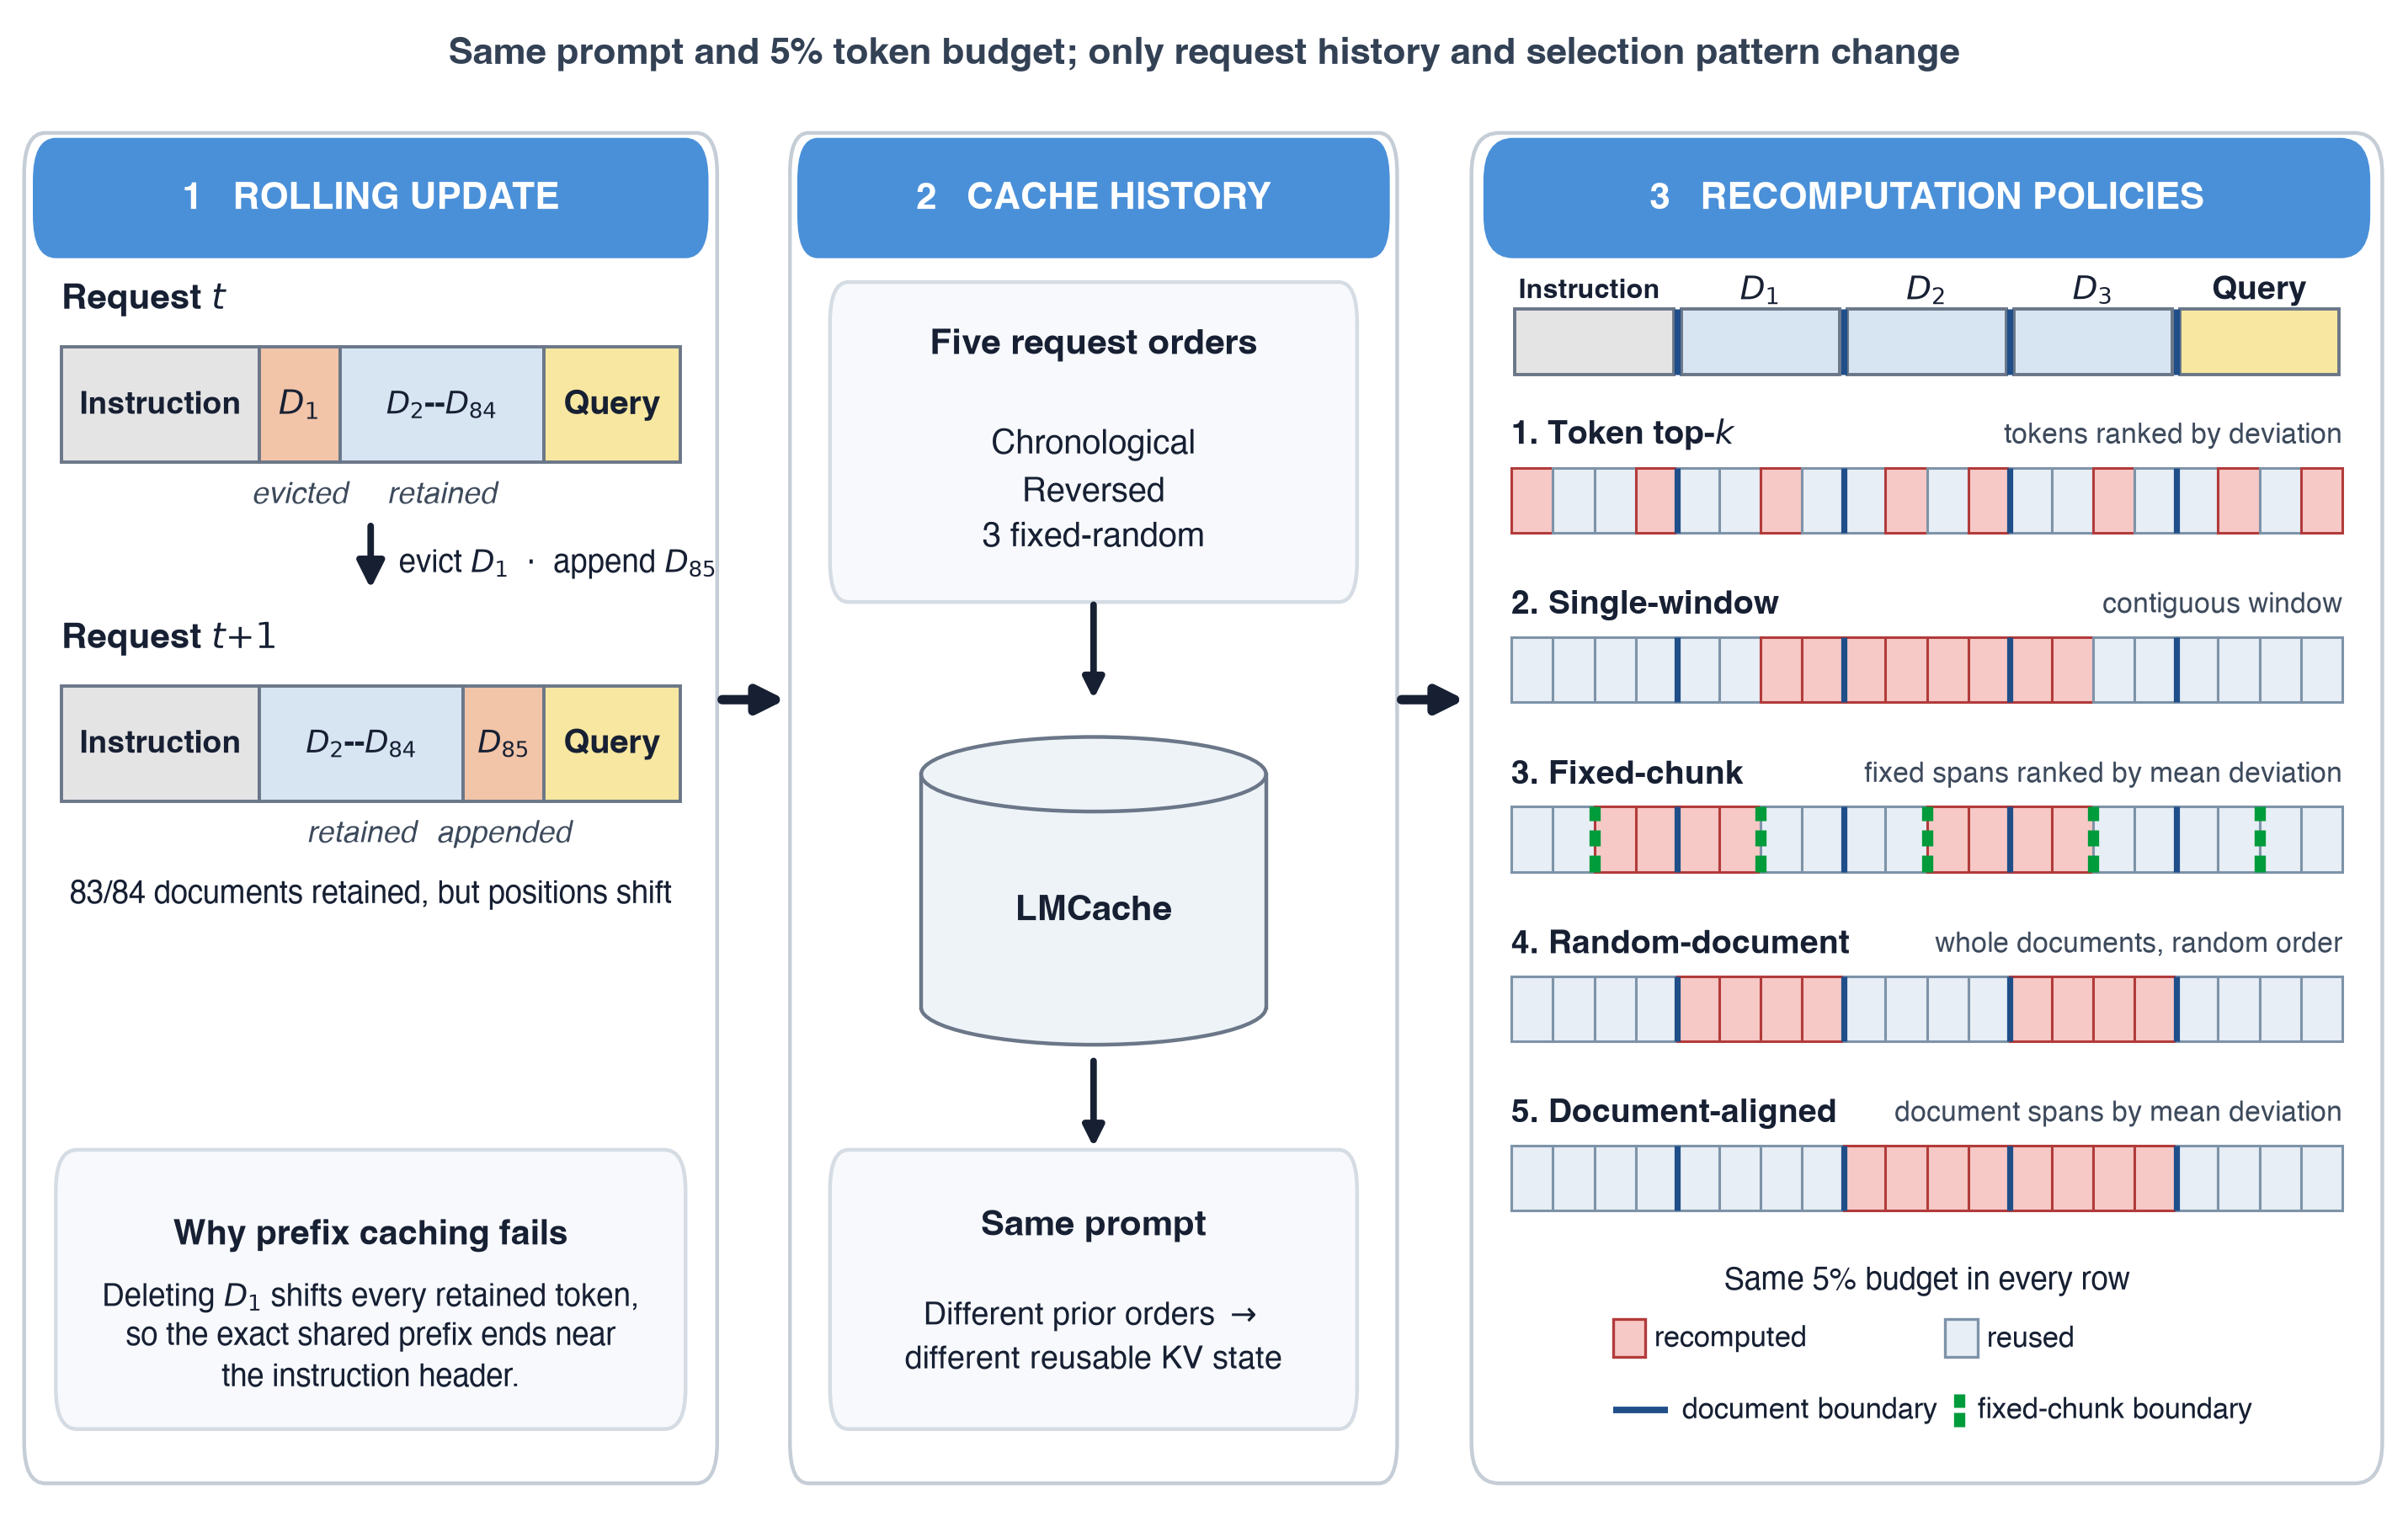
У долгоживущего агента окно меняется иначе. Он удаляет старый документ, сохраняет большую часть остальных и добавляет новый. Сохранённые документы сдвигаются на другие позиции: их текст не меняется, но перед ними теперь находится другой контекст. Обычный кэш точного префикса здесь почти не помогает.
Системы вроде CacheBlend загружают KV-состояния отдельных документов, даже если те оказались не в начале запроса. Такое повторное использование приблизительно: сохранённое состояние рассчитано с другим предшествующим контекстом. Чтобы исправить часть ошибок, система выбирает некоторые токены и пересчитывает их уже внутри текущего запроса.
Стандартная стратегия token top-k ранжирует токены по тому, насколько их текущие ключи отличаются от загруженных, а затем пересчитывает токены с наибольшим отклонением. Они могут оказаться разбросаны по сотням отдельных участков. Авторы сравнили этот подход с пересчётом цельных документов и других непрерывных фрагментов.
Эксперимент провели на Qwen3-8B с детерминированной генерацией. Агент работал с окном из 84 финансовых документов, а длина запросов составляла примерно 7,2–7,7 тысячи токенов. Модель извлекала заданную запись дословно; одни и те же запросы запускали в пяти порядках, сохраняя состояние кэша между вызовами. Время измеряли на NVIDIA L4.
Непрерывные фрагменты стабилизировали ответы без потери ускорения
Обе стратегии пересчитывали одинаковые 5% повторно используемых токенов. При token top-k ответы на один и тот же запрос расходились между разными порядками в 69,0% сравнений. Пересчёт по границам документов снизил расхождение до 26,1%.
В последовательностях, отличных от обычного хронологического порядка, совпадение с результатом полного прохода выросло на 34,5–52,5 процентного пункта. При этом обе стратегии примерно в 5,7 раза сокращали медианное время до первого токена. Более стабильный вариант не покупал точность дополнительным пересчётом или заметно большей задержкой.
В хронологическом запуске стратегии не показали статистически значимой разницы. Она также исчезла в контрольном опыте, где кэш очищали перед каждым запросом. Поэтому тест на изолированных вызовах скрывает именно тот эффект, который возникает при длительной работе агента.
Дополнительное сравнение отделило границы документов от непрерывности. Цельное окно, фиксированные фрагменты поперёк документов, случайно выбранные документы и документы с наибольшим средним отклонением работали сходно. Статистически значимого преимущества границ документов или ранжирования по отклонению не обнаружили: устойчивость прежде всего связывает выбор соседних токенов вместо рассеянных.
Что менять в архитектуре и испытаниях агентов
Работа не требует отказываться от повторного использования KV-кэша: выигрыш по задержке сохранился. Она меняет критерий выбора реализации. Если система повторно использует фрагменты вне точного префикса, качество нужно проверять на последовательностях запросов с общим кэшем, а не только на независимых примерах.
Испытательный сценарий должен воспроизводить жизненный цикл рабочего сервиса: повторные попытки, ветвление траекторий, чередование нескольких сессий и разный порядок поступления задач. Для каждого запроса полезно сравнивать ответ с полным проходом и отдельно проверять, остаётся ли он тем же при перестановке предыдущих вызовов. Средняя задержка сама по себе такую нестабильность не покажет.
Командам, которые уже применяют выборочный пересчёт, стоит включить непрерывные фрагменты как отдельную базовую стратегию. Границы документов удобны, если структура запроса их уже содержит, но работа не доказывает, что именно они дают преимущество. Более простой непрерывный участок показал сопоставимое поведение.
Переносить вывод на любые агентные задачи пока рано. Проверка охватывает одну модель, финансовые документы и задачу точного извлечения, где ответы легко сравнить посимвольно. Для диалогов, генерации кода и недетерминированного декодирования нужен тот же эксперимент с сохраняющимся кэшем, но с подходящей мерой качества.
Источники
Иллюстрация: рисунок из статьи «Request Order Matters: Cache-History Sensitivity in Selective KV-Cache Reuse for Rolling Agents», Tiffany Gu, Annie Guan, Manshu Huang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


