
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
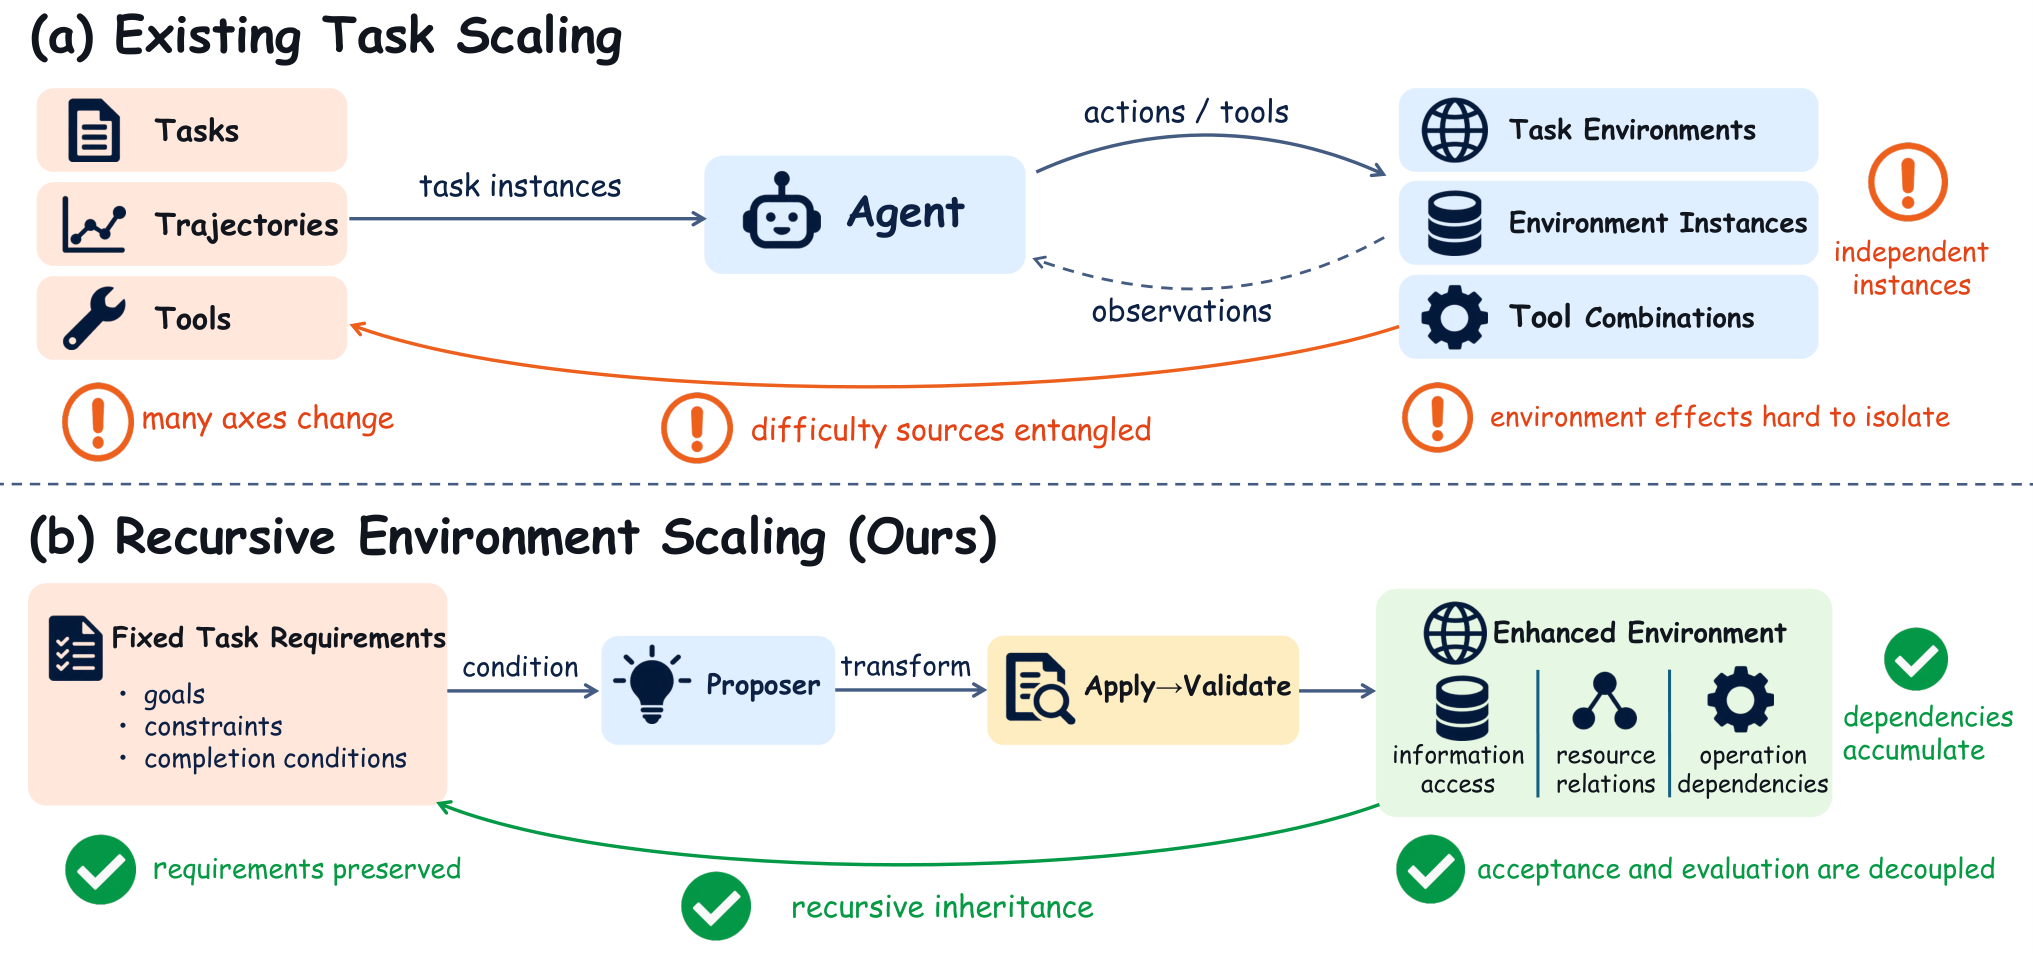
Среду для ИИ-агентов научились усложнять, не меняя цель задачи и критерии её выполнения. Работа не рецензирована, а числа получили сами авторы: успешность DeepSeek-V4.1-Flash на Claw-Eval-Live упала с 82,86% до 5,71%. Такой подход позволяет проверять длинные цепочки действий, не придумывая новые задания.
Метод RES меняет путь к нужным данным: добавляет зависимости между ресурсами, ограничивает прямой доступ и требует выполнить подготовительные операции. Каждую изменённую среду проверяют повторным выполнением действий, а принятые изменения переходят в следующий раунд и обрастают новыми условиями. Цель, исходные факты и требуемый результат при этом сохраняются.
Успешность снизилась во всех сравнениях моделей и тестов. В задаче на сверку банковских, платёжных и CRM-данных агенту понадобился 171 вызов инструмента вместо трёх прямых чтений файлов. Он исчерпал лимит ходов ещё на сборе данных и не приступил к итоговому отчёту, хотя все нужные записи оставались доступны.
Изменённые среды пригодились и для обучения. При одинаковом числе примеров и одинаковых настройках дообучение Qwen3.5 на последовательностях действий из RES обошло обучение на исходных последовательностях во всех сочетаниях моделей и тестов. Прирост успешности составил от 7 до 14,61 процентного пункта.
Метод проверили на 294 задачах из Claw-Eval-Live, Workspace-Bench-Lite и Terminal-Bench 2.1, а сложность оценивали на шести моделях. Каждая модель получала одну попытку с лимитом в 50 ходов. Поэтому результаты показывают, как агенты выдерживают накопленные зависимости при фиксированном бюджете, но не сравнивают разные лимиты времени и повторные попытки.
Источники
Иллюстрация: рисунок из статьи «Recursive Environment Scaling for General Long-Horizon Agents», Lingxiao Jing, Zhengbo Jiao, Yichen Xiang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


