
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
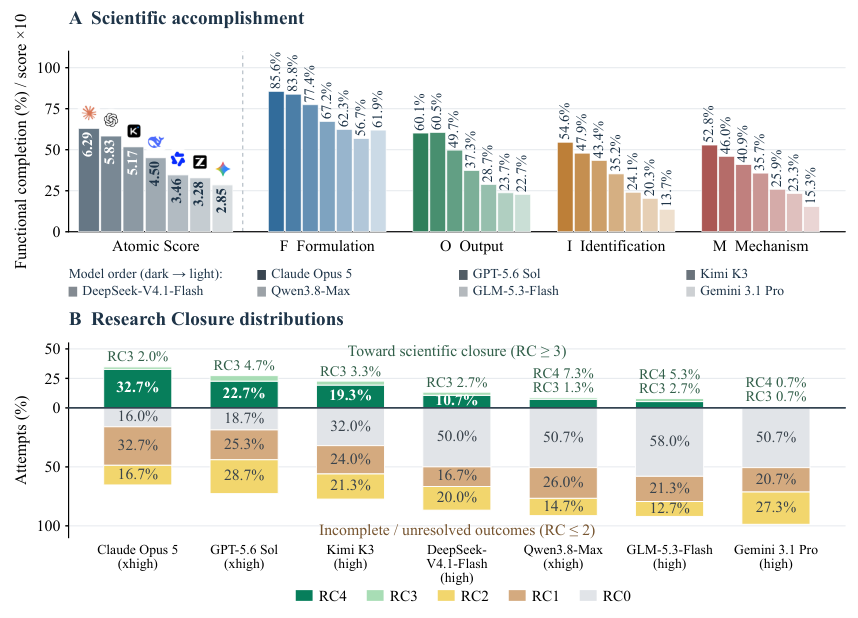
Даже сильнейшие LLM-агенты часто выполняют отдельные части физического исследования, но не доводят его до обоснованного вывода. В препринте, который не проходил рецензирование, все числа получили сами авторы: Claude-Opus-5 полностью закрыл задачу лишь в 32,7% попыток. При оценке исследовательского агента правильные расчёты и высокий суммарный балл поэтому нужно отделять от доказанного ответа.
Для этого создали PhysClosureBench: набор из 50 задач по физике сильных полей, аттосекундным процессам и смежным областям. Агент получает цель, физические ограничения и вычислительные ресурсы, но сам выбирает расчёты, проверки и способ связать результаты с выводом. Локальный балл учитывает корректность постановки, вычислений, найденных признаков, объяснения механизма и проверок. Научное закрытие показывает, достаточно ли доказательств для ответа и обозначены ли границы его применимости.
Семь моделей запускали на каждой задаче трижды в изолированной среде без доступа к сети. Среди попыток с локальной оценкой не ниже 8 из 10 в 36,2% случаев полного закрытия не получилось. Агенты могли построить нужные спектры и выделить компоненты сигнала, но неверно истолковать зависимость, не подтвердить физический механизм или оставить без проверки область применимости вывода.
Один удачный запуск также не означает устойчивого результата. Claude-Opus-5 полностью решил хотя бы одну попытку для половины задач, но справился во всех трёх запусках только с 18%. Значит, при испытаниях исследовательских агентов стоит проверять не только артефакты и промежуточные пункты, но и всю цепочку от цели до подтверждённого вывода — причём в повторных запусках. Работы оценивал автоматический протокол на базе GPT-5.6-Sol, а выбранные оценки дополнительно проверяли специалисты по физике.
Источники
Иллюстрация: рисунок из статьи «From Research Goals to Scientific Closure: Evaluating Agents Through Evidence-Supported Physics Research», Yijia Mao, Song Dai, Tao Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


