
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Предложен способ сократить KV-кэш циклических трансформеров (looped Transformers), не меняя веса модели. ResidualQuant уменьшил теоретический объём хранилища на 80,7% и сохранил точность на уровне BF16; результат описала команда KAIST, Yonsei University и Seoul National University, хотя работа не рецензирована и числа в ней получили сами авторы. Метод позволяет пересчитать допустимый размер пакета и пропускную способность, если продукт строится на архитектуре с повторными проходами через общие блоки.
Почему общий блок всё равно создаёт большой кэш
Циклический трансформер несколько раз применяет один и тот же блок к представлению токена. Это сокращает объём весов по сравнению с архитектурой, где у каждого слоя свои параметры, но не устраняет расходы памяти во время генерации.
Для уже обработанных токенов модель хранит ключи и значения механизма внимания — KV-кэш. Каждый повторный проход создаёт собственные ключи и значения, поэтому кэш растёт вместе с длиной контекста, размером пакета и числом проходов. Экономия на весах не превращается автоматически в возможность обслуживать больше запросов.
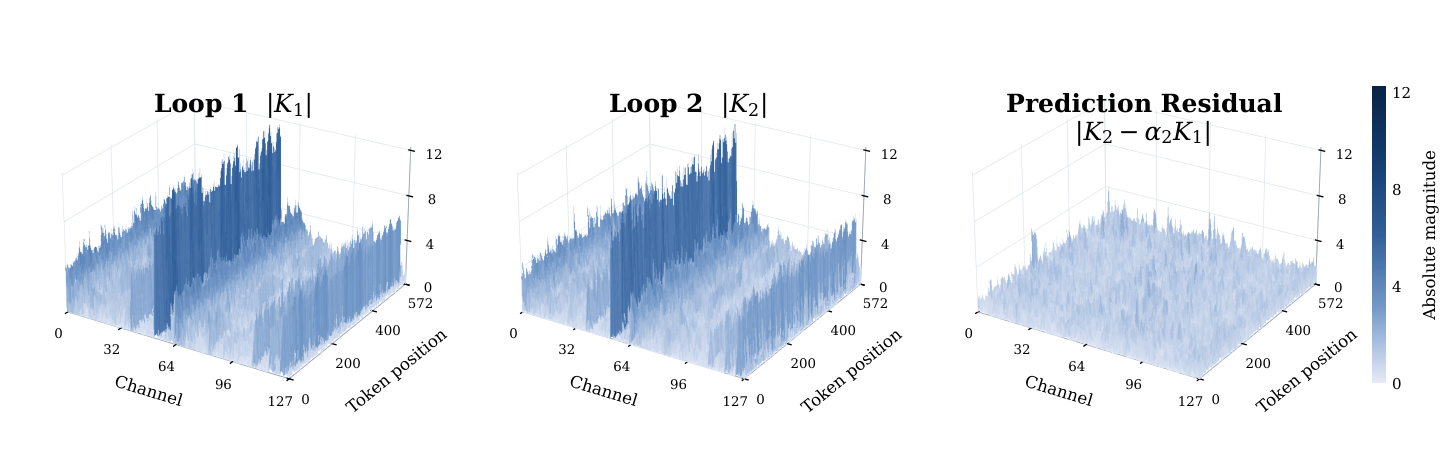
ResidualQuant опирается на то, что соседние проходы используют одни и те же проекции. Их KV-состояния похожи, а разница между ними обычно содержит меньше выбросов, чем исходные значения. Небольшую разницу можно представить с низкой разрядностью точнее, чем весь кэш.
Предыдущие способы либо квантуют каждый проход независимо, либо повторно используют один набор KV-состояний. Первый вариант теряет точность при переходе к INT2, второй отбрасывает сведения, которые появились на конкретном проходе. ResidualQuant сохраняет отдельное состояние каждого прохода, но записывает большую часть информации как разницу относительно общей опоры.
Как восстанавливается KV-кэш каждого прохода
Опорой служит KV-состояние последнего прохода. Для остальных проходов система хранит не полный кэш, а разницу между их состоянием и масштабированной опорой. Выбирать предыдущий проход как опору проще, но тогда позднее состояние приходится восстанавливать по цепочке и несколько раз читать кэш из памяти GPU.
Масштаб для каждой разницы подбирает метод наименьших квадратов: он находит коэффициент, при котором исходное состояние и опора расходятся минимально. Это учитывает, что величина ключей и значений меняется от прохода к проходу. Без коэффициента система просто вычитала бы состояния одинакового масштаба и получила бы более широкий диапазон для квантования.
Затем разницу поворачивают в пространстве каналов. Такой поворот распределяет отдельные крупные значения между каналами, чтобы выброс не растягивал шаг квантования для всей группы. Матрицы поворота калибруют отдельно для ключей и значений каждого слоя и головки, а затем повторно используют для всех токенов и проходов.
Опору хранят в INT4, а разницы — в INT2. Более точная опора нужна потому, что ошибка в ней попадает во все восстановленные состояния. Квантование использует настраиваемые шаг и смещение, поэтому задействует все доступные уровни INT2, а не тратит один код ради симметрии относительно нуля.
Последнее состояние текущего токена ещё недоступно во время ранних проходов. Поэтому его промежуточные KV-состояния временно остаются в BF16, а запись сжатого кэша откладывается до завершения последнего прохода.
Специальное ядро CUDA восстанавливает опору и разницы небольшими блоками прямо внутри вычисления внимания. Оно не записывает распакованный KV-кэш обратно в память GPU. Реализация подключена к vLLM, при этом планировщик запросов и постраничное управление кэшем остаются прежними.
Когда ResidualQuant меняет инфраструктурный план
На MATH500 с Ouro-1.4B прямое квантование в INT2 дало точность 27,8%, а последовательное добавление опоры, масштабирования, поворота и смешанной точности подняло её до 76,0% — уровня исходного BF16. Этот разбор по шагам показывает, что результат обеспечивает вся схема, а не только хранение разниц.
При фиксированном размере пакета сокращение обмена с памятью ускорило декодирование до 2,73 раза. Когда освободившуюся память использовали для увеличения пакета, пиковая пропускная способность выросла до 4,15 раза.
Качество проверяли на Ouro-1.4B и Huginn-3.5B в задачах математического рассуждения и генерации кода. Системные замеры провели для Ouro на одной RTX 5090 с собственным ядром внимания, поэтому перенос результата на другую модель, GPU и серверную нагрузку требует отдельного теста.
Работа меняет расчёты для команд, которые уже выбрали циклический трансформер или сравнивают его с обычной архитектурой. В таком проекте память под KV-кэш больше не обязательно растёт почти пропорционально числу проходов: в планирование можно заложить сжатую опору и остатки, а затем проверить реальный размер пакета на целевом оборудовании.
Для обычного трансформера без повторных проходов основной источник экономии отсутствует: между циклами нет сходных состояний, разницу которых можно хранить. Метод также нельзя свести к смене формата кэша — для ускорения нужны калиброванные повороты, отложенная запись текущего токена и ядро внимания, которое работает со сжатыми данными напрямую.
Источники
Иллюстрация: рисунок из статьи «ResidualQuant: KV Cache Quantization for Looped Transformers with 2-Bit Residuals», Heejun Kim, Junyoung Lee, SangLyul Cho и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


