
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
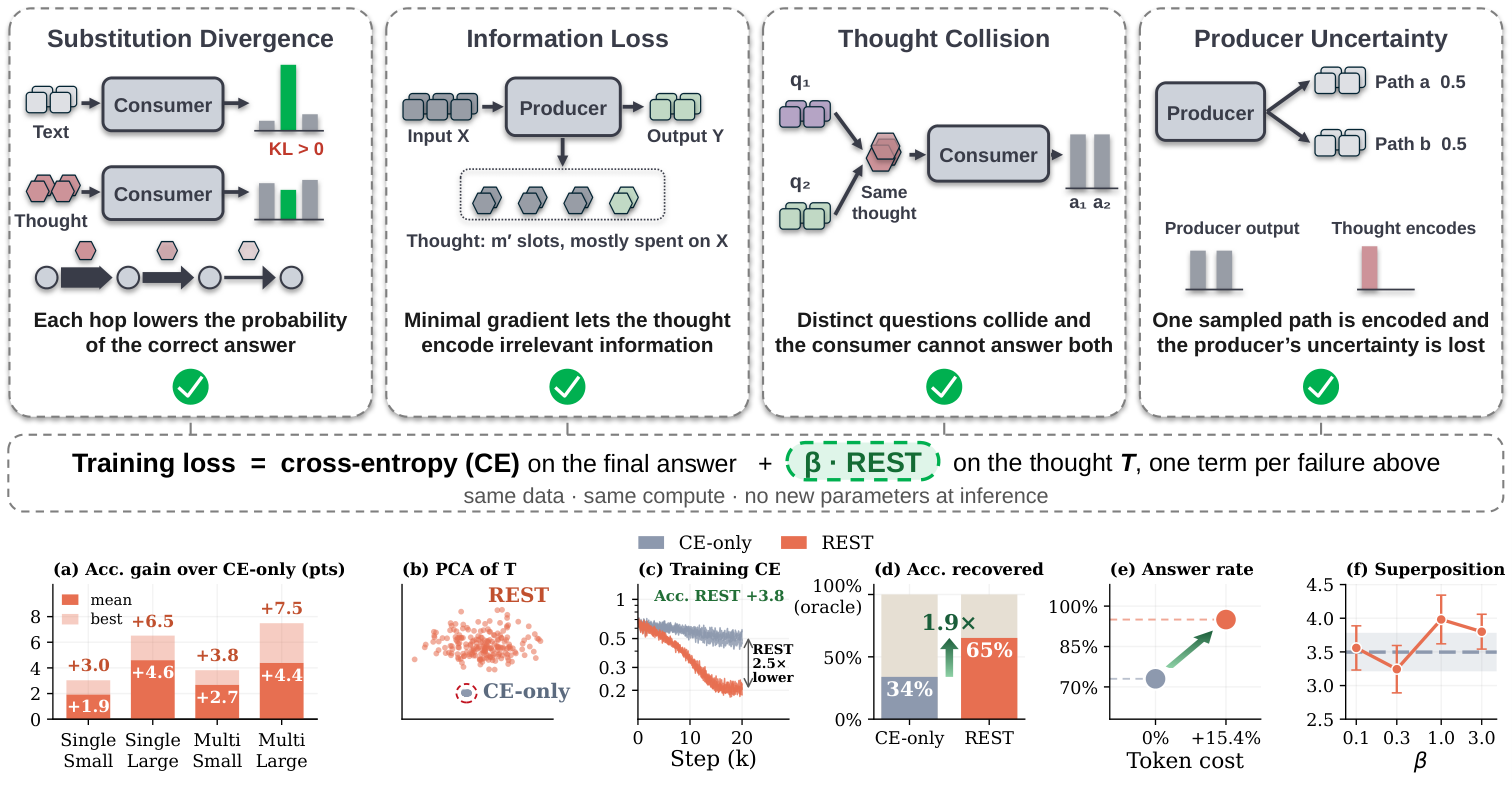
Скрытые рассуждения LLM стали точнее, когда при обучении начали проверять не только финальный ответ, но и свойства внутренней мысли. Fahd Seddik и Fatemeh Fard в нерецензированном препринте приводят собственные замеры: REST повысил точность до 7,5 процентного пункта по сравнению с обучением только по ответу. Для команд, которые передают скрытые состояния между моделями или возвращают их той же модели, это повод пересмотреть функцию потерь и диагностику системы.
Почему правильного ответа недостаточно
Обычно скрытую рекурсивную систему обучают через перекрёстную энтропию: модель получает штраф, если финальный ответ отличается от целевого. Промежуточная мысль остаётся без прямых требований, пока система сохраняет высокую вероятность правильного ответа.
Такой сигнал допускает несколько сбоев. Скрытое состояние может потерять часть плана, сохранить лишние детали исходного вопроса или оказаться почти одинаковым для задач с разным смыслом. Следующая модель тогда получает неоднозначное представление, даже если ошибка ещё не проявилась в обучающем ответе.
Проблема усиливается в цепочке агентов. В исследуемой схеме планировщик предлагает решение, следующий агент уточняет его, а решатель выдаёт ответ; затем результат можно вернуть в начало для нового прохода. Каждый участник опирается на скрытую мысль предыдущего, поэтому потеря информации распространяется по остальной цепочке.
Та же проблема возникает у одного агента. Модель делает скрытые шаги, получает собственное состояние на вход и повторяет цикл. Финальная ошибка показывает, что цепочка дала сбой, но не объясняет, на каком шаге представление потеряло нужную информацию.
Как REST задаёт свойства скрытой мысли
REST сохраняет обычную функцию потерь по финальному ответу и добавляет к ней штраф за нарушение одного или нескольких свойств представления. Архитектуру и порядок работы системы менять не нужно, а при использовании модели дополнительные параметры не появляются.
- Причинность. Скрытая мысль должна вести следующего агента к тому же распределению ответов, что и текст, который она заменяет. Если после подстановки состояния модель начинает предпочитать другие продолжения, функция потерь штрафует расхождение.
- Минимальность. Представление должно сохранять сведения из плана или результата производителя и отбрасывать детали его входного запроса, которые следующему агенту не нужны. Так REST мешает каналу превращаться в копию исходного контекста.
- Разделимость. Мысли для семантически разных результатов не должны сливаться в одну область. Метод сравнивает представление с предыдущими обучающими примерами и раздвигает слишком похожие состояния.
- Стабильность. Мысль должна передавать не один выбранный текст, а неопределённость модели между возможными продолжениями. Для этого отдельный модуль восстанавливает по состоянию среднюю энтропию предсказаний производителя.
В многоагентной схеме такой штраф добавляют к каждой передаче между участниками. В одноагентной модели он действует на каждом возврате скрытого состояния той же модели. Поэтому принцип остаётся одним и тем же: контролируется не число агентов, а информация, которая проходит через рекурсивный канал.
В опытах базовые LLM и внутренний переход, который возвращает состояние в пространство входов, оставались замороженными. Обучался только внешний переход между производителем и получателем мысли. Это изолирует эффект REST, но пока не показывает, как метод поведёт себя при совместном обучении самой модели и всех переходов.
Что REST меняет в планах разработки
Метод проверяли на открытых моделях семейств Qwen, Llama и Gemma. Обучение шло на математических данных, а оценка охватила семь наборов задач по математике, естественным наукам, медицине и генерации кода. Сравнение проводили при одинаковых данных, вычислительном бюджете и числе скрытых шагов; отдельно проверяли одного агента и цепочку агентов.
REST не просто раздвинул представления во внутреннем пространстве. Декодированные мысли чаще содержали план производителя, а не фрагменты его запроса, и лучше заменяли исходный текст при передаче решателю. Это связывает прирост точности с качеством канала, а не только с удачной дополнительной регуляризацией.
За результат пришлось заплатить длиной ответа: модель генерировала в среднем на 15,4% больше токенов. При этом доля примеров, где она доходила до оформленного финального ответа, выросла с 73% до 95%. Дополнительные токены в этих опытах уходили не на бесконечное рассуждение, а на завершение решения.
Для команды, которая уже строит рекурсивные схемы на скрытых состояниях, работа меняет два пункта плана. Во-первых, одной ошибки финального ответа недостаточно: при обучении стоит отдельно ограничивать содержание и различимость промежуточных представлений. Во-вторых, в оценку нужно включить коллизии мыслей, сохранность плана и способность состояния заменить текстовый канал.
Прямо перенести REST можно только туда, где команда обучает переходы между скрытыми состояниями и имеет доступ к распределениям моделей. Для агентов, которые общаются обычным текстом через закрытый API, работа скорее задаёт критерии качества внутреннего канала, чем готовый способ внедрения.
Источники
Иллюстрация: рисунок из статьи «Principled Thoughts for Latent Recursive LLM Systems», Fahd Seddik, Fatemeh Fard, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


