
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Усечение обратной связи учителя до самых вероятных токенов может незаметно заставлять модель-ученика копировать не учителя, а искажённое распределение. Хотя препринт Zixiang Ni и соавторов не рецензирован и все числа получили сами авторы, предложенная ими ReTaCo превзошла EOPD на большинстве проверенных задач по математике и программированию. Для команд, которые обучают компактные модели через дистилляцию на траекториях ученика (on-policy distillation), работа меняет прежде всего выбор функции потерь, а не инфраструктуру.
Почему отбрасывание хвоста меняет цель обучения
При такой дистилляции ученик генерирует префикс, а учитель возвращает вероятности следующего токена. Обучение идёт на состояниях, в которые ученик действительно попадает при генерации, поэтому расхождение между обучением и использованием модели становится меньше.
Передавать распределение по всему словарю для каждого токена дорого. EOPD сокращает объём обмена: учитель отправляет только k самых вероятных токенов, а их вероятности заново нормализуют так, чтобы сумма стала единицей. Затем прямое расхождение Кульбака — Лейблера помогает восстановить подходящие токены, которым ученик назначил слишком низкую вероятность.
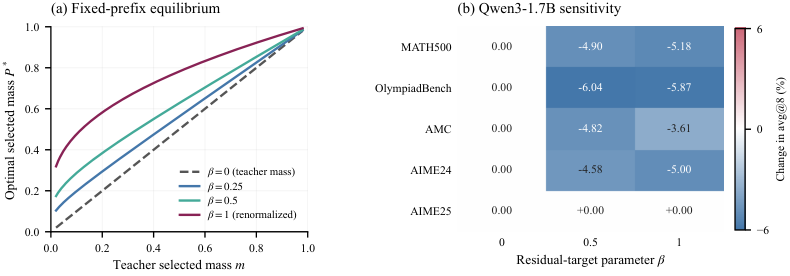
Проблема возникает из-за повторной нормализации. Пусть выбранные токены в исходном распределении учителя вместе получают массу m. После нормализации их целевая масса становится единицей, а все остальные токены получают нулевую массу — даже если учитель оставлял им заметную вероятность.
Поэтому функция потерь решает сразу две задачи: выравнивает относительные вероятности выбранных токенов и вытесняет весь остаток. Даже когда ученик уже воспроизвёл пропорции учителя внутри выбранного набора, градиент продолжает переносить вероятность из хвоста. Распределение учителя не становится точкой, где градиент исчезает.
Обратное расхождение, которое учитывает токены из распределения ученика, ослабляет этот перекос, но не устраняет его. В теоретической модели равновесная масса выбранных токенов всё равно оказывается выше учительской.
Как ReTaCo сохраняет остаточную вероятность
ReTaCo не пытается передать вероятности каждого токена из хвоста. Метод объединяет их в один остаточный символ, который существует только внутри функции потерь. Учитель по-прежнему отправляет идентификаторы и исходные вероятности выбранных токенов, но теперь обучение явно учитывает, какая суммарная масса осталась за их пределами.
Параметр β задаёт, какую долю хвоста следует перенести на выбранные токены. При β=0 целевая масса полностью совпадает с распределением учителя. С ростом β хвост намеренно сокращается, но относительные вероятности внутри выбранного набора не меняются.
Это разделяет две задачи, которые EOPD смешивает. Первая контролирует общую массу выбранного набора, вторая восстанавливает соотношение между конкретными токенами. Даже без сокращения хвоста недооценённый токен получает ненулевой градиент, поэтому ради его восстановления не нужно объявлять всё остальное невозможным.
Для обратной части ReTaCo использует один токен, выбранный учеником. В среднем такая оценка совпадает с расхождением по полному словарю и сохраняет чувствительность к отдельным токенам хвоста. При этом учитель передаёт объём данных порядка k на позицию; в основных опытах выбирали k=16.
Экономия касается обмена между учителем и учеником, а не всех вычислений. Учитель всё ещё должен нормализовать вероятности по полному словарю и найти самые вероятные токены. Поэтому ReTaCo полезна, когда узким местом служат передача или хранение распределений, но сама по себе не сокращает полный проход учителя.
Меняет ли работа планы обучения компактных моделей
Метод проверили на трёх парах учитель — ученик, используя математические наборы DAPO-Math-17k и задачи на код из Eurus-2-RL-Data. На Qwen3.5-2B результат MATH500 вырос с 71,73 до 79,85%. ReTaCo также получила лучшие оценки среди сравниваемых методов на HumanEval+ и MBPP+ для всех проверенных пар.
Отдельный опыт на Qwen3-1.7B помогает понять источник улучшения. Добавление прямого обучения с сохранённой массой повысило MATH500 с 82,40 до 83,78%. Вариант, который восстанавливал соотношение выбранных токенов без отдельного контроля их общей массы, давал большую часть выигрыша на математических задачах.
Сравнение с EOPD нельзя читать как чистый тест одной замены. EOPD включает порог по энтропии и обновление в стиле PPO, тогда как ReTaCo применяет прямую часть ко всем токенам ответа и использует другую обратную оценку. Абляции с одинаковой схемой обучения лучше изолируют остаточную цель: сохранение учительской массы оказалось предпочтительнее частичного и полного сокращения хвоста на MATH500, OlympiadBench и AMC, но эффект зависел от задачи.
Теоретический результат также относится к одному фиксированному префиксу. Он не гарантирует такую же сходимость, когда префиксы меняются вместе с учеником, обновления запаздывают или градиенты ограничивают. Внешние проверки после математической дистилляции дали неоднородные результаты на ARC-C, MMLU-Pro и GPQA-Diamond.
Если команда уже передаёт только верхнюю часть распределения учителя, повторно нормализовать её до единицы без явного хвоста рискованно: функция потерь меняет целевое распределение. ReTaCo предлагает локальную замену — сохранить исходные вероятности, добавить агрегированный остаток и отдельно выбрать, нужно ли сокращать его. Перестраивать весь контур дистилляции ради этого не требуется.
Источники
Иллюстрация: рисунок из статьи «ReTaCo: Residual-Target Control for On-Policy Distillation», Zixiang Ni, Zhuo Hu, Renjie Cao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


