
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
ИИ-агента научили исправлять ранние ошибки до того, как они сорвут всю задачу. В работе Ziang Ye и соавторов ReTRAIL решил 95,3% задач MineSweeper против 70,8% у сильнейшего базового метода при том же числе попыток; препринт не рецензирован, а числа получили сами авторы. Для систем с длинными цепочками действий откат становится не аварийной кнопкой, а частью политики агента.
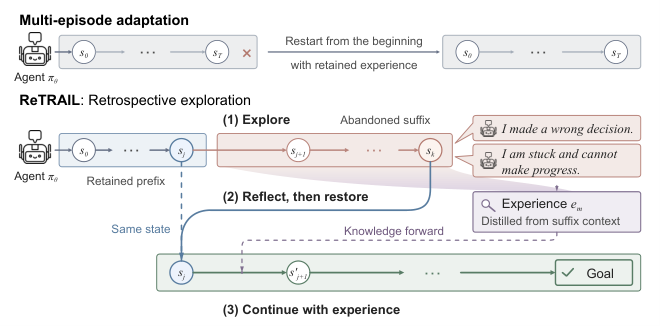
Среда возвращается назад, а знания остаются
Обычный повтор запускает задачу с начала. Агент сохраняет выводы из прошлой попытки, но вынужден заново выполнять уже удачные действия. Локальное исправление рассуждений тоже не помогает, если действие успело изменить среду: коробка в Sokoban уже задвинута в тупик, предмет перемещён или промежуточное состояние потеряно.
ReTRAIL разделяет состояние среды и накопленный опыт. Когда ветка перестаёт приносить пользу, агент выбирает ранее посещённую точку, отбрасывает действия после неё и восстанавливает среду. Перед откатом он сжимает неудачный участок в короткий вывод: какое ограничение обнаружилось, какие действия не работают и какое направление стоит проверить.
После восстановления агент видит прежнее состояние и сохранённую часть истории, но получает дополнительное знание из отброшенной ветки. В примере с Sokoban он возвращается к моменту, когда первая коробка уже стоит на цели, сохраняет этот достигнутый результат и меняет путь ко второй коробке. Неудачная ветка исчезает из среды, но продолжает влиять на решения.
Откат агент выбирает сам: он может сработать после явной ошибки или раньше, когда продолжение выглядит бесперспективным. Это отличает ReTRAIL от контроллера, который запускает восстановление только после внешнего сигнала о провале.
Полезность вывода проверяет следующая ветка
Одной команды «вернуться» недостаточно. Агенту нужно выбрать правильную точку восстановления, не повторить прежнюю ошибку и извлечь из отброшенных действий именно ту информацию, которая поможет дальше. Поэтому ReTRAIL обучает одну общую политику для обычных действий, отката и формулирования выводов.
GRPO с привязкой к состоянию (State-Anchored GRPO) сравнивает разные продолжения, начатые из одинакового состояния и с одинаковой сохранённой историей. Более высокий вес получает ветка, которая продвинулась дальше. Так модель связывает результат не со всей длинной траекторией, а с конкретным выбором после точки отката.
Отдельный сигнал обучает формулировать выводы. Система сравнивает проверяемый прогресс новой ветки с прогрессом отброшенной: если после восстановления агент прошёл дальше, сохранённый вывод оказался полезен. Финального успеха ждать не требуется, поэтому сигнал работает и для задач, где правильное направление становится заметно задолго до завершения.
Простое добавление операции отката давало нестабильный результат и иногда ухудшало успех. На MineSweeper самостоятельное восстановление подняло долю решённых задач с 58,8% до 63,5%. Выигрыш от повторных попыток рос вместе с длиной эталонного решения: с 4,5 процентного пункта на коротких задачах до 19 пунктов на длинных.
Метод проверяли в четырёх управляемых текстовых средах: MineSweeper, Sokoban, ALFWorld и ScienceWorld. Они покрывают логический вывод, планирование с необратимыми ходами, выполнение многошаговых инструкций и процедурные задачи. Сравнение включало методы без обучения, обученные политики и базовые решения с доступом к тому же механизму восстановления.
Архитектура агента меняется сильнее, чем выбор модели
ReTRAIL имеет смысл там, где задача состоит из длинных ветвящихся процессов, а среда умеет точно восстанавливать ранее посещённое состояние. В план системы придётся включить контрольные точки, сохранённый префикс действий и отдельную память с выводами из отброшенных веток. Если состояние нельзя восстановить, основной механизм работы неприменим.
Второе требование — проверяемая мера прогресса. В экспериментах её задавала сама среда: выполненные подцели или изменение состояния задачи. Для собственного продукта команде понадобится аналогичный сигнал, иначе нельзя будет отличить полезный вывод от убедительного текста, после которого агент пошёл по столь же плохому пути.
Это не приём для системной подсказки, который можно добавить к любому агенту. Основной эффект появился после обучения политики на альтернативных продолжениях и последствиях отката. Команда, которая не планирует такое обучение, может использовать саму архитектурную идею, но результаты работы не показывают, что один интерфейс восстановления даст тот же выигрыш.
Вывод относится к средам, где откат действительно возвращает состояние. Авторы отдельно отмечают, что восстановление симуляции не отменяет последствия действий во внешней системе. Для операций с реальными данными и сервисами границу между обратимым исследованием и фактическим выполнением придётся защищать правами доступа, подтверждениями и человеческим контролем.
Источники
Иллюстрация: рисунок из статьи «Travel Back To Move Forward: Retrospective Exploration and Evolving for Long Horizon Agents», Ziang Ye, Wentao Shi, Lei Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


