
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Поискового агента научили точнее отвечать на вопросы, для которых нужно собрать факты из нескольких документов. В препринте University of Edinburgh и Huawei, который не прошёл рецензирование и приводит числа, полученные самими авторами, лучший вариант поднял средний F1 с 51,25 до 54,34. Для команд, которые дообучают агентов с поиском, это повод оценивать не только финальный ответ, но и вклад каждого запроса.
Промежуточная награда различает бесполезный поиск и незавершённый путь
Обычно агент получает награду за итоговый ответ. Если ответ неверен, вся цепочка поиска получает ноль, хотя агент мог найти часть нужных документов. Обучение не отличает этот случай от траектории, в которой поиск не дал ничего полезного.
Особенно плохо такой сигнал работает в групповой относительной оптимизации политики GRPO. Для одного вопроса модель строит несколько траекторий, после чего алгоритм сравнивает их награды внутри группы. Когда все ответы одинаково неверны, сравнивать нечего, даже если одна траектория приблизилась к ответу заметно сильнее других.
Чтобы измерить этот прогресс, авторы собрали 14 000 учебных вопросов с промежуточными подвопросами, зависимостями и ссылками на подтверждающие фрагменты Wikipedia. Вопросы включали последовательные цепочки и структуры, где ответ требовал совместить сведения из нескольких ветвей.
Работа сравнивает три сигнала. Покрытие доказательств засчитывает подвопрос, когда агент нашёл все связанные с ним фрагменты. Покрытие с зависимостями дополнительно требует сначала закрыть предшествующие шаги: если найден первый и третий факт цепочки, третий не приносит награду до появления пропущенного второго. Совпадение ответа использует более дешёвую проверку — ищет эталонный ответ в полученном тексте, но может сработать на нерелевантном документе.
Повторный поиск уже засчитанного факта ничего не добавляет. Поэтому сигнал показывает не общий объём текста, а момент, когда конкретный запрос принёс новые доказательства.
Награда за конкретный запрос оказалась полезнее общей надбавки
Промежуточный сигнал можно передать модели двумя способами. Первый добавляет весь найденный прогресс к финальной награде и затем применяет одно значение ко всей траектории. Такой вариант помогает различить ответы с одинаковым итоговым баллом, но не показывает, какое действие заслужило награду.
Второй способ назначает кредит конкретному поисковому запросу. Здесь кредит — это доля заслуги за результат: алгоритм сравнивает один и тот же шаг между траекториями и добавляет положительную или отрицательную поправку к токенам выполненного запроса. Финальная награда при этом продолжает влиять на всю траекторию, а тексты, которые вернул поисковый инструмент, в обновлении модели не участвуют.
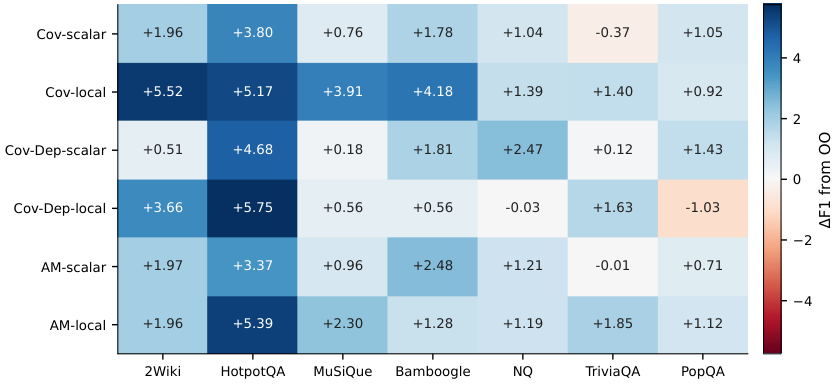
Лучший вариант, Cov-local, локально назначал кредит за покрытие подтверждающих фрагментов. Он прибавил 3,09 пункта F1 к обучению только по финальному ответу. F1 — гармоническое среднее точности и полноты ответа. На многошаговых вопросах прирост достиг 4,81 пункта.
Локальное назначение обошло общую надбавку для каждого из трёх промежуточных сигналов. При этом строгий порядок доказательств не всегда помогал: учёт зависимостей оказался полезнее при общей награде, а локальный вариант лучше работал, когда засчитывал факт сразу после получения. Значит, способ измерить прогресс нельзя выбирать отдельно от способа обновить модель.
Перемешивание кредита между запросами ухудшало результат, хотя общий объём сигнала сохранялся. Модели было важно получить поправку именно на то действие, которое принесло новый факт. Промежуточная награда также помогала не только при одинаковых финальных оценках, но и в группах, где ответы уже различались по качеству.
Что менять в обучении поискового агента
Если продукт уже обучает агента по проверяемому финальному ответу, менять сам алгоритм целиком не требуется. Можно сохранить итоговую награду и добавить локальную поправку для запросов, которые расширили набор подтверждающих документов. Для этого система должна связывать найденный фрагмент с конкретным вызовом поиска и не награждать повторное получение того же факта.
Главная стоимость такого подхода лежит в данных. Точное покрытие требует знать, какие документы подтверждают каждый промежуточный шаг. Проверка по строке ответа проще и не требует графа подвопросов, но слабее отличает доказательство от случайного упоминания. Для закрытого корпуса эти аннотации можно заложить при подготовке учебного набора; для открытого поиска их придётся получать другим способом.
Анализ отдельных вопросов показал, что локальная награда прежде всего учит агента находить больше нужных материалов. При одинаковом покрытии доказательств качество ответа у моделей оставалось близким. Работа поэтому не показывает, что агент научился лучше рассуждать по найденному тексту: она улучшает получение доказательств, а их использование остаётся отдельной задачей.
Проверка охватила Qwen3-4B-Instruct-2507, фиксированный поисковый модуль и семь наборов вопросов. На каждый запрос поисковик возвращал три фрагмента из корпуса KILT-2019 Wikipedia. Эти условия дают содержательное сравнение способов назначить награду, но не устанавливают, что тот же выигрыш сохранится с другими размерами моделей, поисковыми системами и рабочими корпусами.
Источники
Иллюстрация: рисунок из статьи «Beyond Outcome Rewards: Constructing and Assigning Retrieval Credit for Search Agents», Wenyu Huang, Xinyu Hou, Pavlos Vougiouklis и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


