
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Один проход компьютерного агента научились превращать в исполняемую политику, которую можно повторно запускать с новыми параметрами и из разных начальных состояний. В препринте Hyewon Suh и соавторов, который не проходил рецензирование и содержит замеры самих авторов, стоимость одного запуска такой политики была до 217 раз ниже, чем у агента. Подход меняет экономику регулярных процессов: дорогая модель сначала составляет и отлаживает процедуру, а затем участвует только в решениях, которые зависят от состояния интерфейса.
Постоянная часть процесса переезжает в код
Обычный компьютерный агент заново выбирает каждое действие: смотрит на экран, рассуждает, нажимает кнопку и повторяет цикл. Это помогает в незнакомой среде, но заставляет модель снова решать уже известные задачи — например, в каком порядке заполнить поля и куда сохранить результат.
Предложенная нейросимвольная политика разделяет сценарий на постоянную и переменную части. Порядок действий, циклы, условия и значения параметров записываются в программу. Комбинации клавиш, команды оболочки и операции с файлами выполняются без вызова большой модели.
Нейросетевыми остаются действия, которые нельзя надёжно зафиксировать заранее. Модель находит описанный элемент на текущем снимке интерфейса, проверяет состояние приложения и выбирает ветку программы. Поэтому сценарий может нажать «Отправить» независимо от координат кнопки или сначала закрыть диалог, которого не было при первоначальном запуске.
Исходную политику строят из одной траектории базового агента, причём она не обязана завершиться успешно. Конвертер объединяет действия в программу, заменяет координаты текстовыми описаниями элементов, а конкретные даты, имена файлов и другие значения — параметрами задачи. Простого преобразования недостаточно: в экспериментах такая версия работала дешевле агента, но заметно уступала политике после доработки.
Сценарий исправляют с места первого сбоя
Метод NSPI запускает политику в сброшенной среде и поручает двум моделям-оценщикам проверить результат. Первая исследует конечное состояние с помощью команд чтения и операций с файлами. Вторая сопоставляет соседние состояния интерфейса, находит первый неверный шаг и описывает тип ошибки.
Во время этой проверки модели не получают оценку от самого бенчмарка. Если политика ошиблась, базовый агент продолжает работу из состояния после сбоя. Затем модель для программирования получает журнал выполнения, диагноз и краткое описание удачного продолжения, после чего переписывает код.
Политику также прогоняют на автоматически созданных вариантах. В одних меняются параметры запроса, в других — начальное состояние приложения: документ может быть закрыт, окно перекрыто диалогом, а файл уже содержать устаревшие данные. Такие запуски выявляют жёстко записанные значения и пропущенные ветки.
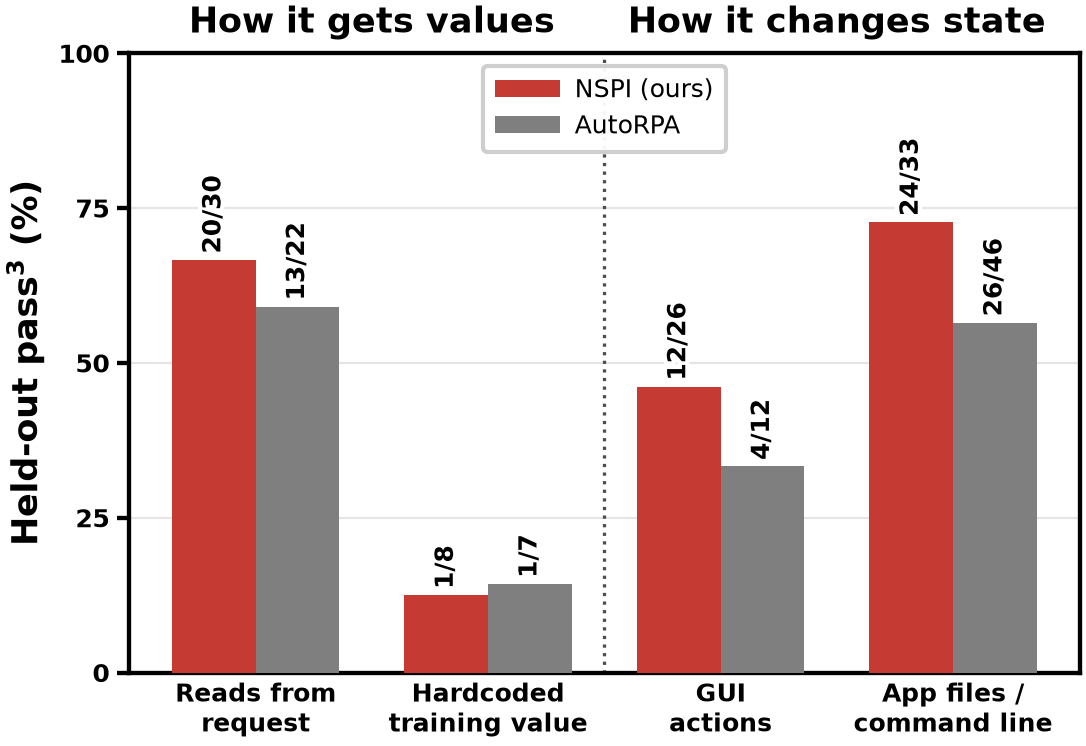
Надёжность проверяли на OSWorld-Verified и ScienceBoard с GPT-5.6 Terra и Claude Opus 5. Всего тесты охватили 530 задач. Основная метрика Pass^3 показывает долю задач, которые завершились успешно во всех трёх повторах. NSPI занял первое место по ней во всех четырёх сочетаниях бенчмарка и базовой модели, в среднем опередив следующий метод на 8,1 процентного пункта.
Подход окупается на регулярных, но ограниченных сценариях
Работа даёт основание пересмотреть архитектуру продукта, если один процесс запускается много раз, а его основная последовательность известна. Вместо агента, который полностью планирует каждый проход, можно использовать его для разведки и восстановления после сбоев, а штатное выполнение передать программе с точечными нейросетевыми вызовами.
Разработка политики требует отдельного бюджета: агент выполняет задачу, оценщики разбирают ошибки, а модель несколько раз исправляет код. В изученных конфигурациях эти затраты окупались после 3–27 запусков. Поэтому подход подходит для обработки регулярных отчётов, файлов и форм, но не даёт такого же преимущества одноразовой задаче.
На более длинных заданиях OSWorld-V2 политики повторяли результат стабильнее, но решали задачи реже базового агента. При переносе длинной траектории в программу терялись прочитанные с экрана значения и связи между шагами. Это оставляет агентное выполнение предпочтительным там, где процесс открыт, часто меняет цель или требует долгого накопления контекста.
Проверка перед действием пока не служит самостоятельной границей безопасности. В одном из вариантов проверяющая модель пропустила 17 из 24 действий, которые следовало заблокировать; другая пропускала меньше, но чаще останавливала правильные сценарии. Для финансовых, медицинских и других чувствительных процессов нужен отдельный контроль результата, а блокировка должна передавать задачу агенту или человеку.
Практический план выглядит как постепенная компиляция накопленного опыта: сначала агент проходит процесс, затем команда превращает траекторию в параметризованный код, испытывает его на вариантах состояния и оставляет общий агент как запасной путь. Работа поддерживает такую схему для повторяемых настольных процессов, но не доказывает, что она заменит агента в произвольной работе с компьютером.
Источники
Иллюстрация: рисунок из статьи «Neuro-Symbolic Computer Use: Learning Reusable Policies for Reliable and Efficient Execution», Hyewon Suh, Thanh Minh Nguyen, Chih-Lun Lee и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


