
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
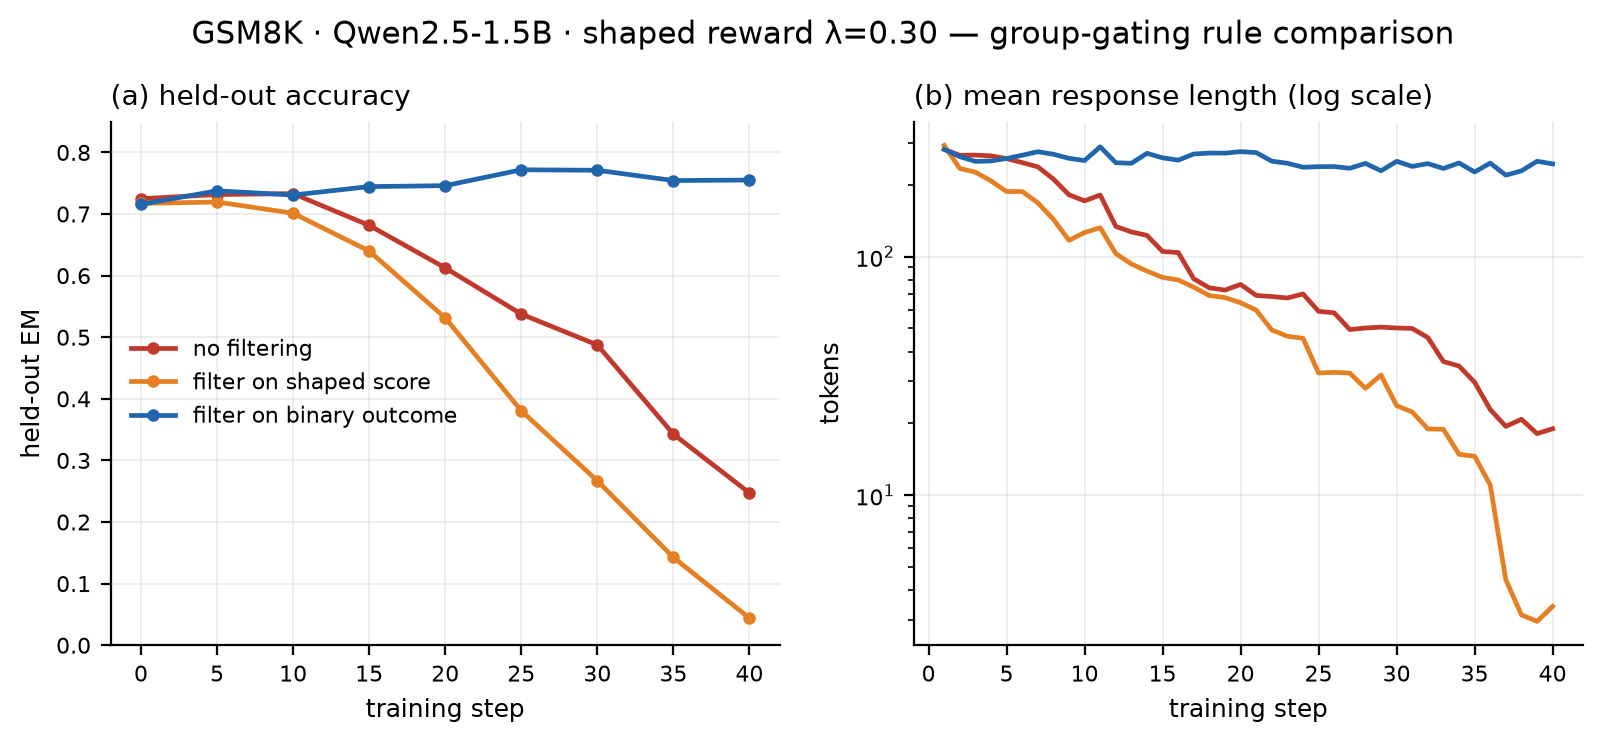
При обучении LLM с составной наградой фильтр может пропускать группы, где все ответы неверны, и направлять модель к ещё худшим ответам. Хотя работа не рецензирована и числа получил сам автор, в основном опыте фильтрация по составной оценке дала 4% точности против 75,4% при фильтрации по исходу задачи. Значит, выбор поля для фильтра — не техническая мелочь, а настройка, которая может определить результат всего обучения.
При GRPO модель генерирует несколько ответов на один вопрос, после чего алгоритм сравнивает их внутри группы. В опыте правильный ответ получал основную награду, а дополнительный компонент поощрял короткий текст. Если все ответы были неверны, короткие ошибки всё равно оценивались выше длинных.
Фильтр по составной оценке видел различия и сохранял такую группу, хотя полезного сигнала в ней не было. Затем деление на стандартное отклонение растягивало небольшую разницу между ошибками до полноценного преимущества: модель училась не решать задачу, а быстрее прекращать ответ. Фильтр по бинарному исходу удалял группу, потому что распознавал главное — все варианты неверны.
В отдельном опыте на штатном тренере DAPO изменили только метрику фильтра. При составной оценке тренер ни разу за 40 шагов не дополнял пакет новыми генерациями, а при точности делал это на 29 шагах: неверные группы перестали незаметно занимать обучающий пакет.
Основное сравнение провели на Qwen2.5-1.5B с LoRA и GSM8K в четырёх запусках, причём только один получил явно другое начальное значение случайности. Одиночные проверки на MATH, модели Qwen2.5-7B и GSPO воспроизвели провал, но дают лишь границы применимости, а не универсальную оценку метода.
DAPO по умолчанию фильтрует по точности, поэтому работа не описывает дефект самого алгоритма. Риск возникает, когда команда меняет метрику на составную награду: фильтр должен опираться на результат задачи, который не зависит от штрафов за длину, формат или другие вспомогательные свойства.
Источники
Иллюстрация: рисунок из статьи «The Filter Metric is Safety-Critical: Phantom Advantages in Group-Relative RL under Shaped Rewards», Juntao Yu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


