
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Награда в памяти LLM-агента почти не влияет на то, чему он учится между попытками. В нерецензированном препринте KAIST, где все числа получили сами авторы, только 3,9% из 360 пар «задача — модель» оказались чувствительны к правильной награде. Поэтому память из сырых попыток и оценок стоит проектировать скорее как набор примеров, чем как замену обучению с подкреплением.
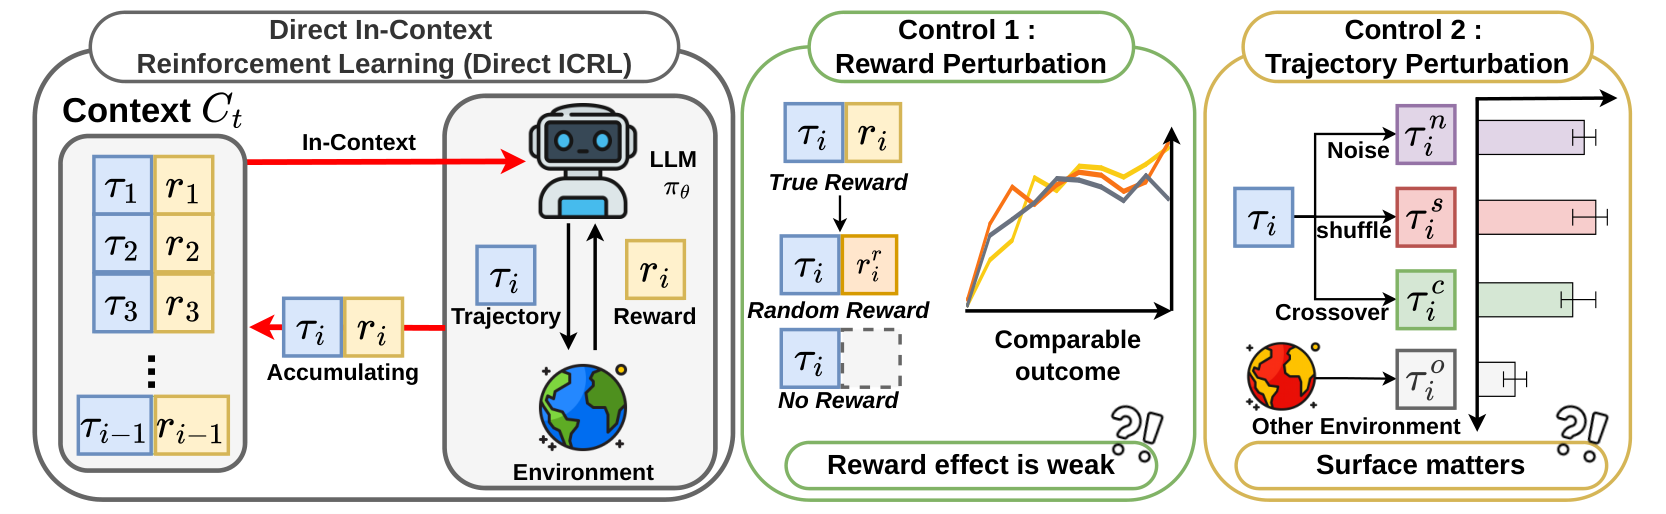
Команда изучила прямое обучение с подкреплением в контексте, или ICRL: модель не обновляет параметры, а получает предыдущие последовательности действий и состояний вместе с числовой оценкой. Исследователи оставляли попытки неизменными, но переворачивали оценки, заменяли их случайными или полностью убирали. Кривые улучшения почти не менялись, в том числе после прямых инструкций учитывать награду.
Главным сигналом оказалась сама попытка. Когда модель видела её в памяти, она чаще воспроизводила похожий ответ; влияние награды на вероятность повторения составляло около 14% от влияния траектории. Даже просьба избегать неудачного действия слабо подавляла повтор, поэтому накопление ошибок само по себе не заставляет агента искать другой путь.
Смысл и правильный порядок действий тоже оказались не обязательны. Перемешанные шаги в ScienceWorld и испорченный код, который не компилируется, помогали примерно так же, как настоящая история попыток. Однако примеры должны относиться к целевой задаче и выглядеть как реальные попытки её решить: траектории из других задач и случайные допустимые действия ухудшали результат.
Работу проверяли на шести открытых и закрытых моделях, двух наборах задач по программированию HumanEval+ и MBPP+ и текстовой среде ScienceWorld. Вывод относится к прямому ICRL с сырыми траекториями: методы, которые сначала превращают опыт в выводы, правила или рефлексию, в эти границы не входят. Для продукта это разделяет два подхода: хранить релевантные демонстрации или отдельно извлекать из опыта инструкции, а не рассчитывать, что поле с оценкой само изменит поведение агента.
Источники
Иллюстрация: рисунок из статьи «Do LLMs Learn from Rewards in Context? : Rethinking the role of reward in In-Context Reinforcement Learning», Minchan Kwon, Seunghee Koh, Sunghyun Baek и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


