
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
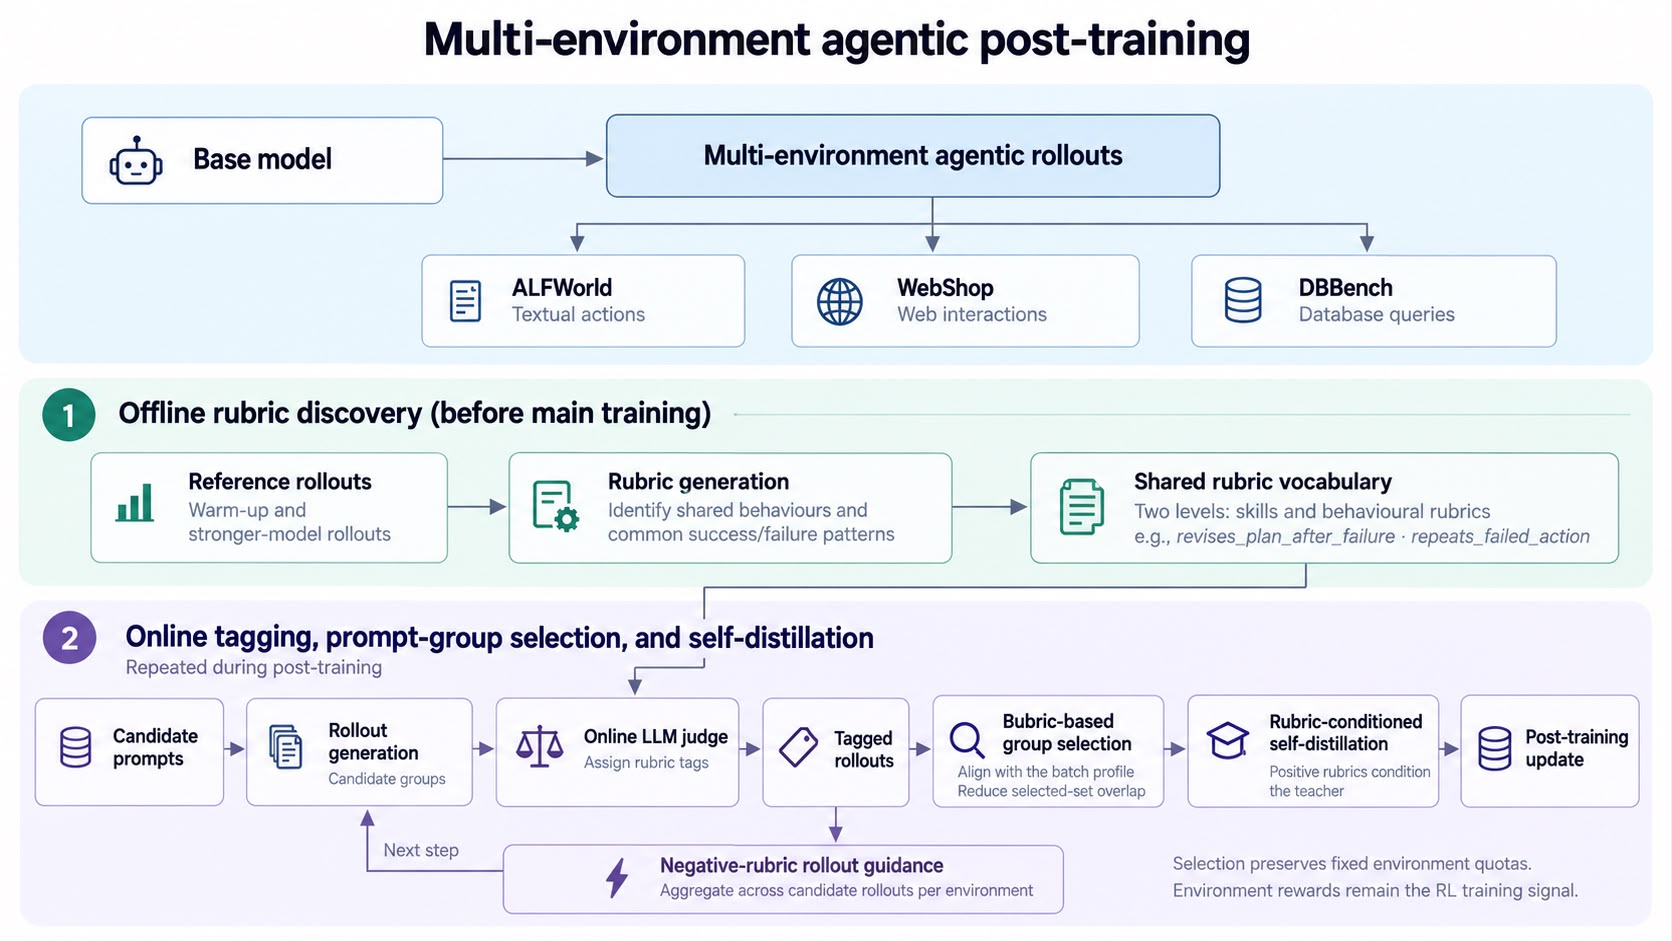
Один LLM-агент научился лучше работать сразу в нескольких интерактивных средах, когда обучение стало учитывать не только итоговую награду, но и конкретное поведение. В препринте, который не проходил рецензирование и содержит замеры самих авторов, RISED показал лучший средний процент выполненных задач на двух базовых моделях и занял первое или второе место в каждой среде. Рубрикатор здесь становится не отдельным оценщиком, а общим слоем для отбора данных и самообучения.
Одинаковая награда скрывает разные ошибки
В обучении через GRPO агент генерирует несколько вариантов решения одного задания, получает награду за каждый и учится на разнице между ними. Если все варианты провалились или все оказались успешными, награды совпадают. Алгоритм больше не видит, какое поведение стоит усилить, а какое убрать.
При совместном обучении в нескольких средах такие группы встречаются часто: простую среду агент уже освоил, а в сложной ещё не получает награду. В экспериментах RISED одинаковую награду имели 62,9% кандидатных групп. Отбрасывать их значит терять большую часть уже сгенерированных взаимодействий.
Скалярная награда также плохо показывает связь между средами. Два агента могут одинаково провалить задачу, но один выбрал неверный инструмент, а второй повторил действие и преждевременно объявил работу завершённой. Для переноса навыка важна именно структура поведения, а не только ноль в конце траектории.
RISED описывает каждую траекторию рубриками — короткими метками желательного или нежелательного поведения. В основной конфигурации общий словарь содержал 59 рубрик, объединённых в 10 навыков. Он включал как общие признаки вроде корректного применения инструментов, так и действия, характерные для отдельных сред.
Один словарь управляет отбором и самообучением
Словарь собирают до основного обучения. Gemini-2.5-Pro выделяет и объединяет поведение из ранних траекторий агента, а успешные решения Claude-Opus-4.6 добавляют положительные примеры, которых мало среди начальных попыток. Рубрикам не нужно исчерпывающе описывать идеальное решение: для отбора достаточно последовательно различать заметные типы поведения.
Во время обучения Qwen3-32B размечает каждую завершённую траекторию. Модель-оценщик указывает навык, рубрику, роль поведения — желательное или нежелательное — и число повторений. Так траектории из WebShop, DBBench и ALFWorld получают сопоставимые профили, хотя сами задачи различаются.
На каждом шаге RISED генерирует вдвое больше групп, чем войдёт в обновление модели. Для каждой группы он суммирует рубрики её траекторий, а затем выбирает половину кандидатов. Высокую оценку получает группа, которая похожа на общий профиль текущего пакета, но не повторяет уже выбранные группы.
Отбор идёт по очереди между средами, поэтому одна среда не может вытеснить остальные. При этом выбор в одной среде меняет оценку кандидатов в следующей: система предпочитает дополняющее поведение, а не ещё один почти одинаковый пример. Итоговую пропорцию сред сохраняют фиксированные квоты.
Те же метки дают второй обучающий сигнал. Положительные рубрики передают учителю самообучения как дополнительный контекст, после чего ученик перенимает распределение следующего токена. Это позволяет учиться даже на группе с одинаковыми наградами. Отрицательные рубрики используют при следующих генерациях, чтобы агент не повторял уже обнаруженные способы провала.
Менять стоит конвейер данных, а не алгоритм целиком
Сходство профилей лучше предсказывало перенос между средами, чем сходство градиентов. Для всех сред ранговая корреляция с улучшением награды составила 0,81 против 0,28. Профиль из положительных и отрицательных рубрик определил наиболее улучшившуюся среду на всех 19 проверках, тогда как градиентный сигнал сделал это на восьми.
Основные опыты прошли на двух базовых моделях и трёх средах: WebShop проверял покупки, DBBench — работу с базой данных, ALFWorld — действия с бытовыми объектами. В отдельном стресс-тесте добавили AppWorld. Удаление либо отбора, либо самообучения ухудшало общий результат, хотя вклад компонентов зависел от среды.
Для команды, которая уже совместно обучает агента на нескольких типах задач, работа предлагает локальное изменение архитектуры. Не требуется заменять GRPO: поверх него появляется общий словарь поведения, асинхронная разметка траекторий, отбор групп по покрытию и дополнительная потеря самообучения.
Цена такого изменения — отдельные вычисления модели-оценщика и учителя. Авторы запускали разметку параллельно генерации, но для неё использовали выделенный сервер с восемью GPU; лучшим в их сравнении оказался оценщик на 32 млрд параметров, хотя вариант на 14 млрд оставался конкурентоспособным. Поэтому RISED меняет планы прежде всего там, где потеря сигнала на одинаковых наградах уже дороже дополнительной разметки.
Практический вывод шире конкретной формулы отбора: если среды разделяют инструменты, форматы действий или типовые ошибки, полезно хранить эти признаки в едином словаре. Тогда одна и та же разметка помогает решать три задачи — выбирать данные, обучать на неразличимых наградах и видеть, какое поведение действительно меняется.
Источники
Иллюстрация: рисунок из статьи «RISED: RubrIcs for agentic multi-environment Selection and sElf-Distillation», Jingtan Wang, Sirajul Salekin, Young mok Jung и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


