
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Оптимальная доля RL в многостадийном обучении не растёт вместе с общим вычислительным бюджетом: в некоторых режимах её выгоднее сокращать. Работа University College London связывает этот эффект с качеством предобучения и разметки, хотя препринт не рецензирован и все числа получили сами авторы. Во всём рассмотренном диапазоне бюджета цепочка из предобучения, SFT и RL давала меньшую ошибку, чем варианты без одной из стадий.
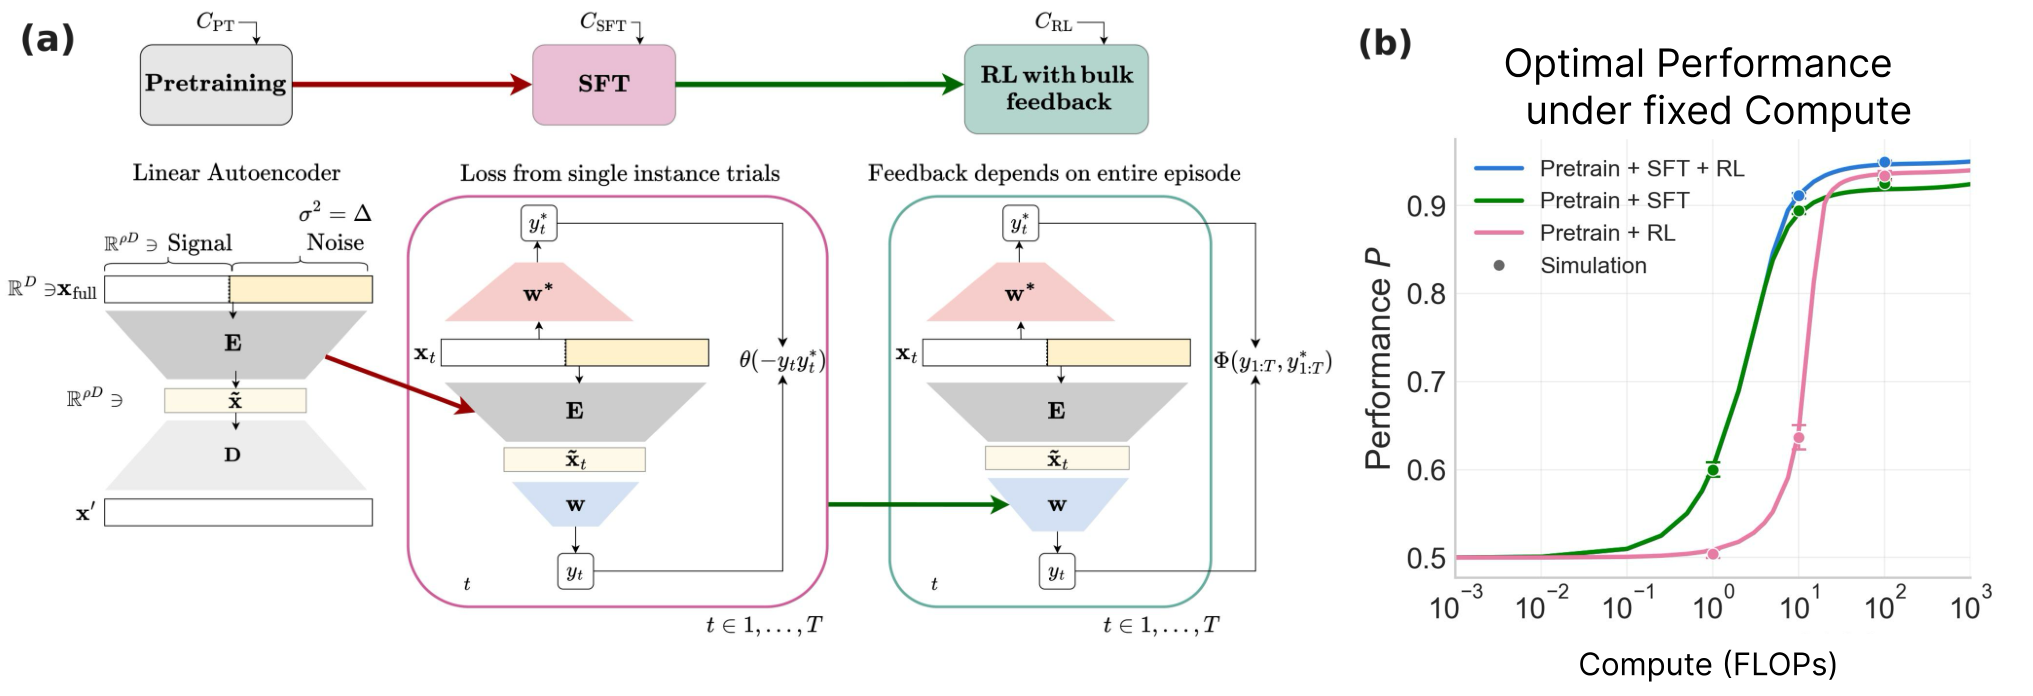
Авторы построили аналитическую модель из трёх этапов. Линейный автокодировщик сначала извлекает признаки из неразмеченных данных, затем модель проходит контролируемое дообучение (SFT) с пошаговыми метками и RL с наградой только за полностью правильную последовательность. Получившиеся уравнения позволяют подобрать бюджет каждой стадии без полного перебора дорогостоящих запусков.
При небольшом общем бюджете SFT выигрывает у RL: пошаговые метки сразу направляют обучение, тогда как редкая награда создаёт начальное плато. При большем бюджете RL обгоняет SFT, поскольку не наследует ошибки шумной разметки. Но короткий разогрев через SFT всё равно помогает RL быстрее пройти плато и улучшает итоговый результат, поэтому совместная схема сохраняет преимущество.
Большая часть оптимального бюджета достаётся предобучению, но остаток нельзя делить по постоянной формуле. Чем больше шума в метках, тем выгоднее смещать вычисления от SFT к RL. При фиксированном качестве предобучения оптимальная доля RL, напротив, может уменьшаться по мере роста бюджета на последующие стадии. Конечный результат также ограничивает представление: ошибка убывает обратно пропорционально квадратному корню из объёма данных предобучения.
Основные выводы получили на упрощённой однослойной модели с замороженными признаками, независимыми наблюдениями и эпизодами по 6 шагов; в показанных симуляциях использовали размерность 1000. На OLMo-2 1B и GSM8K отдельно проверили только один эффект: SFT сокращает начальное плато RL. Поэтому модель задаёт направление для экспериментов с бюджетом, но не готовую пропорцию для обучения LLM.
Источники
Иллюстрация: рисунок из статьи «An Analytical Model of Compute-limited Multistage Training Pipelines», Nishil Patel, Jin Hwa Lee, Basile Confavreux и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


