
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили точнее распознавать эмоции, намерения и предпочтения без размеченных ответов в обучающих данных. Работа пока не рецензирована, а числа получили сами авторы; RLCE обошёл все проверенные способы строить награду без разметки на каждом из выбранных тестов. Подход предлагает альтернативу согласию большинства и общим критериям там, где одно поведение допускает несколько правдоподобных трактовок.
Как сравнение ответов превращается в награду
В математике ответ можно проверить вычислением, а код — запустить. Для сарказма, намерения или личного предпочтения такого проверяющего механизма нет. Фраза «Nice job» может означать похвалу или насмешку, причём улыбка сама по себе не всегда различает эти варианты.
RLCE начинает с нескольких ответов обучаемой модели на один пример. Одинаковые по смыслу варианты объединяются, после чего система попарно сравнивает оставшиеся трактовки. Для каждой пары она формулирует проверяемые утверждения о наблюдаемом поведении: например, соответствует ли интонация положительным словам или противоречит им.
Затем замороженная исходная модель проверяет эти утверждения по тексту и кадрам. Она может подтвердить свидетельство, отклонить его или воздержаться, если входных данных недостаточно. Для каждого ответа метод складывает подтверждения в его пользу и вычитает подтверждения в пользу конкурирующих вариантов.
Ответ с лучшим итогом получает положительную награду, остальные — нет. На этом сигнале модель обновляют через GRPO, алгоритм обучения с подкреплением, который сравнивает результаты внутри одной группы ответов.
Частота ответа на награду не влияет: повторяющиеся варианты сначала объединяются. Это отличает RLCE от выбора большинством, при котором модель может закрепить ошибку просто потому, что воспроизвела её чаще.
После обновления обучаемая модель начинает отвечать иначе, поэтому RLCE заново строит проверки под новые варианты. При этом модель, которая формулирует и проверяет свидетельства, остаётся замороженной. Так меняются сами вопросы к данным, но не проверяющий механизм.
Сравнительные проверки лучше отделили верные ответы
Метод проверяли на MOSEI, UR-FUNNY, IntentQA и PrefEval. Эти наборы охватывают эмоции, юмор и прагматику, коммуникативные намерения и пользовательские предпочтения. Все способы обучения стартовали с Qwen3.5-9B; для итоговой проверки использовали стандартную метрику каждого набора, а эталонные ответы не участвовали в построении награды.
По сравнению с сильнейшим конкурентом RLCE прибавил 3,58 пункта на MOSEI, 4,50 на UR-FUNNY, 1,15 на IntentQA и 18,93 на PrefEval. Сравнивать величину прироста между наборами напрямую нельзя: их метрики и задачи различаются. Содержательный результат в том, что один метод оказался первым во всех выбранных условиях, тогда как отдельные альтернативы улучшали одни задачи и ухудшали другие.
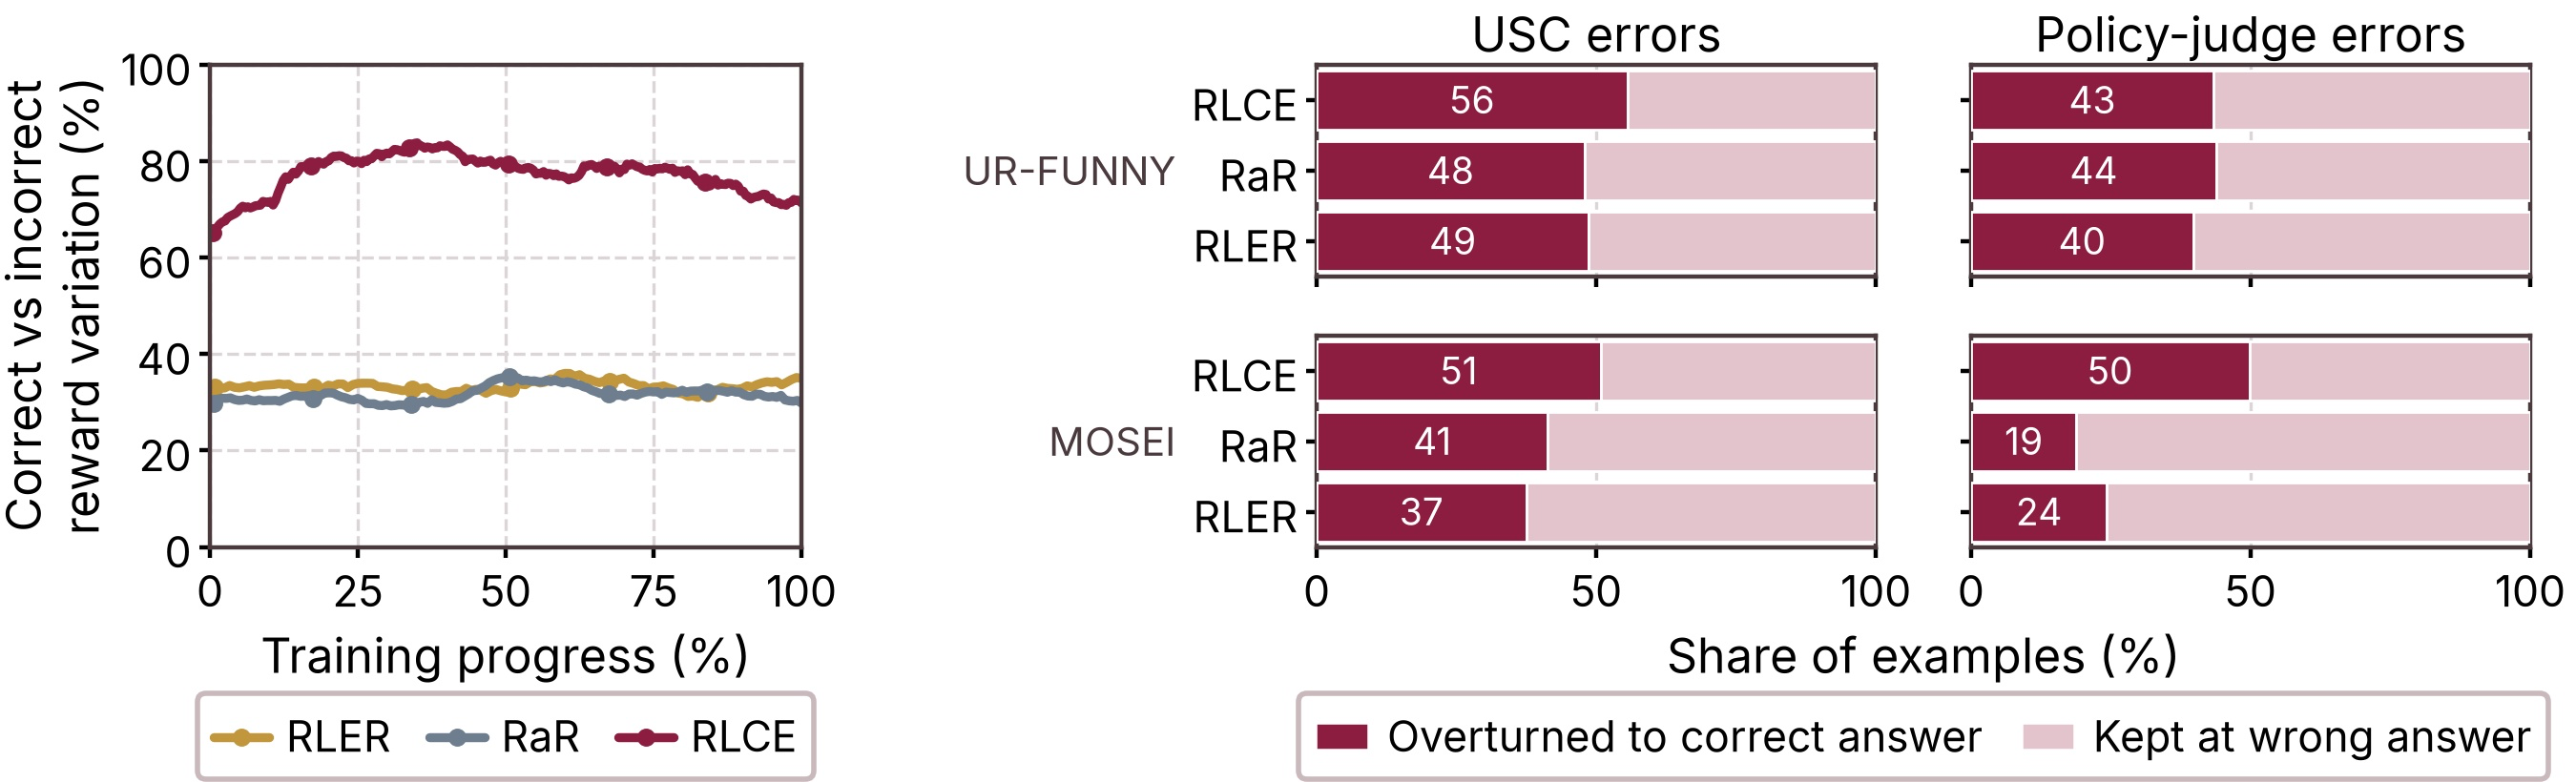
Разбор компонентов показал, откуда берётся разница. Попарные проверки работали лучше независимой оценки каждого ответа, объединение нескольких свидетельств давало более точный вердикт, а обновляемые проверки помогали сильнее фиксированных на задачах со свободной формой ответа. RLCE также чаще отменял ошибочный выбор, который делали голосование большинства или сама обучаемая модель.
Когда подход меняет план обучения
RLCE стоит учитывать, если продукт должен извлекать скрытый смысл из диалогов, отзывов, видео или истории предпочтений, а разметка дорога и неоднозначна. Вместо попытки заранее составить универсальную шкалу качества команда может заставить модель различать конкретные конкурирующие трактовки по наблюдаемым признакам.
Это не отменяет эталонную выборку для приёмки продукта. В работе разметку исключили из награды при обучении, но качество всё равно измеряли по размеченным тестовым данным. Практический план поэтому разделяется: неразмеченный массив можно использовать для обучения, а небольшой контролируемый набор — для сравнения версий и проверки деградаций.
Метод также добавляет вычислительную работу. Проверки строятся для пар разных ответов, затем каждую из них нужно сопоставить с исходным примером. Чем больше разных вариантов выдаёт модель, тем больше таких пар, поэтому перед внедрением придётся сопоставить прирост качества с задержкой и стоимостью генераций; фактическую стоимость обучения работа не приводит.
Границы эксперимента проходят по одной базовой модели и выбранным задачам социального понимания. Авторы также не разбивали качество по демографическим подгруппам, хотя считают такую проверку необходимой перед применением. Результат пока поддерживает пилот на собственных данных, но не заменяет оценку ошибок в конкретном продукте.
Источники
Иллюстрация: рисунок из статьи «Reinforcement Learning with Comparative Evidence for Social Intelligence», Keane Ong, Yuriel Ryan, Sabri Boughorbel и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


