
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
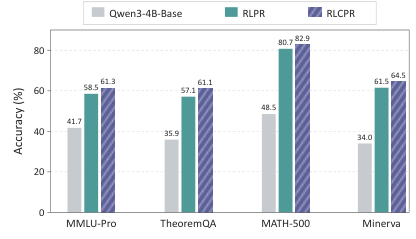
У длинных цепочек рассуждения вероятность правильного ответа перестаёт показывать, какая цепочка лучше, поэтому обучение LLM получает почти одинаковые награды за разные решения. В нерецензированном препринте, где все числа получили сами авторы, метод RLCPR обошёл ближайший аналог на большинстве проверок, местами — на 4 процентных пункта. Для команд, которые обучают модели без внешней проверки ответа, это переносит контроль длины рассуждения из области экономии в саму схему обучения.
Почему длинная цепочка перестаёт быть полезным сигналом
Обучение с подкреплением без проверяющей модели использует уверенность самой LLM. Модель строит цепочку рассуждения, после чего метод измеряет вероятность эталонного ответа. Чем она выше, тем большую награду получает цепочка.
Такая награда подходит задачам, где ответ нельзя дёшево проверить правилом или отдельной моделью. Но она должна различать хорошие и плохие варианты внутри одной группы: групповая относительная оптимизация (GRPO) обновляет модель по разнице между их наградами.
На длинных цепочках эта разница сжимается. После подробного рассуждения модель оценивает не столько правильность ответа, сколько его согласованность с уже написанным текстом. Ошибочная цепочка тоже может последовательно подвести к неверному выводу и заставить модель уверенно его поддержать.
Работа называет это концентрацией апостериорной награды. На MMLU-Pro и GPQA-Diamond цепочки разделили по длине и сравнили награды для правильных и неправильных ответов. С ростом длины оценки сближались, а разброс наград между вариантами одного вопроса уменьшался.
Это не означает, что модель становится менее уверенной. Награда теряет способность различать качество рассуждений. Для GRPO результат одинаков: если варианты получают близкие оценки, алгоритм не понимает, какой из них следует усиливать.
Теоретическая часть связывает эффект с концентрацией вероятностей длинных последовательностей. При условии, что средняя неопределённость следующего токена со временем не растёт, вероятность эталонного ответа всё меньше зависит от конкретного пути рассуждения. При этом локальные скачки неопределённости возможны: речь идёт о тенденции на длинном диапазоне, а не о строгом правиле для каждой цепочки.
Как RLCPR сохраняет различия между наградами
RLCPR не заменяет вероятностную награду. Он старается реже генерировать группы, в которых она почти наверняка сольётся в одно значение, а затем сокращает уже возникшие длинные цепочки.
Первый компонент оценивает неопределённость прямого ответа до генерации развёрнутых рассуждений. Вопросы с высокой неопределённостью чаще приводили к концентрации наград, поэтому метод снижает вероятность их выбора. Оценку периодически пересчитывают по текущей версии модели: это не постоянный фильтр сложности, а меняющееся распределение обучающих примеров.
Второй компонент работает после генерации. Если все цепочки в группе длинные и получили близкие вероятностные награды, RLCPR добавляет штраф за длину. Порог длины и допустимую разницу наград он вычисляет по текущему пакету данных, поэтому они подстраиваются под модель и этап обучения.
Штраф включают не сразу. В начале модель ещё учится строить полезные рассуждения, и раннее давление на длину мешает освоить задачу. Позже регуляризация останавливает дрейф к многословным цепочкам, которые расходуют токены, но уже не дают различимого сигнала.
Метод проверили на Qwen3-4B-Base. Модель обучали на 77 тысячах нематематических вопросов, а оценивали на MMLU-Pro, GPQA-Diamond, TheoremQA, WebInstruct, MATH-500, Minerva и AIME24. Основным сравнением служил RLPR на той же базовой модели; бюджет выходных токенов сделали сопоставимым.
Менять стоит схему эксперимента, а не весь стек
RLCPR превзошёл RLPR на большинстве наборов и добавил 1,8 процентного пункта к средней точности. К 320-му шагу он использовал 0,75 миллиарда выходных токенов против 1,99 миллиарда у RLPR, сохранив более высокую точность. На GPQA-Diamond результат, напротив, снизился на 2,7 пункта.
Последний результат показывает цену фильтрации. Задачи, которым действительно нужны длинные рассуждения, могут выглядеть как будущий случай концентрации и реже попадать в обучение. В отдельных проверках отбор по неопределённости сам по себе ухудшал математические результаты; выигрыш появлялся, когда его сочетали со штрафом за длину.
Работа меняет планы команд, которые уже используют вероятностные награды и сравнивают несколько ответов на один запрос. В такой системе стоит отдельно отслеживать связь длины с разбросом наград и долю групп, которые отбрасываются после дорогой генерации. Если разброс падает вместе с ростом цепочек, простая генерация дополнительных вариантов увеличит расходы, но не вернёт полезный сигнал.
Переносить RLCPR целиком до собственного эксперимента рано: проверка охватывает одну базовую модель и конкретный набор общих и математических задач. Практический первый шаг — воспроизвести диагностику концентрации на своих данных, затем сравнить предварительный отбор примеров и выборочный штраф за длину с текущей схемой фильтрации.
Источники
Иллюстрация: рисунок из статьи «Rethinking Probability-Based Reinforcement Learning From Posterior Concentration», Shiu-Hong Kao, Yubo Zhao, Zhenyu Tian и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


