
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языкового агента можно обучать выбирать исполнимое действие напрямую, не заставляя его сначала писать ответ и затем разбирать этот текст. В нерецензированном препринте, где все числа получили сами авторы, полный маршрут RLiD достиг на ALFWorld 99,3% успешных попыток за 12,7 H100 GPU-часа против 86,6% за 17,3 GPU-часа у обучения на уровне токенов. Для продукта это предлагает отдельный контур обучения решений, результат которого затем можно перенести в обычную генеративную LLM.
Почему текст добавляет шум в обучение агента
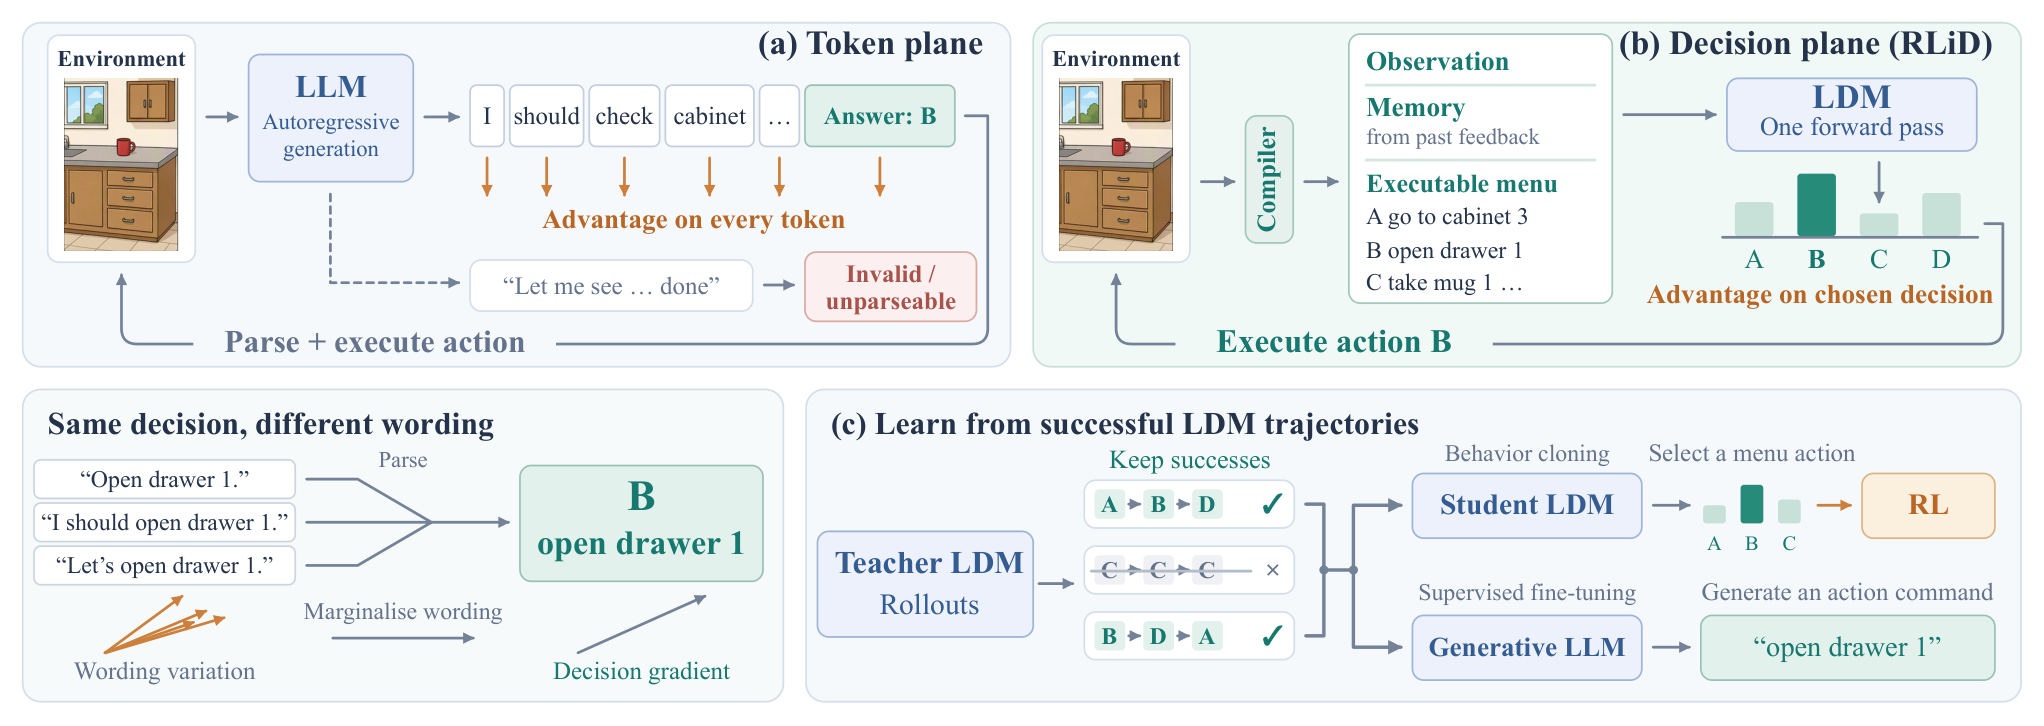
При обычном обучении с подкреплением агент генерирует рассуждение и команду, после чего среда извлекает из текста действие. Награда относится к выполненному действию, но обновление получает вся последовательность: рассуждение, форматирование и даже фрагменты, которые не удалось разобрать.
Одна и та же команда может быть записана несколькими способами. Среда выполнит одинаковое действие, однако каждый вариант даст свою оценку градиента — направления, в котором нужно менять параметры модели. Эта разница не меняет ожидаемое обновление, но увеличивает его разброс и требует больше траекторий взаимодействия.
RLiD переносит обучение на уровень решений. Обычный код собирает наблюдение, краткую память о предыдущих шагах и конечное меню допустимых действий. Модель читает всё за один проход и выдаёт распределение вероятностей по меткам меню, поэтому ей не нужно генерировать команду и проходить через анализатор текста.
Математический результат работы относится к одной и той же текстовой стратегии: если награда зависит от ответа только через извлечённое действие, усреднение по разным формулировкам убирает компонент шума с нулевым средним, не меняя ожидаемого обновления. Это не решает другую задачу — определить, какой из предыдущих шагов привёл к итоговой награде. Для неё по-прежнему нужны методы распределения награды по траектории.
Прямой выбор тоже требует настройки. Предобученная модель может предпочитать отдельные буквенные метки независимо от смысла действия, а обучение усиливает этот перекос. Авторы перемешивали пункты меню и добавляли регуляризацию или калибровку, чтобы стратегия не сводилась к постоянному выбору одной буквы.
Где прямой выбор оказался выгоднее генерации
Метод проверяли на ARC, Countdown, Sokoban и ALFWorld; FrozenLake использовали для отдельной проверки шума градиента. Эксперименты охватывают одиночный выбор ответа, арифметическое планирование и последовательные действия в среде. Основой служили модели семейств Qwen2.5 и Qwen3.5, которые дообучали через LoRA.
На ARC модель Qwen2.5-1.5B получила преимущество в 2,6 процентного пункта при примерно десятикратно меньших вычислительных затратах. Но на Qwen3.5-2B генерация короткого рассуждения опередила прямой выбор на 1,8 пункта, хотя потребовала примерно вчетверо больше ресурсов. Рассуждение иногда даёт модели полезное дополнительное вычисление, которое один проход по входу не заменяет.
На Countdown результат зависел не только от способа обучения, но и от интерфейса. Когда меню показывало состояние задачи после каждого возможного арифметического шага, прямой выбор обошёл генерацию ответа и короткого рассуждения. Гибрид, который сначала писал рассуждение, а затем выбирал допустимую метку с той же регуляризацией, уже не отличался статистически значимо — основную часть выигрыша обеспечили структура меню и борьба с перекосом меток.
На Sokoban обе стратегии запускали в одном программном контуре с одинаковыми средой, меню, историей и алгоритмом обновления. RLiD чаще решал задачи и не терял попытки из-за команд, которые нельзя разобрать. ALFWorld дополнительно показал, что обученную стратегию решений можно перенести в генеративную LLM через дообучение на успешных траекториях.
Когда RLiD меняет архитектурный план
Подход подходит агентам, у которых на каждом шаге можно перечислить допустимые действия: команды бизнес-процесса, операции инструмента, переходы по состояниям или варианты ответа. Здесь генерация свободного текста становится промежуточным слоем, хотя среде нужен только идентификатор операции. Его можно убрать из обучающих траекторий и вернуть после обучения, если внешний интерфейс требует текстовых команд.
Компилятор состояния при этом становится частью продукта, а не технической деталью эксперимента. Он решает, что попадёт в наблюдение, как будет выглядеть память и какие варианты увидит модель. Изменение меню или добавление результата каждого действия меняет саму задачу, поэтому такие версии нужно проверять отдельно и сравнивать на одинаковых интерфейсах.
Для открытых действий, которые нельзя заранее собрать в конечное меню, RLiD напрямую не подходит. Он также не доказывает, что рассуждения всегда лишние: на одной из моделей текстовая стратегия дала более точный ответ. Практический критерий — можно ли выразить действие конечным набором и тратит ли команда вычисления на генерацию, которую среда затем всё равно сворачивает до одного выбора.
Рабочая схема состоит из двух моделей. Учитель обучается на уровне решений без генерации и ошибок разбора, затем его успешные траектории дообучают обычную LLM писать команды. На ALFWorld такой студент мог работать без списка допустимых действий, поэтому меню требуется для эффективного обучения, но не обязательно остаётся частью производственного интерфейса.
Приведённые затраты измерены на H100 и зависят от среды, длины траекторий и реализации. Они показывают преимущество внутри описанного контура, но не задают универсальную цену обучения. Перед сменой архитектуры стоит сравнить оба варианта на одном наборе действий, с одинаковой памятью и единым учётом времени генерации, обновления и проверки.
Источники
Иллюстрация: рисунок из статьи «RLiD: Reinforcement Learning in the Decision Plane for Language Agents and LLMs», Ziyi Chen, Yan Zhang, Jianhui Wei и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


