
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
В простых алгоритмических задачах RLVR застревало даже там, где у награды не было плохих локальных максимумов. В препринте Noa Rubin и Zohar Ringel, который не прошёл рецензирование и где числа получили сами авторы, метод Монте-Карло нашёл решение во всех вариантах без общих весов, а обычное обучение часто остановилось раньше. Значит, смена оптимизатора не всегда устраняет причину сбоя: модели может не хватать способности перемещаться между равноценными промежуточными политиками.
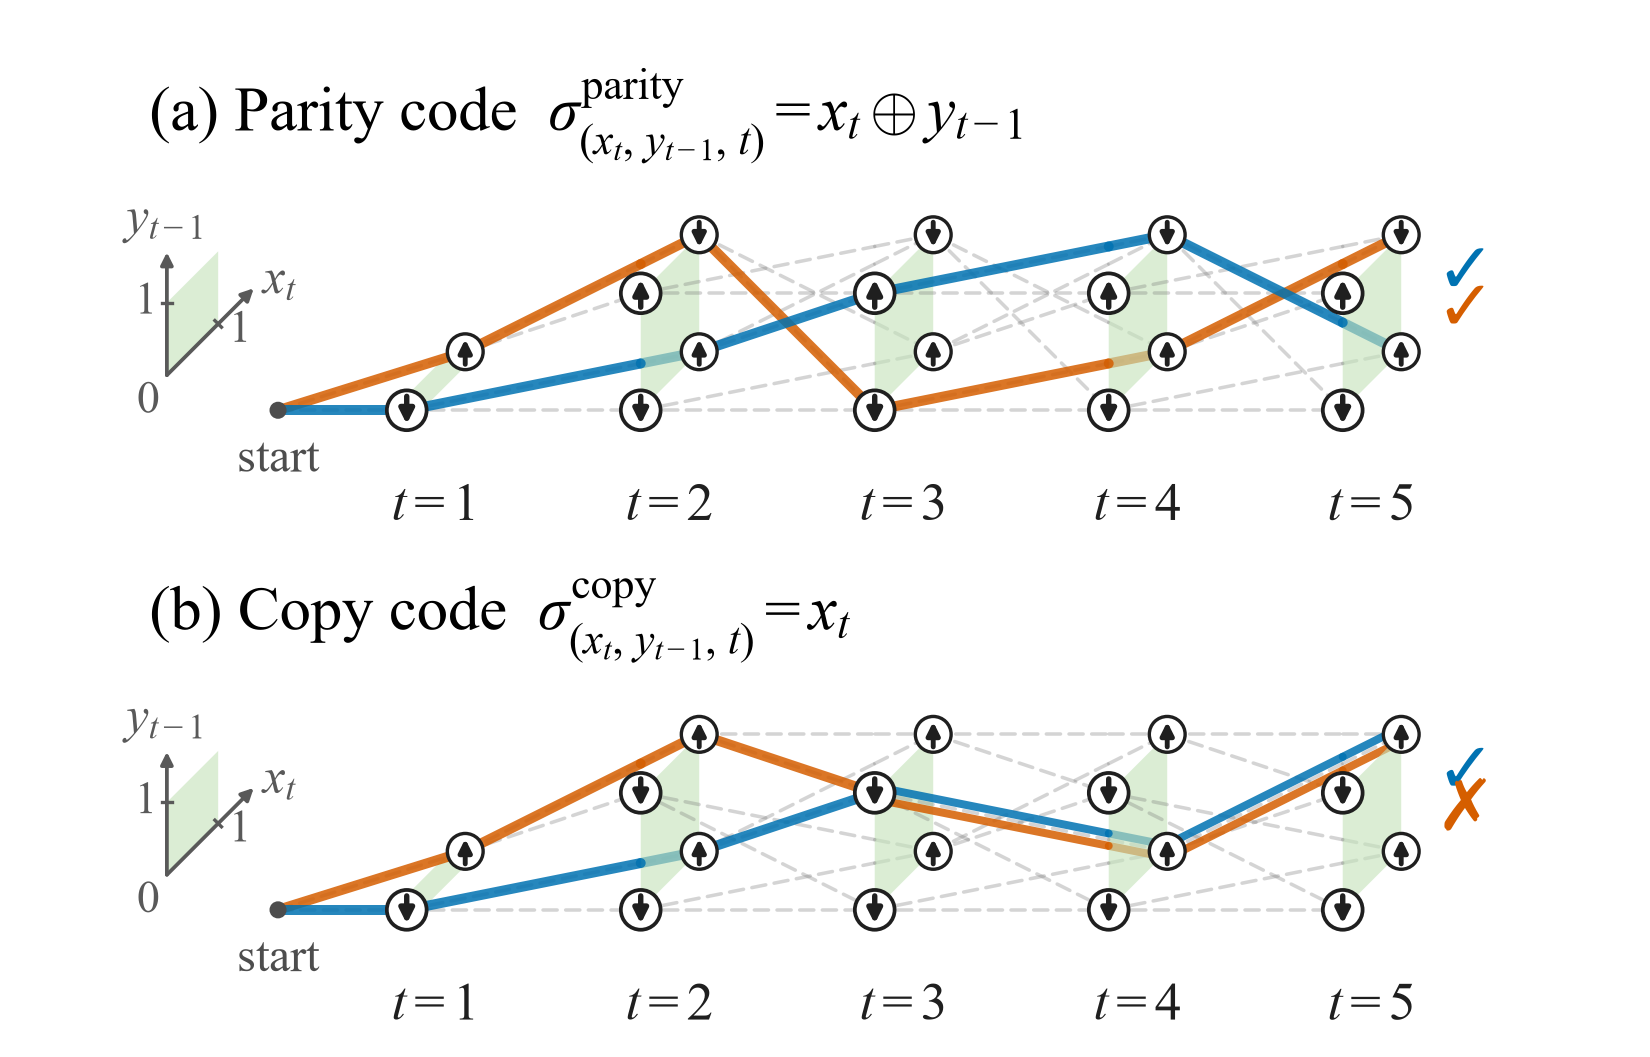
Авторы изучили обучение с подкреплением с проверяемой наградой (RLVR) на последовательном умножении элементов групп и квазигрупп. Модель выдавала промежуточные токены, но получала награду только за правильный последний токен. Политику задали таблицей локальных правил и сопоставили её с физической моделью, где каждая полностью определённая политика становится отдельным состоянием.
Для политик без общих весов и входов без корреляций в ландшафте награды не оказалось неоптимальных локальных максимумов. Однако точные локальные обновления RLVR всё равно могли остановиться: они смешивали действия с одинаковой наградой, тогда как метод Монте-Карло свободно переходил между такими состояниями. При общих весах или коррелированных входах картина менялась — там уже появлялись настоящие ловушки.
Похожий эффект получили на трансформере, который обучали с нуля. Без сильной энтропийной регуляризации все запуски остались на уровне случайного ответа для цепочек длиной 8. При коэффициенте 0,3 точность выше 95% получили пять запусков из восьми на группе ℤ5 и три из восьми на квазигруппе; вместе с регуляризацией использовали обучение по программе с постепенным усложнением примеров.
Работа охватывает искусственные задачи, табличные политики и небольшой трансформер без предварительного обучения. Поэтому сильную регуляризацию нельзя напрямую переносить в обучение готовой LLM: она может разрушить уже освоенное поведение. Практический вывод уже применим к диагностике — остановка награды не доказывает наличие локального максимума; сначала стоит проверить, сохраняет ли политика разнообразие и может ли проходить по участкам с одинаковой наградой.
Источники
Иллюстрация: рисунок из статьи «RLVR landscapes for iterated multiplications can be benign: Insights from spin-glass theory», Noa Rubin, Zohar Ringel, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


