
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
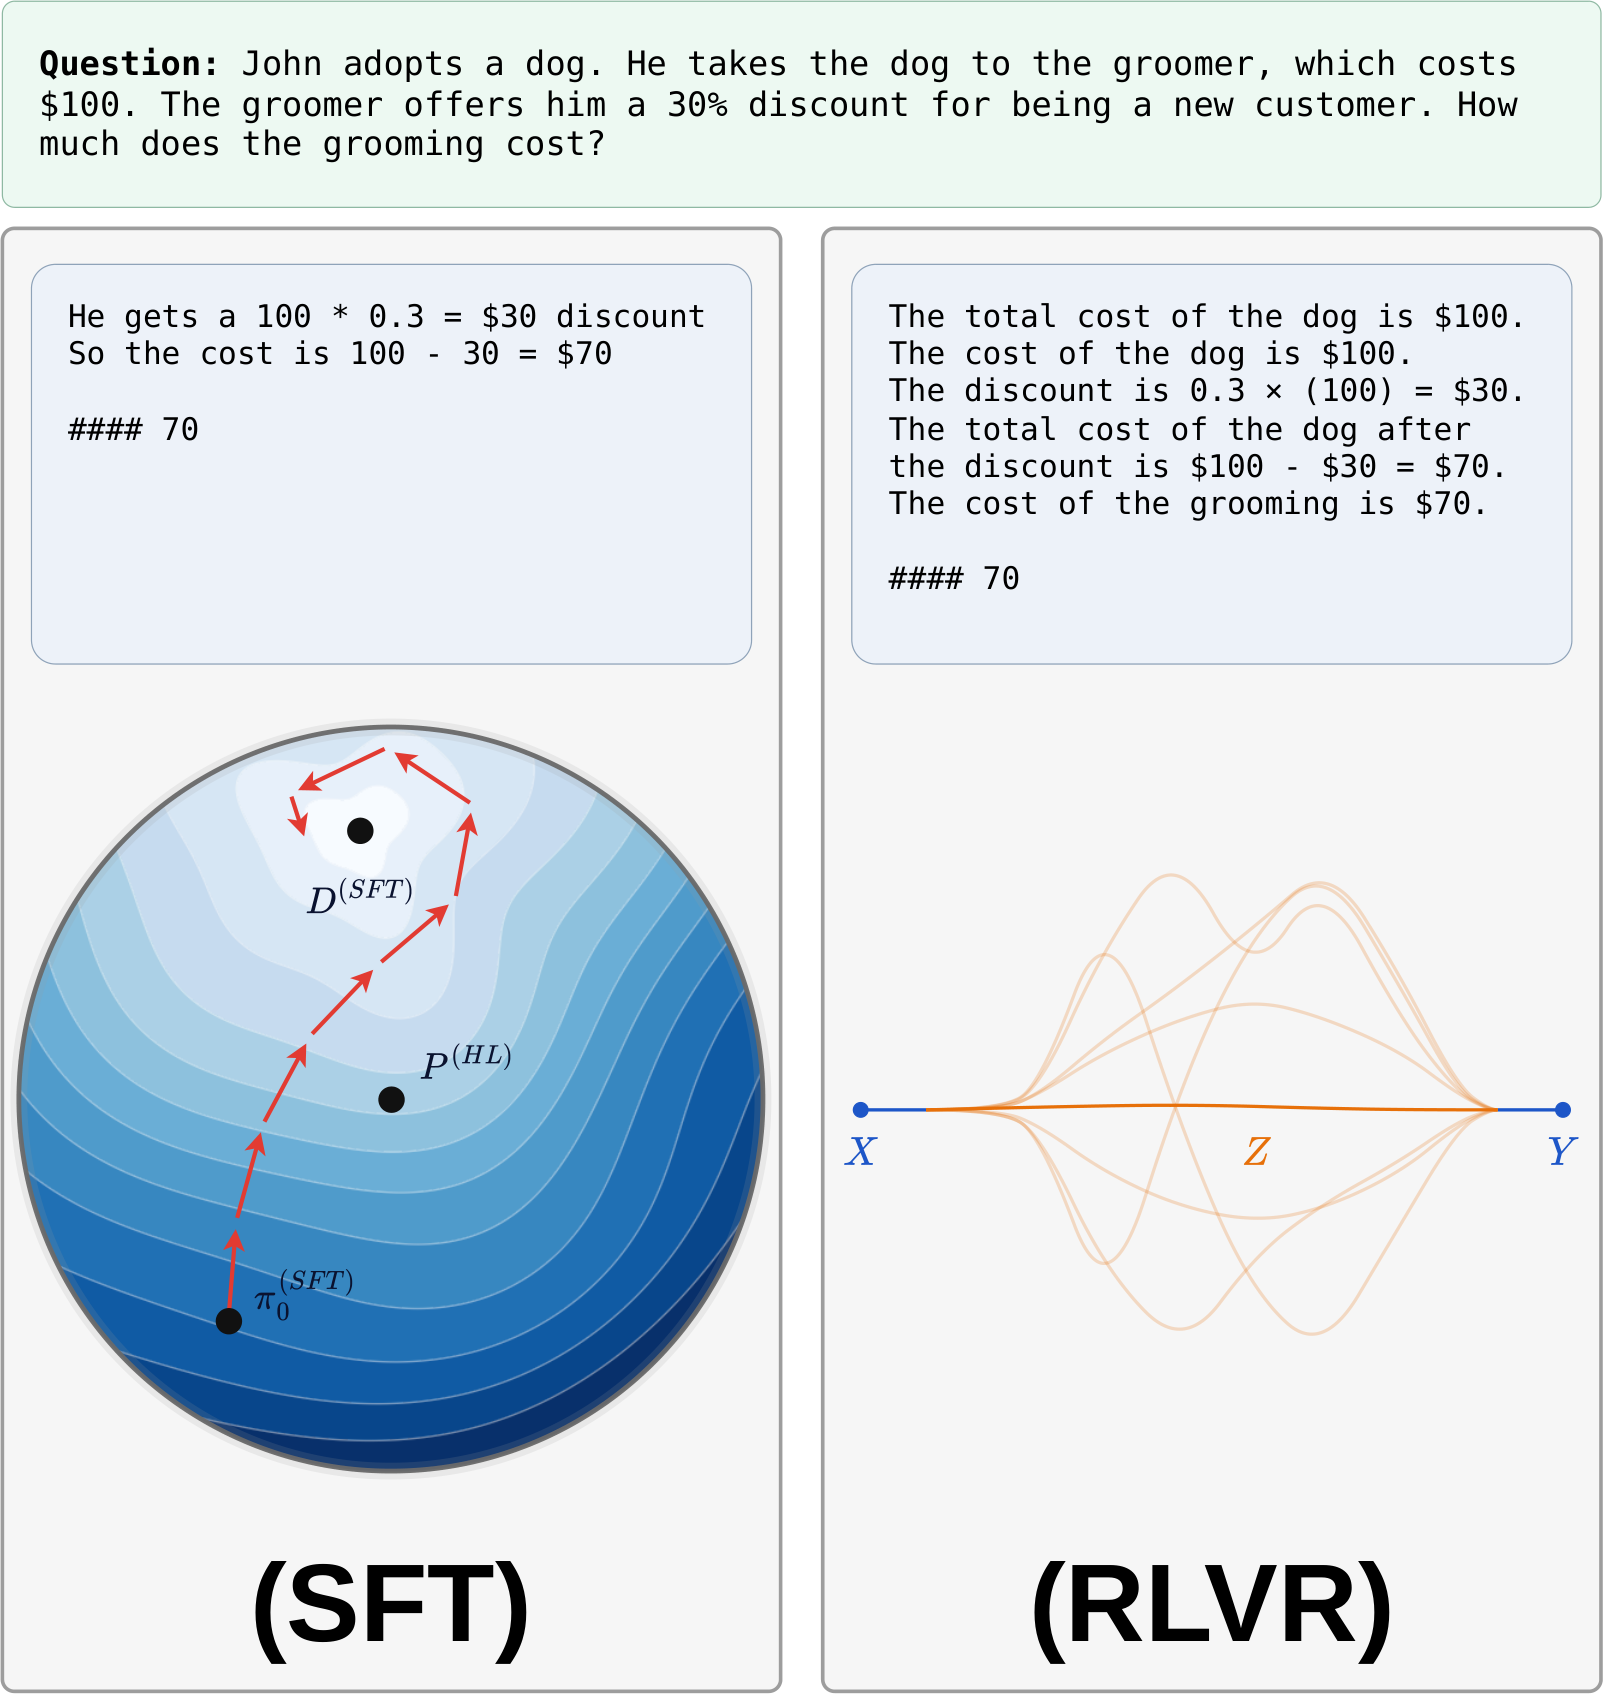
Цепочки рассуждений LLM отходят от понятного человеку языка, когда модель осваивает действительно новую задачу, а не извлекает уже знакомый способ решения. Michael Sullivan и Alexander Koller из Saarland University показали это теоретически и в эксперименте; работа не рецензирована, и числа в ней получены самими авторами. На новых задачах обучение с подкреплением по проверяемой награде (RLVR) вызвало больший дрейф языка, чем обучение с учителем.
RLVR проверяет итоговый ответ, но не оценивает промежуточные рассуждения. Поэтому модель может менять грамматику, вводить собственные значения слов и уходить от человеческого языка, пока правильность ответа растёт. В математической модели такой дрейф при RLVR не имеет верхней границы, тогда как обучение с учителем ограничивает его примерами целевых рассуждений.
Попытка удержать модель около человеческого языка одновременно ограничивает максимальную ожидаемую награду. Этот результат относится к совместному распределению рассуждений и ответов: он не доказывает отдельно, что любое требование писать яснее обязательно ухудшит качество. Но он показывает конфликт между свободой оптимизации и возможностью проверять ход решения по тексту.
В эксперименте сравнили Llama, Gemma и Qwen размером от 1 до 1,5 млрд параметров на задачах GSM8K. Разборчивость измеряли косвенно: другой модели давали всё большую часть цепочки и проверяли, помогает ли она предсказать ответ. После RLVR цепочки Llama и Gemma читались хуже, чем после обучения с учителем, включая контрольные точки с сопоставимым качеством. У Qwen разницы почти не было: около двух третей прироста обеспечило уже знакомое поведение — модель научилась завершать ответ сразу после первого решения.
Отдельные запуски RLVR на одной исходной модели выработали разные языковые привычки и хуже понимали рассуждения друг друга. Проверка охватила текстовые модели малого размера и один математический датасет, а связь между жёстким ограничением дрейфа и потерей награды осталась теоретической. Для систем, которые контролируют агента через его цепочку рассуждений, такой текст нельзя считать стабильным интерфейсом между моделью и проверяющим.
Источники
Иллюстрация: рисунок из статьи «On Language Drift during RLVR Post-Training», Michael Sullivan, Alexander Koller, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


