
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
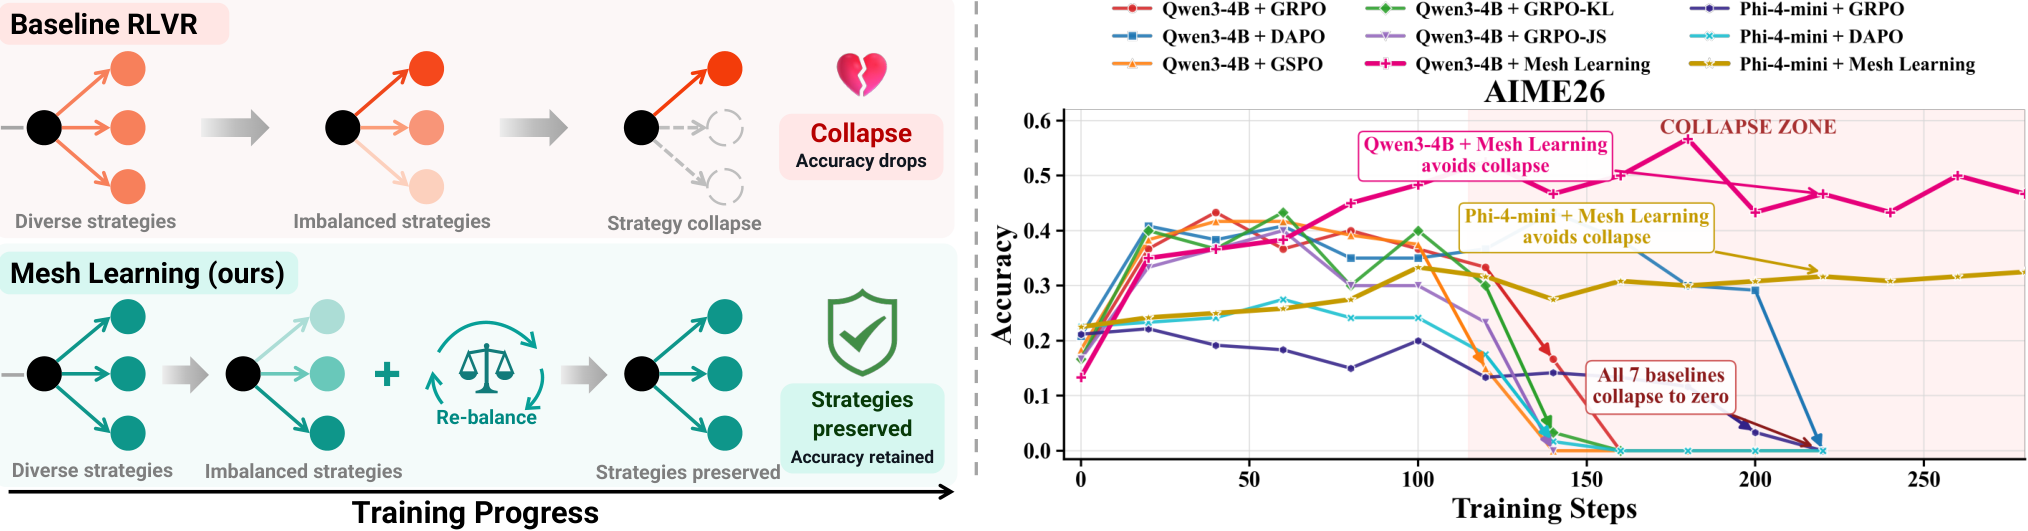
При долгом дообучении с проверяемой наградой языковая модель может постепенно потерять почти все способы решения задачи, а затем резко просесть по точности. Qiyuan Huang, Tianshi Xu и Meng Li предложили индикатор MEI, который замечает этот переход заранее, и метод Mesh Learning, который сохраняет несколько стратегий; в нерецензированном препринте все числа получены самими авторами. На AIME26 метод повысил результат Qwen3-4B на 13,4 процентного пункта.
RLVR усиливает одну стратегию за счёт остальных
Обучение с подкреплением по проверяемой награде (RLVR) вознаграждает ответ, если его можно проверить автоматически. Для математики это совпадение с правильным результатом, для программирования — прохождение тестов. GRPO, DAPO и GSPO обновляют модель по группам сгенерированных решений без отдельной модели-оценщика.
Проблема возникает не тогда, когда модель отбрасывает заведомо плохие рассуждения. При долгом обучении она может сделать недоступными разные рабочие подходы: например, прямое алгебраическое решение и геометрическое преобразование. Награда ещё растёт, но запас способов добраться до ответа уже сокращается.
Стратегией работа называет не текстовое описание метода, а группу траекторий, которые одинаково реагируют на обновление параметров. Если усиление одного решения одновременно повышает вероятность другого, а их реакции на остальные обновления близки, они относятся к одной стратегии. Проверка на MATH-500 показала, что такое формальное деление согласуется с различимыми способами решения.
Теоретический результат объясняет поздний обвал как конфликт двух процессов. Оптимизация GRPO, DAPO и GSPO стягивает вероятность к одной доминирующей стратегии, тогда как для устойчивой точности модели нужен минимальный запас доступных стратегий. Когда запас опускается ниже этого уровня, прежний результат больше не удерживается.
Обычные штрафы за отклонение от исходной модели не решают проблему во всех режимах. Если одна стратегия получает достаточно большое преимущество по награде, даже регуляризация через расхождения KL или JS допускает почти полную концентрацию на ней.
MEI показывает сближение траекторий до обвала
Напрямую строить группы стратегий во время обучения дорого: пришлось бы хранить и сравнивать градиенты по параметрам модели. MEI использует градиенты логарифмов вероятностей по выходам модели, которые можно получить из уже выполненных генераций.
Когда разные траектории всё слабее отличаются по реакции на обновление, MEI растёт. Значение около единицы соответствует слабо связанным траекториям. Порог 1,013 авторы рассчитали на моделях до RLVR как среднее значение плюс три стандартных отклонения.
В экспериментах MEI пересекал этот порог до резкого падения точности у нескольких алгоритмов и вариантов регуляризации. Поэтому метрика подходит не только для разбора уже испорченного запуска: её можно считать во время обучения и использовать как сигнал для остановки, смены данных или вмешательства в оптимизацию.
Mesh Learning меняет сам состав обучающих генераций
Mesh Learning сначала просит отдельную модель-наставника подготовить для каждой задачи несколько коротких префиксов с разными методами решения. Они не содержат вычислений и ответа, создаются один раз и во время обучения направляют отдельные группы генераций. Токены наставника не входят в обучающую потерю, а при использовании готовой модели наставник не нужен.
Одних префиксов оказалось недостаточно: без дополнительного ограничения оптимизация всё равно выбирала один метод. Поэтому вторая часть Mesh Learning уравновешивает прогресс правильных траекторий разных стратегий и не позволяет одной из них вытеснить остальные.
На AIME26 Qwen3-4B достигла 56,7%, а преимущество над сильнейшим базовым вариантом составило 13,4 процентного пункта. На Phi максимальный выигрыш достиг 11,5 пункта. В LiveCodeBench Qwen3-4B обошла DAPO на 4,2 пункта, поэтому эффект не ограничился математическими задачами.
Метод проверяли на Qwen2.5-7B-Instruct, Qwen3-4B и Phi-4-mini-reasoning, на соревнованиях по математике, наборе научных вопросов GPQA и задачах по программированию. Сравнение охватило GRPO, DAPO, GSPO и варианты со штрафами KL и JS. На GPQA связь между концентрацией стратегий и обвалом проявлялась иначе: выбор из готовых ответов не соответствует принятому в теории условию о разнообразном пространстве результатов.
Для команд, которые долго дообучают модели на автоматически проверяемых задачах, работа меняет план эксперимента в двух местах. Кривой награды и текущей точности недостаточно: рядом стоит считать MEI, а обучающие генерации следует проектировать так, чтобы они покрывали несколько способов решения. Mesh Learning пока разумнее рассматривать как проверяемую альтернативу для нового запуска, а не как универсальную замену RLVR: результаты относятся к трём моделям и перечисленным классам задач.
Источники
Иллюстрация: рисунок из статьи «All Work And No Play Makes Jack a Dull Boy: Understanding and Preventing Catastrophic Strategy Collapse in RLVR», Qiyuan Huang, Tianshi Xu, Meng Li, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


