
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Длинные рассуждения LLM научились обслуживать быстрее с меньшим KV-кешем — памятью, где модель хранит данные о предыдущих токенах. В нерецензированном препринте, где числа получили сами авторы, RoCoKV ускорил выдачу в vLLM в 1,27 раза и увеличил число обработанных запросов за единицу времени на 38% на AIME25. Метод можно подключить к существующему серверному стеку без переделки самого vLLM.
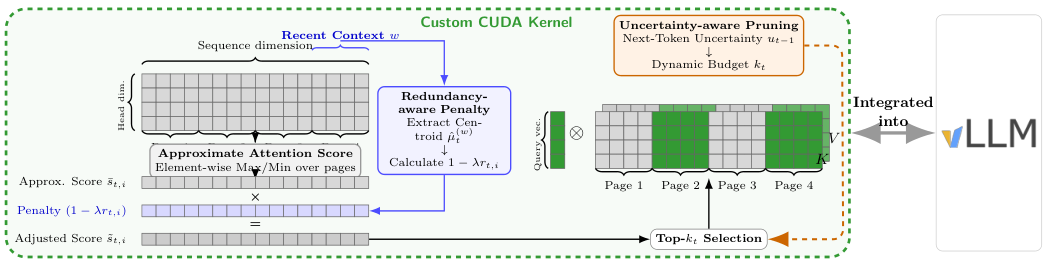
RoCoKV меняет объём сохраняемого контекста по ходу рассуждения. Когда вероятности следующих токенов близки и модель не уверена в продолжении, метод оставляет больше данных; когда один вариант явно преобладает, сжимает кеш сильнее. Отдельный механизм понижает приоритет токенов, похожих на недавний фрагмент рассуждения, чтобы повторы не занимали ограниченный бюджет.
Сам алгоритм не гарантирует ускорения: поиск полезных токенов, удаление записей и управление памятью тоже расходуют ресурсы. Поэтому RoCoKV реализовали как подключаемый модуль для vLLM с объединёнными CUDA-ядрами. Они за один проход оценивают токены, выбирают нужные и рассчитывают точное разреженное внимание, сохраняя страничную организацию KV-кеша, захват CUDA-графа, планировщик и кеширование общих префиксов.
На длинном синтетическом тесте такая реализация ускорила выдачу в 1,43 раза, а пропускную способность повысила на 45% по сравнению с полным KV-кешем. Выигрыш возникает не только из-за меньшего объёма данных: адаптивные бюджеты остаются на GPU, поэтому сервер не синхронизируется с центральным процессором на каждом шаге.
Метод проверяли на DeepSeek-R1-Distill-Llama-8B и DeepSeek-R1-Distill-Qwen-7B, а качество рассуждений — на AIME25, GSM8K и MATH500. При бюджете KV-кеша в 128 токенов RoCoKV обошёл все рассмотренные методы сжатия; системные замеры в vLLM проводили для модели на базе Llama и отдельно дополнили длинной синтетической нагрузкой.
Источники
Иллюстрация: рисунок из статьи «RoCoKV: Accelerating LLM Inference Serving through Uncertainty and Redundancy Aware KV Cache Compression», Payman Behnam, Elaheh Sobhani, Saad Amin и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


